


Agent开发
LLM
TransFormer=同时看所有词+同时计算词与词之间的关系+多层深入理解
Prompt Engineering
不是写提示词,是写“接口协议
为了控制LLM的输出!
重点:
- 结构化输出(JSON)
- Role + Task + Constraint
- 少即是多,因为你用越少的语言传递越多有效的信息,LLM推理结果就会更好
你是一个音乐分析助手输入:一首歌输出:{ "bpm": "", "情绪": "", "风格": "", "结构": ""}OpenAi规范
import osfrom openai import OpenAI
try: client = OpenAI( # 替换成你自己的ak api_key="<your key>", #写进client里和baseurl模型服务器地址 #可以通header传递,key为Authorization Bearer+apikey
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1", )
completion = client.chat.completions.create(
model="qwen-plus", #Array[] messages=[ #系统提示词 {"role": "system", "content": "You are a helpful assistant."}, #用户提示词 {"role": "user", "content": "你是谁?"}, ], ) temperature=0.3, # 降低随机性,提高准确性 #temperature越大越不严谨
#限制 max_tokens=500
#stream流式输出 "stream"=false #流式输出,true流式输出
print(completion.choices[0].message.content)except Exception as e: print(f"错误信息:{e}")| 字段 | 非流式输出 | 流式输出 | 说明 |
|---|---|---|---|
id | id | id | API 请求返回的唯一标识。流式输出中,每个 chunk 的 id 通常相同。 |
choices | choices | choices | 候选结果列表。非流式中每一项通常包含 message;流式中每一项通常包含 delta。 |
| 文本内容 | choices[i].message.content | choices[i].delta.content | 非流式返回模型生成的完整文本;流式返回当前 chunk 的增量文本,需要按顺序拼接。注意:choices[i].message.content 只用于非流式输出,流式输出对应的是 choices[i].delta.content,不是 message.content。 |
| 工具调用 | choices[i].message.tool_calls | choices[i].delta.tool_calls | 非流式返回完整的工具调用信息;流式返回增量的工具调用信息,函数名和参数可能分多次返回,需要累积拼接。 |
框架选型
spring
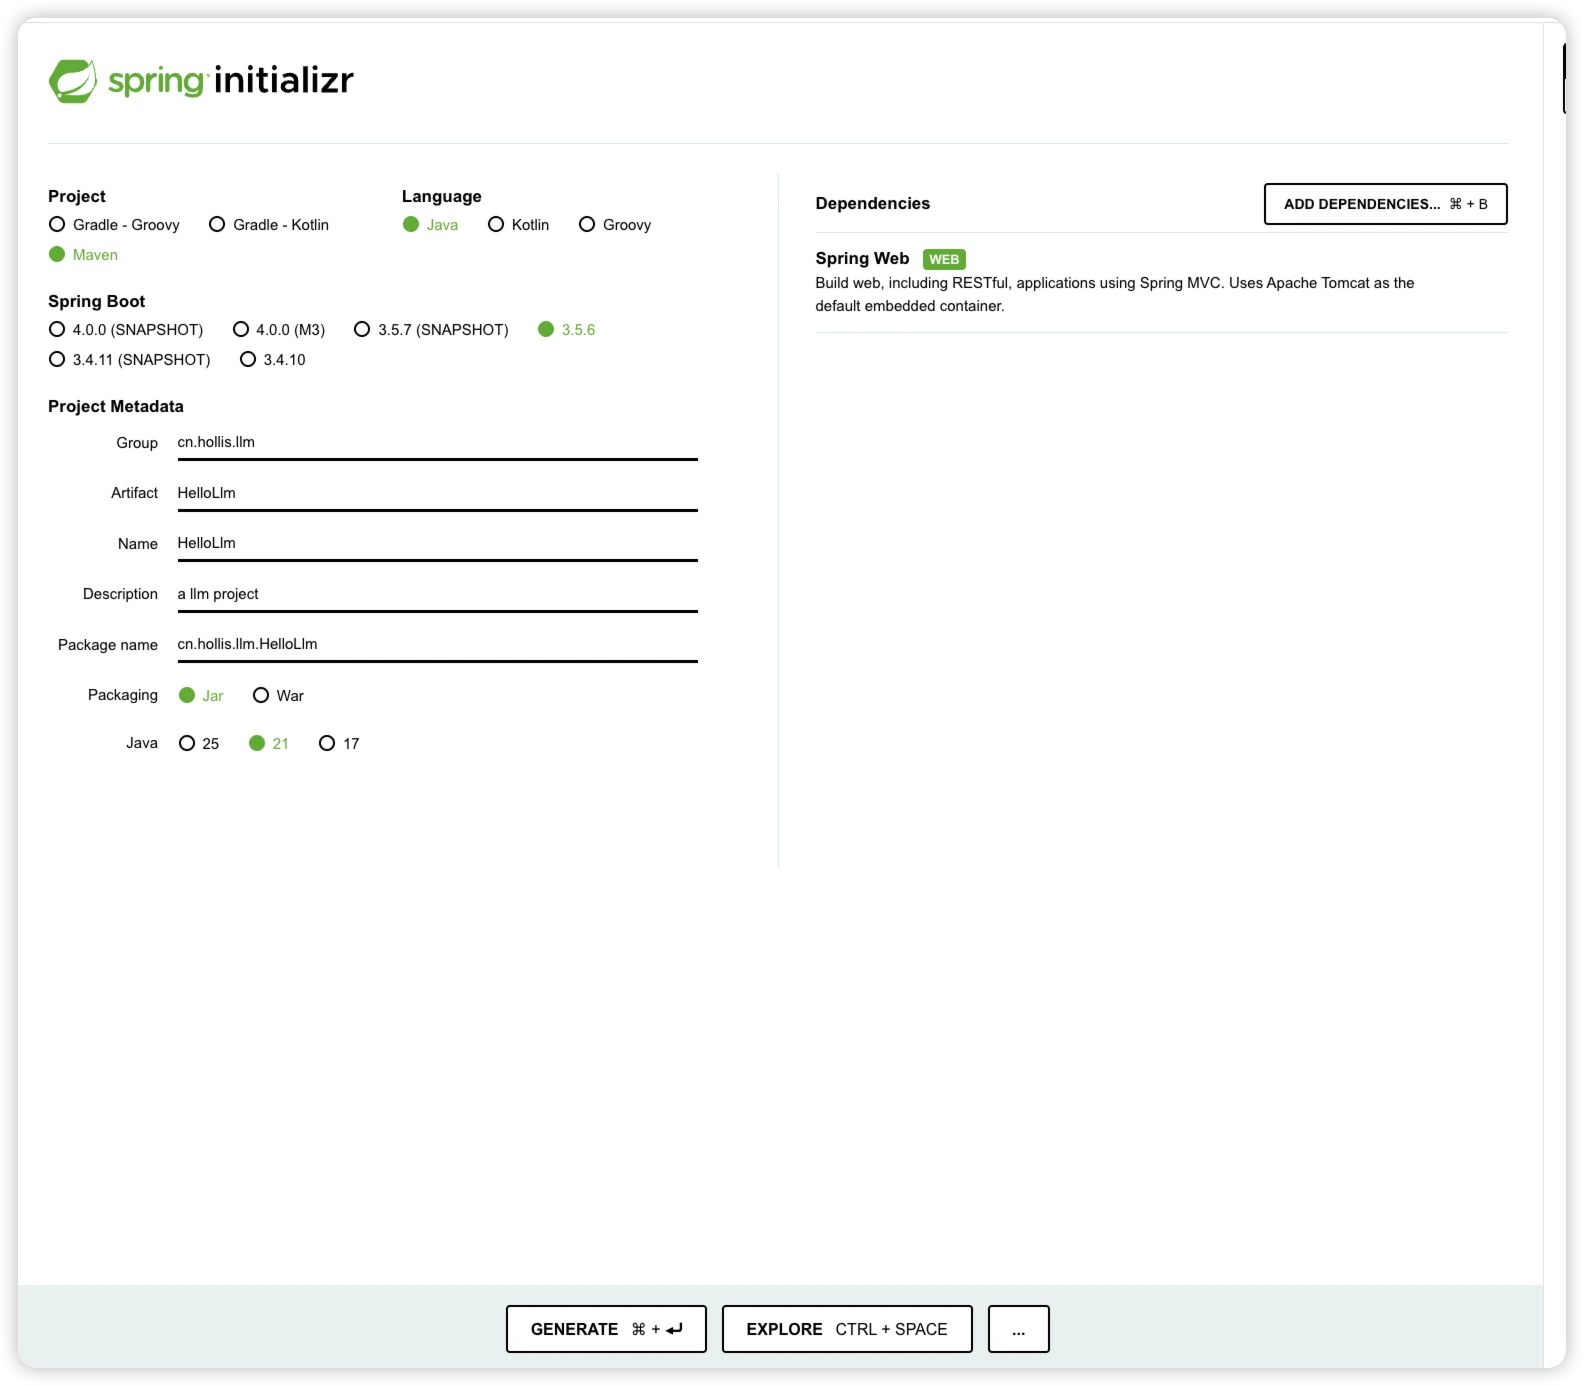
通过https://start.spring.io/快速创建
<packaging>pom</packaging><modules> <module>demo-common</module> <module>demo-service</module> <module>demo-web</module></modules>//分模块设计<parent> <groupId>com.example</groupId> <artifactId>demo-parent</artifactId> <version>0.0.1-SNAPSHOT</version> <relativePath>../pom.xml</relativePath></parent>| 能力 | LangChain4j | Spring AI | Spring AI Alibaba |
|---|---|---|---|
| 是否依赖 Spring | ❌ 可独立使用 | ✔️ 深度集成 | ✔️ 深度集成 |
| Prompt 模板 | ✔️ Mustache 风格 | ✔️ 类似 Thymeleaf | ✔️ 继承 Spring AI |
| 结构化输出 | ✔️ 强(JSON Schema) | ✔️ 基础支持 | ✔️ 增强版 |
| RAG 支持 | ✔️ 全链路 | ✔️ 基础 | ✔️ 企业级增强 |
| 智能体(Agent) | ✔️ 内置 ReAct 等 | ❌ 需手动实现 | ✔️ Graph + Multi-Agent |
| 工作流编排 | ⚠️ 简单 Chain | ❌ 无 | ✔️ Graph 引擎(核心优势) |
| 阿里云集成 | ✔️ Qwen / DashScope | ❌ 无官方支持 | ✔️ 深度集成(百炼、OSS、Nacos) |
| 生产可观测性 | ⚠️ 需自行集成 | ✔️ Micrometer | ✔️ ARMS / SLS 原生 |
- 非 Spring 的纯Java项目项目→ 选 LangChain4j
- 需要快速原型验证,且熟悉 LangChain 概念 → 选 LangChain4j
- 已有 Spring Boot 项目,只需简单 LLM 调用或 RAG → 选 Spring AI
- 构建企业级、多步骤、多角色协作的 AI 应用 → 选 Spring AI Alibaba
- 想用 Java 但又想要接近 Python LangChain 的体验 → LangChain4j 是最佳选择
LangChain
构建翻译系统
uv init langchain_testcd langchain_testuv venvsource .venv/bin/activate//添加依赖uv add langserve fastapi langchain_openai sse_starlette uvicornfrom fastapi import FastAPIfrom langchain_core.prompts import ChatPromptTemplatefrom langchain_core.output_parsers import StrOutputParserfrom langchain_openai import ChatOpenAIfrom langserve import add_routes
OPENAI_API_KEY = "sk-ws-H.EHMYHYX.VeUc.MEUCIQDyLgMI5VSHAOyUHnbblT4muC2q2DhOXkCPY9OY_a9GCAIga6OiX6wD-bOZtgzy4iGErxOZiP4E_QPbJtUcEPGYYr4"OPENAI_API_BASE = "https://dashscope.aliyuncs.com/compatible-mode/v1"
# 1. Create prompt templatesystem_template = "Translate the following into {language}:"prompt_template = ChatPromptTemplate.from_messages([ ('system', system_template), ('user', '{text}')])
# 2. Create modelmodel = ChatOpenAI( model="deepseek-v3", api_key=OPENAI_API_KEY, base_url=OPENAI_API_BASE, temperature=0.7,)
# 3. Create parserparser = StrOutputParser()
# 4. Create chainchain = prompt_template | model | parser
# 4. App definitionapp = FastAPI( title="LangChain Server", version="1.0", description="A simple API server using LangChain's Runnable interfaces",)
# 5. Adding chain routeadd_routes( app, chain, path="/chain",)
if __name__ == "__main__": import uvicorn
uvicorn.run(app, host="localhost", port=8000)uv run main.pyPrompt Template(提示模板)
from langchain_core.prompts import ChatPromptTemplatePlain Text- 使用了
ChatPromptTemplate.from_messages()构建结构化的聊天提示。 - 支持系统消息(system)和用户消息(user)的组合,是 LangChain 中用于构造 LLM 输入的标准方式。
- 利用了 模板变量(如
{language}和{text}),实现动态内容注入。
LLM 集成(通过 OpenAI 兼容接口)
from langchain_openai import ChatOpenAIPlain Text我们通过OpenAI 兼容模式调用的是阿里云 DashScope 的 DeepSeek 模型
设置了 model="deepseek-v3"、api_key、base_url、temperature 等参数。
Output Parser(输出解析器)
from langchain_core.output_parsers import StrOutputParserStrOutputParser()将 LLM 的原始响应(通常是AIMessage对象)转换为纯字符串。- 这是 LangChain 中处理模型输出的标准方式,便于后续使用或返回给客户端。
Chain(链式调用)
chain = prompt_template | model | parser- 使用 LCEL(LangChain Expression Language) 语法(
|操作符)将组件串联成一个可执行的流水线。 - 这是一个典型的 Runnable Chain:输入 → 提示模板 → 模型调用 → 输出解析。
LangServe 集成(部署为 API
from langserve import add_routesadd_routes(app, chain, path="/chain")自动为你的 chain 生成 RESTful API(包括/chain/invoke,/chain/stream等端点)。- 基于 FastAPI,支持异步、OpenAPI 文档、自动请求/响应验证。
SpringAI
接入配置
父依赖
<parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId>//指定springBoot版本 <version>4.1.0</version> <relativePath/> <!-- lookup parent from repository --> </parent> <groupId>com.example</groupId> <artifactId>demo</artifactId> <version>0.0.1-SNAPSHOT</version> <packaging>pom</packaging> <name/> <description/> <url/>
<modules> <module>mcp/sringai</module> </modules>
<properties> <java.version>17</java.version> <spring.ai.alibaba.version>1.1.0.0</spring.ai.alibaba.version> </properties>
<dependencyManagement> <dependencies> <dependency> <groupId>com.alibaba.cloud.ai</groupId> <artifactId>spring-ai-alibaba-bom</artifactId> <version>${spring.ai.alibaba.version}</version> <type>pom</type> <scope>import</scope> </dependency> </dependencies> </dependencyManagement>子依赖
<parent> <groupId>com.example</groupId> <artifactId>demo</artifactId> <version>0.0.1-SNAPSHOT</version> <relativePath>../../pom.xml</relativePath> </parent>
<groupId>com.example</groupId> <artifactId>sringai</artifactId> <version>0.0.1-SNAPSHOT</version>
<properties> <maven.compiler.source>17</maven.compiler.source> <maven.compiler.target>17</maven.compiler.target> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <spring.ai.alibaba.version>1.1.0.0</spring.ai.alibaba.version> </properties>
<dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> //子模块添加 <dependency> <groupId>com.alibaba.cloud.ai</groupId> <artifactId>spring-ai-alibaba-starter-dashscope</artifactId> <version>${spring.ai.alibaba.version}</version> </dependency></dependencies>- properties中spring.ai.alibaba.version的版本号
${spring.ai.alibaba.version}
spring: ai: dashscope: api-key: sk-ws-H.EHMYHYX.VeUc.MEUCIQDyLgMI5VSHAOyUHnbblT4muC2q2DhOXkCPY9OY_a9GCAIga6OiX6wD-bOZtgzy4iGErxOZiP4E_QPbJtUcEPGYYr4概念
ChatModel
- ChatModel就是专门和对话模型对接的一套接口。
- 定义了与支持对话功能的语言模型交互的统一方式
- ChatModel接口继承了两个接口
- 一个是Model、一个是StreamingChatModel。
- DashScopeChatModel,这是一个具体的ChatModel的实现
call方法
@RestController@RequestMapping("/model")public class ChatModelController {
@Autowired private DashScopeChatModel dashScopeChatModel;
@RequestMapping("/call/string") public String callString(String message) { return dashScopeChatModel.call(message); }stream方法
@RequestMapping("/stream/string") public Flux<String> callStreamString(String message, HttpServletResponse response) { response.setCharacterEncoding("UTF-8"); //防止变成乱码 return dashScopeChatModel.stream(message); }- callString方法返回值是个Stream
- callStreamString返回值是个Flux
- 不管是call方法,还是stream,入参都是Prompt
Message
- 系统设定(
SYSTEM) - 用户输入(
USER) - 模型回复(
ASSISTANT) - 工具返回结果(
ToolResponse)
ChatOptions
- 模型名称
- 温度(temperature)
- 最大生成 token 数量
- Top-k、Top-p 采样策略
- 其他厂商特有的参数(比如 OpenAI 的
stop、frequency_penalty等)
DashScopeChatOptions.builder().withModel("qwen-plus").build()ChatResponse
不管是call方法,还是stream,出参都是ChatResponse,只不过一个是Flux
resp.getResult().getOutput().getText()ChatClient
基础功能
- 定制和组装模型的输入(Prompt)
- 格式化解析模型的输出(Structured Output)
- 调整模型交互参数(ChatOptions)
高级功能
- 聊天记忆(Chat Memory)
- 工具/函数调用(Function Calling)
- RAG
初始化
@RestController@RequestMapping("/client")//对chatclient进行初始化public class ChatClientController implements InitializingBean {
@Autowired private ChatModel dashScopeChatModel; private ChatClient chatClient; @Override public void afterPropertiesSet() throws Exception { chatClient = ChatClient.builder(dashScopeChatModel) // 实现 Logger 的 Advisor .defaultAdvisors( new SimpleLoggerAdvisor() ) .defaultSystem("请用英文回答问题") // 设置 ChatClient 中 ChatModel 的 Options 参数 .defaultOptions(DashScopeChatOptions.builder() .temperature(0.7) .build() ) .build(); }}Defult
ChatClient在初始化的时候,可以指定很多defalut的配置
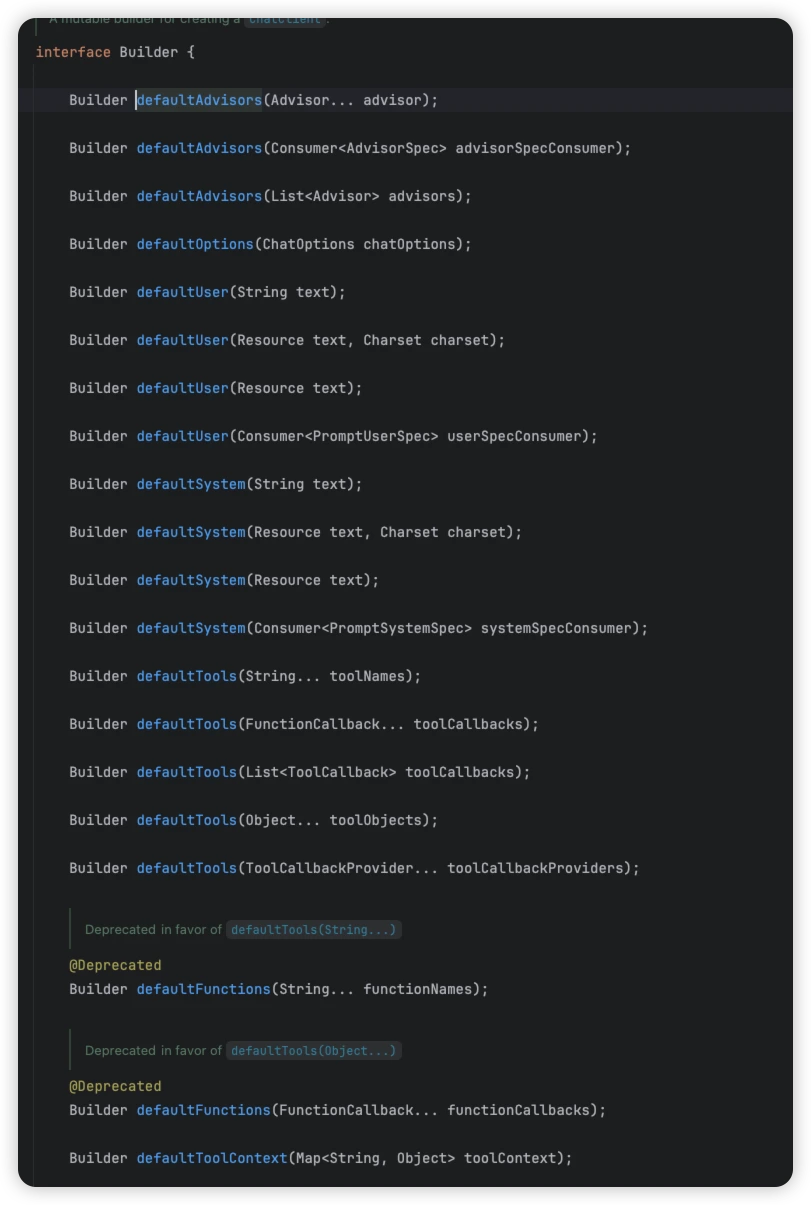
如果重新指定了system,那么defaultSystem就会被覆盖。
@GetMapping("/recover") public Flux<String> recover(String message, HttpServletResponse response){ response.setCharacterEncoding("UTF-8"); return chatClient.prompt(message).system("请用中文回答").stream().content(); }如果是在 Prompt 中设置的 SystemMessage,则会追加,而不是覆盖(记忆)
//追加关系(记忆) @GetMapping("/plus") public Flux<String> plus(String message,HttpServletResponse response) { response.setCharacterEncoding("UTF-8"); List<Message> messages = List.of( new SystemMessage("8加7等于多少"), new UserMessage("message") ); return chatClient.prompt(new Prompt(messages)).stream().content(); }Tools
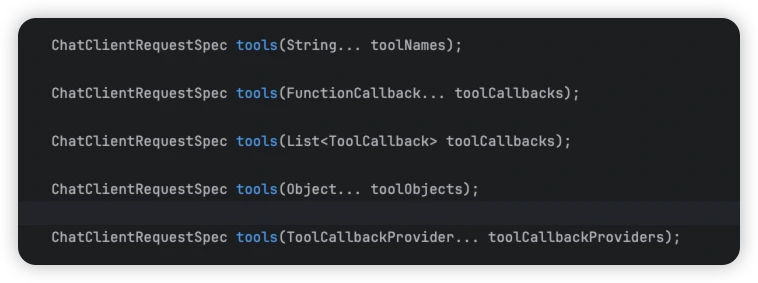
模型需要会用工具才能帮我实现很多功能
Advisors
Advisors 是一组拦截器或“切面”,用于在调用前后对 Prompt 或 Response 进行拦截、修改、增强或记录。
类似于 Spring AOP 的 Advisor,但用于 AI 请求/响应的处理链路。)
RAG、记忆等等功能,都需要借助Advisor来实现
提示词工程
角色设定
利用defaultSystem指定
@RestController@RequestMapping("/promt/engineer")public class PromtEngineerController implements InitializingBean { @Autowired private ChatModel chatModel; private ChatClient chatClient;@GetMapping("/role")public String role(String message) { return chatClient.prompt(message).call().content();
} @Override public void afterPropertiesSet() throws Exception { chatClient=ChatClient.builder(chatModel) .defaultSystem("你是一个毒舌博主,说话很噎人,请根据用户问题,怼他") .build(); }}few-shot
覆盖系统提示词
@GetMapping("/shot") public String shot(String message) { return chatClient.prompt().system(""" 请你根据用户输入的问题做改写,主要有以下改写策略: 1、改写其中的错别字。 2、做内容精简,帮用户的一堆废话精简成简单的一句话 可以参考以下实例:
Input:ni好 Output :{"错别字改写":"你好","内容精简":""}
Input:我今天心情不错,我想知道今天是什么天气才让我心情这么好的? Output :{"错别字改写":"","内容精简":"今天是什么天气?"}
""").user(message).call().content(); }指定输出格式
修改prompt提示词
@GetMapping("/promptsEngineer3")public Flux<String> chat3(@RequestParam(value = "message") String message, HttpServletResponse response) { response.setCharacterEncoding("UTF-8");
return chatClient.prompt("请生成包括书名、作者和类别的三本虚构的、非真实存在的中文书籍清单,并以 JSON 格式提供,其中包含以下键:book_id、title、author、genre。").system("你是一个富有创意的作家").user(message).stream().content();}指定步骤
@GetMapping("/chat4")public Flux<String> chat4(@RequestParam(value = "message") String message, HttpServletResponse response) { response.setCharacterEncoding("UTF-8");
return chatClient.prompt(""" 执行以下操作: step1-用一句话概括下面文本。 step 2-将摘要翻译成英语。 step 3-在英语摘要中列出每个人名。 step 4-输出一个 JSON 对象,其中包含以下键:english_summary,num_names。
请用换行符分隔您的答案。 """).system("你是个ai").user(message).stream().content();}思维链
@GetMapping("/chat5")public Flux<String> chat5(@RequestParam(value = "message") String message, HttpServletResponse response) { response.setCharacterEncoding("UTF-8");
return chatClient.prompt(""" 一个水果摊有5箱苹果,每箱重15公斤。今天卖掉了35公斤,还剩下多少公斤苹果?
请一步一步思考,并给出最终答案。 """).system("你是个ai").user(message).stream().content();}流式输出
sseEmitter
SseEmitter是Spring 提供的类,用于实现服务器推送的流式输出。
- 通过
SseEmitter.send()方法发送每个事件。 - 如果一切顺利,通过
emitter.complete()通知客户端输出完成。 - 如果发生异常,可以通过
emitter.completeWithError()将错误通知客户端。
@RestController@RequestMapping("/stream/output")public class SseEmitterController { @GetMapping("/sse/emitter") public SseEmitter sse() { SseEmitter emitter = new SseEmitter(60_000L); // 设置超时时间 //创建虚拟线程 Executors.newSingleThreadExecutor().submit(() -> { try { for (int i = 0; i < 10; i++) { emitter.send("Message " + i); Thread.sleep(1000); } emitter.complete(); } catch (Exception ex) { emitter.completeWithError(ex); } });
return emitter; }}StreamingResponseBody
- StreamingResponseBody 是一个函数式接口,其内部通过 OutputStream 将数据逐步写入响应流,用它可以实现非阻塞的异步流式传输。
- Spring 在处理该返回值时会延迟执行该函数,直到响应提交前才调用 writeTo(OutputStream) 方法。
- 每次写入后调用 flush() 强制刷新缓冲区,使客户端能实时接收内容。
@GetMapping("/sse/streaming")public ResponseEntity<StreamingResponseBody> chat() { StreamingResponseBody body = outputStream -> { for (int i = 0; i < 10; i++) { String data = "data chunk " + i + "\n"; outputStream.write(data.getBytes(StandardCharsets.UTF_8)); outputStream.flush(); try { Thread.sleep(500); // 模拟延迟 } catch (InterruptedException e) { throw new RuntimeException(e); } } };
return ResponseEntity.ok() .header(HttpHeaders.CONTENT_TYPE, MediaType.TEXT_EVENT_STREAM_VALUE) .body(body);}Flux
Spring WebFlux 是一种响应式web框架,使用 WebClient 和 Netty 等非阻塞 IO 技术进行高效数据传输,支持非阻塞I/O。
<dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-webflux</artifactId></dependency>@GetMapping(value = "/sse/flux")public Flux<String> fluxStream() { return Flux.interval(Duration.ofSeconds(1))//相隔时间 .take(100) .map(seq -> "Stream element - " + seq);
}- 只保留前 n 个元素 —— 第 100 个(Message 99)之后的就丢弃不发了。
- 满 n 个后发出完成信号(onComplete)—— 告诉下游”流结束了”,SSE 连接也随之关闭。
- 自动取消上游订阅 —— Flux.interval 本质是个无限流,如果不用 take(100),它会永远每秒发一条、永不停止。
- take 会在取满后自动取消 interval 的定时器,释放线程/定时器资源
- .map 是 Reactor 里的映射/转换操作符
- :把流里的每一个元素,一对一地转换成另一个元素。
实现原理
- 不管是ChatModel还是ChatClient,最终都是依赖reactor.core.publisher.Flux#deferContextual来实现的。
- 响应式编程是一种典型的观察者模式,当有新的可用的数据到来时,
Publisher会对Subscriber进行通知,这种推动是响应式的关键。
Reactor项目的主要组件为 reactor-core。Reactor引入了可组合的响应式类型,这些类型既实现了 Publisher 又提供了丰富的操作符:Flux 和 Mono。
- Flux` 对象表示含有0..N个元素的响应式序列。
Mono对象表示单个值或为空(0..1)的结果。
Flux 是 Reactor 库中的一个发布者(Publisher),遵循 Reactive Streams 规范。
它代表一个异步的、非阻塞的序列,可以发射:
- 0 到多个数据项(
onNext) - 一个可选的错误(
onError) - 或一个完成信号(
onComplete)
提示词模板
- 本质上利用占位符书写用户提示词
- 利用PromptTemplate对象传参
- 调用create方法(Map.of(“topic “,topic))
@GetMapping("/Stream1") public Flux<String> stream1(String topic, HttpServletResponse response){ response.setCharacterEncoding("UTF-8"); String template= """ 请为我推荐一些关于{topic}开源项目 """; return chatClient.prompt(new PromptTemplate(template).create(Map.of("topic",topic))).stream().content(); }@GetMapping("/promptsEngineer7")public Flux<String> chat7(@RequestParam(value = "message") String message, HttpServletResponse response) { response.setCharacterEncoding("UTF-8");
HashMap variables = new HashMap(); variables.put("language", "Java"); variables.put("topic", message); PromptTemplate promptTemplate = PromptTemplate.builder().template("请给我推荐几个关于{topic}的开源项目,要求是和编程语言{language}相关的。").variables(variables).build();
return chatClient.prompt(promptTemplate.create(Map.of("topic", message))).system("你是一个专业的的github项目收集人员").stream().content();}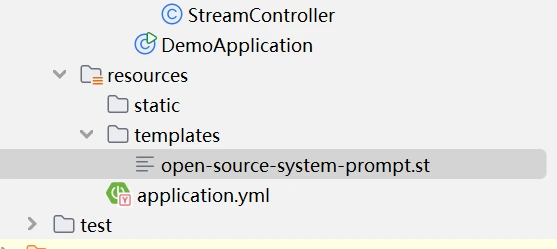
把提示词通过文件来管理,一般使用.st文件,可以在项目中定义一个目录,然后把所有提示词都放在这个目录下,
prompts/open-source-system-prompt.st文件内容
请给我推荐几个关于{topic}的开源项目,要求是和编程语言{language}相关的。 @GetMapping("/chat2") public Flux<String> chat2( String topic, HttpServletResponse response) { response.setCharacterEncoding("UTF-8");
Map<String, Object> variables = new HashMap<>(); variables.put("language", "Java"); variables.put("topic", topic); PromptTemplate promptTemplate = PromptTemplate.builder().resource(systemText).variables(variables).build(); return chatClient.prompt(promptTemplate.create()).system("你是一个专业的的github项目收集人员").stream().content(); }结构化输出
bean
StructuredOutputConverter的接口有实现类BeanOutputConverter
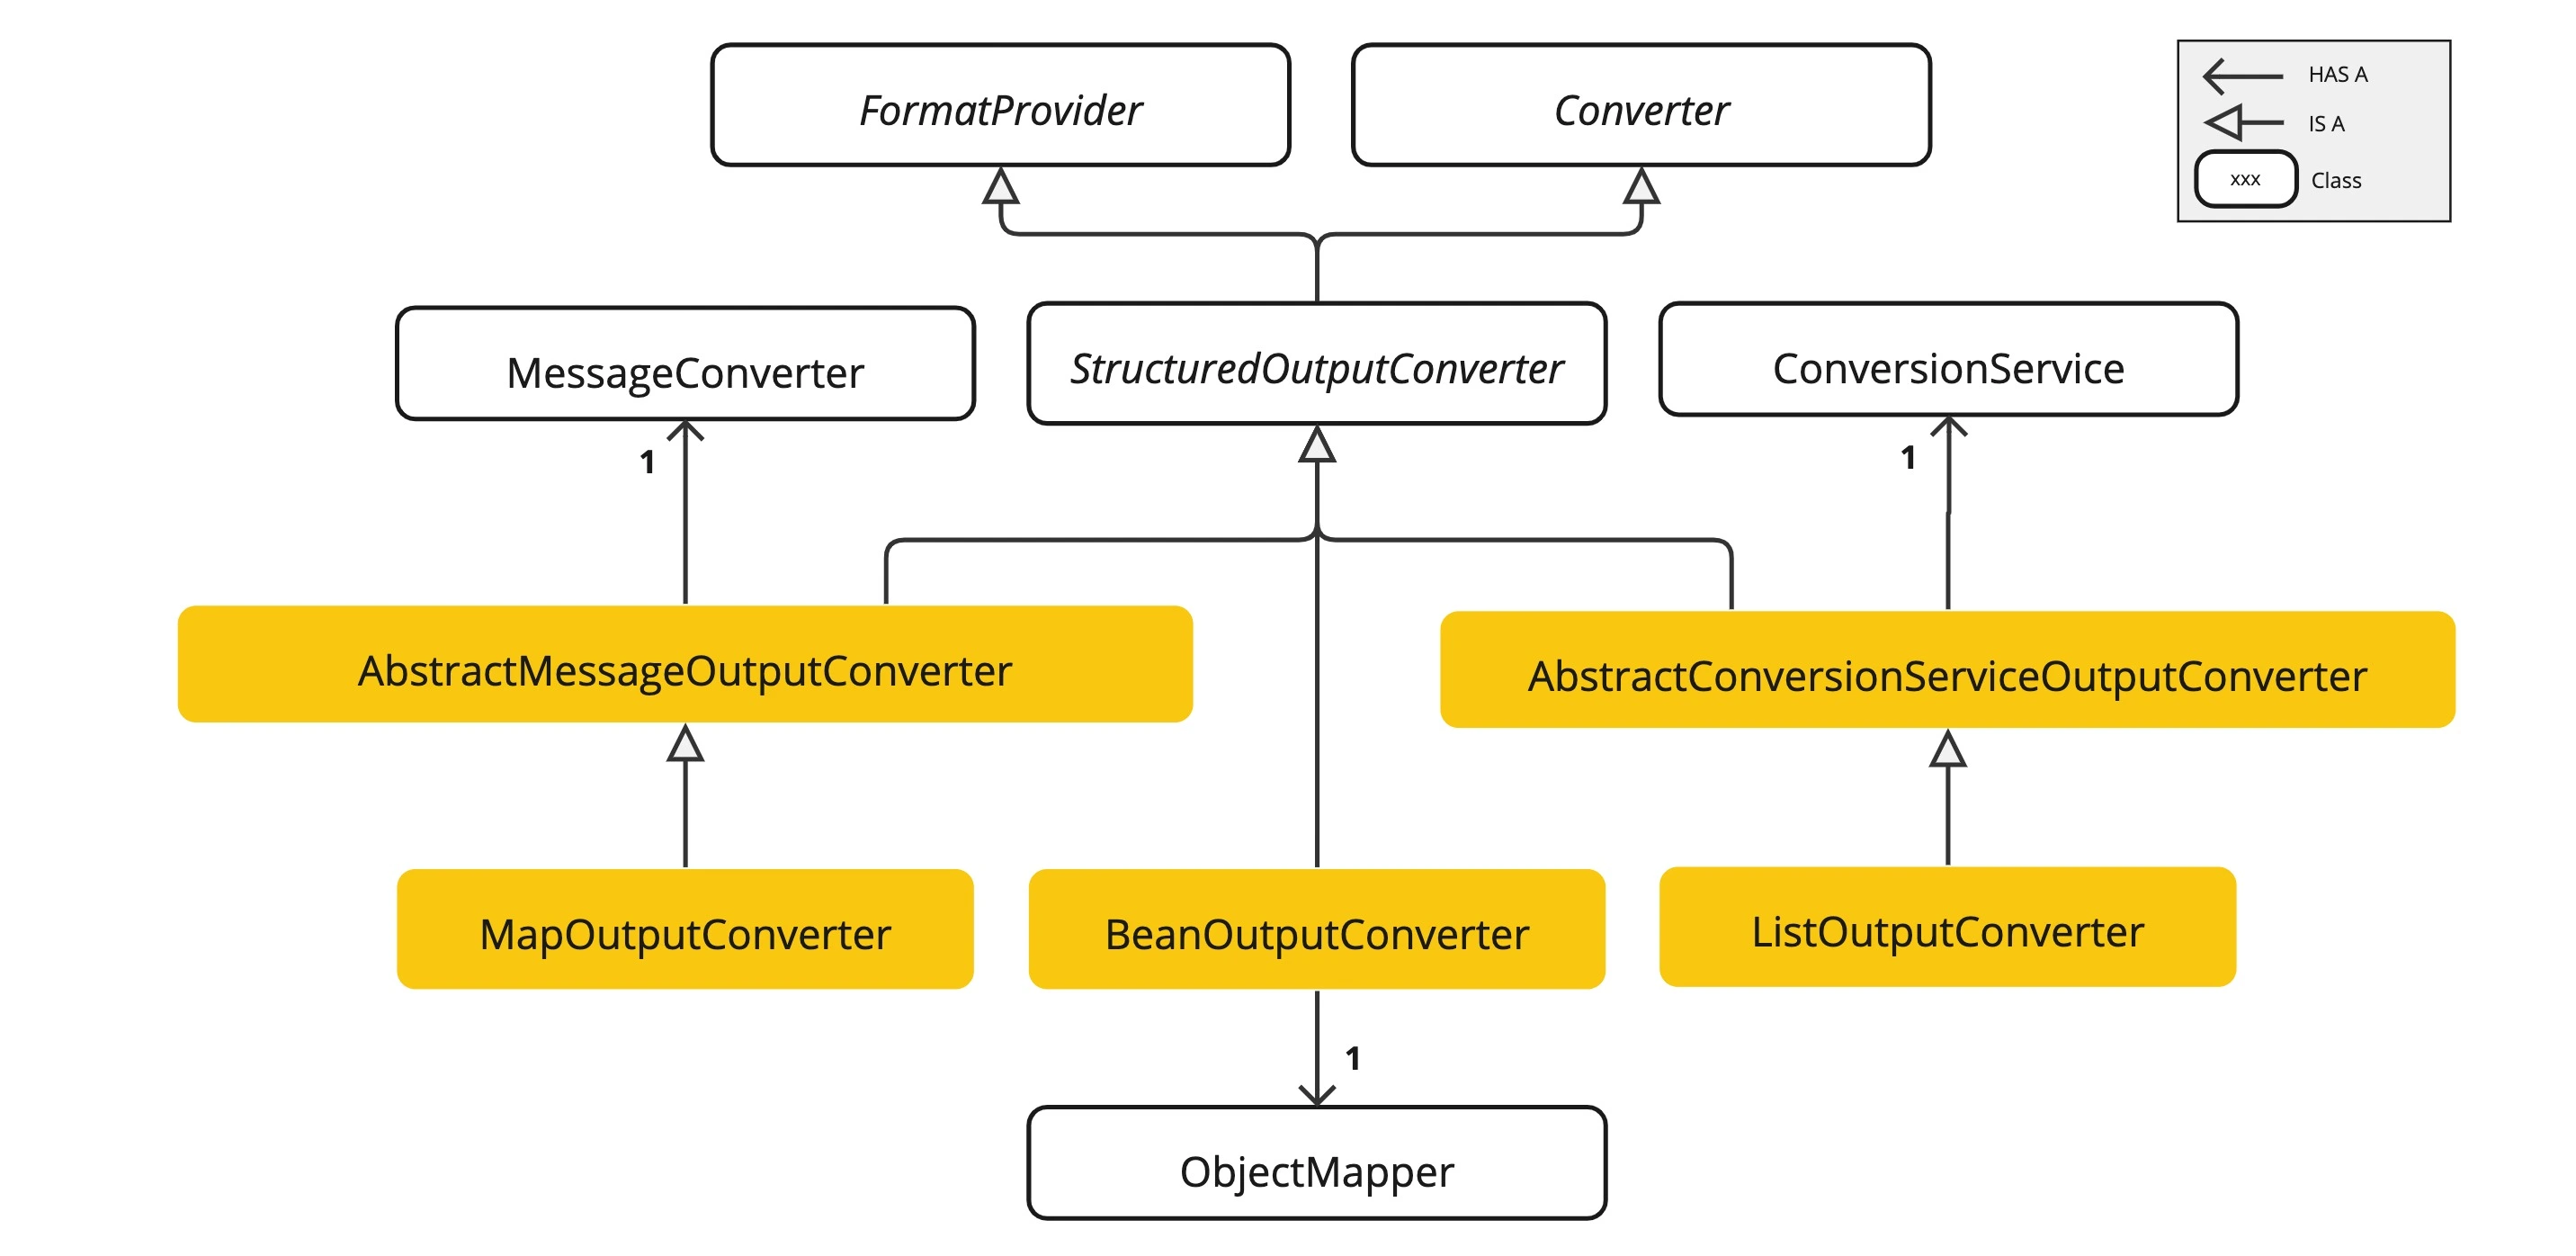
BeanOutputConverter这个类中重写了一个getFormat方法
内容为一段提示词,把这段提示词加到我们的对话的后面,就能得到我们想要的JSON格式
@Overridepublic String getFormat() { String template = """ Your response should be in JSON format. Do not include any explanations, only provide a RFC8259 compliant JSON response following this format without deviation. Do not include markdown code blocks in your response. Remove the ```json markdown from the output. Here is the JSON Schema instance your output must adhere to: ```%s``` """; return String.format(template, this.jsonSchema);}提前告诉Converter我们都需要哪些字段。BeanOutputConverter通过他的名字就能看出来,他其实是可以把模型的结构化输出转成一个bean的,而bean的话我们是可以提前定义好他的参数名
public record Book(@JsonPropertyDescription("书籍名称") String title, @JsonPropertyDescription("作者") String author, @JsonPropertyDescription("书籍介绍") String description, @JsonPropertyDescription("价格") BigDecimal price) {
} @GetMapping("/bean") public Book bean(String format) { BeanOutputConverter<Book> beanOutputConverter = new BeanOutputConverter<>(Book.class); return chatClient.prompt(new PromptTemplate("你需要推荐一本书,请以{format}格式输出") .create(Map.of("format", beanOutputConverter.getFormat()))) .system("你是一个专业的图书推荐人员") .call() .entity(beanOutputConverter); }@GetMapping("/chat2")public String chat2(HttpServletResponse response) { Book book = chatClient.prompt("请帮我推荐几本java相关的书").system("你是一个专业的图书推荐人员").call().entity(Book.class); return book.toString();}BeanOutputConverter只能针对String做转换,Flux
.call.content返回值为字符串,需要借助entity转为Bean
第一行是参数合法性检测,
第二行是new 一个 BeanOutputConverter
- BeanOutputConverter的构造函数依赖ParameterizedTypeReference创建的,
- 直接用ParameterizedTypeReference.forType(clazz)来把一个任意Class转成BeanOutputConverter需要。
第三行是调用doSingleWithBeanOutputConverter方法:
- 在 LLM 调用之前,Converter向提示中添加格式指令,为模型提供明确的指导,以生成所需的输出结构。(doGetObservableChatClientResponse方法中)
- 在 LLM 调用之后,Converter将模型的输出文本转换为结构化类型的实例。(outputConverter.convert(stringResponse))
List
StructuredOutputConverter的实现类,除了BeanOutputConverter之外,还有ListOutputConverter、MapOutputConverter
List<Book> result = chatClient.prompt("请帮我推荐几本java相关的书").system("你是一个专业的图书推荐人员").call().entity(
new ParameterizedTypeReference<//抽象类需要重写方法List<Book>>() { });Map<String, Object> book = chatClient.prompt("请给我推荐几本心理学有关的书,书的内容包括书名、作者、价格、上市时间等信息,以书名作为key,书的信息作为value") .call().entity(new MapOutputConverter());-
不支持转成List
和Map<String,Bean>,只能转成List 和Map<String,Object>, -
最终转成的内容并不是我们想要的,比如我们要一个完成的book,他可能只输出了一个书名的List。
-
利用java8中的stream()转为List后自己转为Map或者设置few-shot提示词
对话记忆
Message List
@RestController@RequestMapping("/ai/memory")public class ChatMemoryController implements InitializingBean {
@Autowired private DashScopeChatModel chatModel;
private ChatClient chatClient;
@GetMapping("/chat") public String chat() {
List<Message> messages = new ArrayList<>();
//第一轮对话 messages.add(new SystemMessage("你是一个游戏设计师")); messages.add(new UserMessage("我想设计一个回合制游戏")); ChatResponse chatResponse = chatModel.call(new Prompt(messages)); String content = chatResponse.getResult().getOutput().getText(); System.out.println(content); System.out.println("======");
messages.add(new AssistantMessage(content));
//第二轮对话 messages.add(new UserMessage("能帮我结合一些二次元的元素吗?")); chatResponse = chatModel.call(new Prompt(messages)); content = chatResponse.getResult().getOutput().getText(); System.out.println(content); System.out.println("======");
messages.add(new AssistantMessage(content));
//第三轮对话 messages.add(new UserMessage("那如果主要是针对女性玩家的游戏呢?有什么需要改进的?")); chatResponse = chatModel.call(new Prompt(messages)); content = chatResponse.getResult().getOutput().getText(); System.out.println(content); System.out.println("======");
return content; }
@Override public void afterPropertiesSet() throws Exception { ChatMemory chatMemory = new InMemoryChatMemory();
this.chatClient = ChatClient.builder(chatModel) // 实现 Logger 的 Advisor .defaultAdvisors(new MessageChatMemoryAdvisor(chatMemory)) // 设置 ChatClient 中 ChatModel 的 Options 参数 .defaultOptions( DashScopeChatOptions.builder() .withTopP(0.7) .build() ) .build(); }}chatid
- message list是要每一次都重新add进去,传给大模型
- 对话的历史message,我们是在代码中有调用记录的。
- 记忆的消息设置同一个chat_memory_conversation_id,同一个这样的id下的消息就可以识别出来,这样就能组装成上面的message list给到LLM。
@Autowiredprivate ChatModel chatModel;
private ChatClient chatClient;
@GetMapping("/chat1") public Flux<String> chat1(String message, String chatId, HttpServletResponse response) { response.setCharacterEncoding("UTF-8");
return chatClient .prompt() .user(message) .advisors(spec -> spec.param(ChatMemory.CONVERSATION_ID, chatId)) .stream().content();
}@Aut
@Override public void afterPropertiesSet() throws Exception { // ChatMemory chatMemory = MessageWindowChatMemory.builder().maxMessages(10).build();
this.chatClient = ChatClient.builder(chatModel)
//利用builder 实现 ChatMemoryAdvisor 的 Advisor .defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build())
// 设置 ChatClient 中 ChatModel 的 Options 参数 .defaultOptions( DashScopeChatOptions.builder() .withTopP(0.7) .build() ) .build();MessageWindowChatMemory,
- Spring AI 框架中窗口对话记忆实现。
- 核心思想是:只保留最近发生的、一定数量的交互消息,当消息数量超过窗口大小时,会自动将最早的消息移除。
- ChatMemory的maxMessages,里面的message的最大记忆条数,包括了UserMessage、AssistantMessage等,并不是说只有用户的对话内容。
想要构造一个MessageWindowChatMemory,可以用ChatMemoryAdvisor,有两个具体的实现:
- MessageChatMemoryAdvisor:这个Advisor的主要功能是将用户提出的问题和模型的回答添加到历史记录(messages)中,从而实现上下文记忆的能力。
- PromptChatMemoryAdvisor:是MessageChatMemoryAdvisor的一个增强,在有些不支持messages参数的模型使用的时候,可以用这种,他是改写了systemPrompt,把每一轮的输入和输出都补充到这里面去了。
ChatMemory
- MessageWindowChatMemory不用自己new
- 注入的是一个基于内存的对话记忆
<!-- chatMemoy基于内存对话记忆--> <dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-autoconfigure-model-chat-memory</artifactId> <version>1.1.0</version> </dependency>ChatClient.builder(chatModel) .defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build())-
用
chatModel构建客户端 -
把“记忆顾问”挂上去
记忆顾问是MessageChatMemoryAdvisor`
它的身份可以理解为
ChatClient的一个Advisor- 负责在每次请求前,按
chatId去ChatMemory里取历史消息 - 再把这些历史消息塞进本次 prompt
- 模型返回后,再把新消息写回记忆
.advisors(spec -> spec.param(ChatMemory.CONVERSATION_ID, chatId))chatId不是直接传给模型- 它是传给
MessageChatMemoryAdvisor - 这个 advisor 会用它去定位“这是谁的历史消息”
// 伪代码history = chatMemory.get(chatId);prompt = history + 当前用户消息;answer = model.generate(prompt);chatMemory.save(chatId, 用户消息, answer);
请求 -> ChatClient -> MessageChatMemoryAdvisor -> ChatMemory -> ChatMemoryRepository -> 存储后端总结
策略
ChatMemory:记忆策略层,负责“保留哪些消息、何时裁剪”
MessageWindowChatMemory
MessageWindowChatMemory只管窗口策略,不管具体存储。- 它
add()时会先从仓库读出当前会话消息,再把新消息合并、裁剪,最后整体saveAll()回去。 - 所以“记忆”不是历史全量保存,而是当前上下文窗口。
它默认是一个基于内存的短期记忆实现,它维护最多指定最大大小(默认值:20 条消息)的消息窗口。
存储
ChatMemoryRepository:存储层,负责“把消息存哪、怎么取出来”
| 类/接口 | 类型 | 关系 | 职责 | 典型特点 |
|---|---|---|---|---|
ChatMemory | 接口 | 被 MessageWindowChatMemory 实现 | 定义“聊天记忆”这一层抽象 | 负责记忆策略,不负责具体存储 |
ChatMemoryRepository | 接口 | 被各类 Repository 实现 | 定义消息的存取能力 | 负责持久化/读取聊天消息 |
MessageWindowChatMemory | 类 | implements ChatMemory,并依赖 ChatMemoryRepository | 按窗口大小维护上下文消息 | 默认最大 20 条;默认仓库是内存实现 |
InMemoryChatMemoryRepository | 类 | implements ChatMemoryRepository | 将消息存到本地内存 | 基于 ConcurrentHashMap;进程重启即丢失 |
JdbcChatMemoryRepository | 类 | implements ChatMemoryRepository | 将消息存到关系型数据库 | 支持 PostgreSQL / MySQL / SQL Server / Oracle 等 |
CassandraChatMemoryRepository | 类 | implements ChatMemoryRepository | 将消息存到 Cassandra | 适合高可用、TTL、分布式场景 |
Neo4jChatMemoryRepository | 类 | implements ChatMemoryRepository | 将消息存到 Neo4j 图数据库 | 适合保留关系结构和图查询 |
MongoChatMemoryRepository | 类 | implements ChatMemoryRepository | 将消息存到 MongoDB | 面向文档存储,结构灵活 |
CosmosDBChatMemoryRepository | 类 | implements ChatMemoryRepository | 将消息存到 Azure Cosmos DB | 外部模块,不属于 Spring AI 核心包 |
持久化记忆
配置
引入jdbc对话记忆仓库
dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-starter-model-chat-memory-repository-jdbc</artifactId> <version>1.1.0</version></dependency>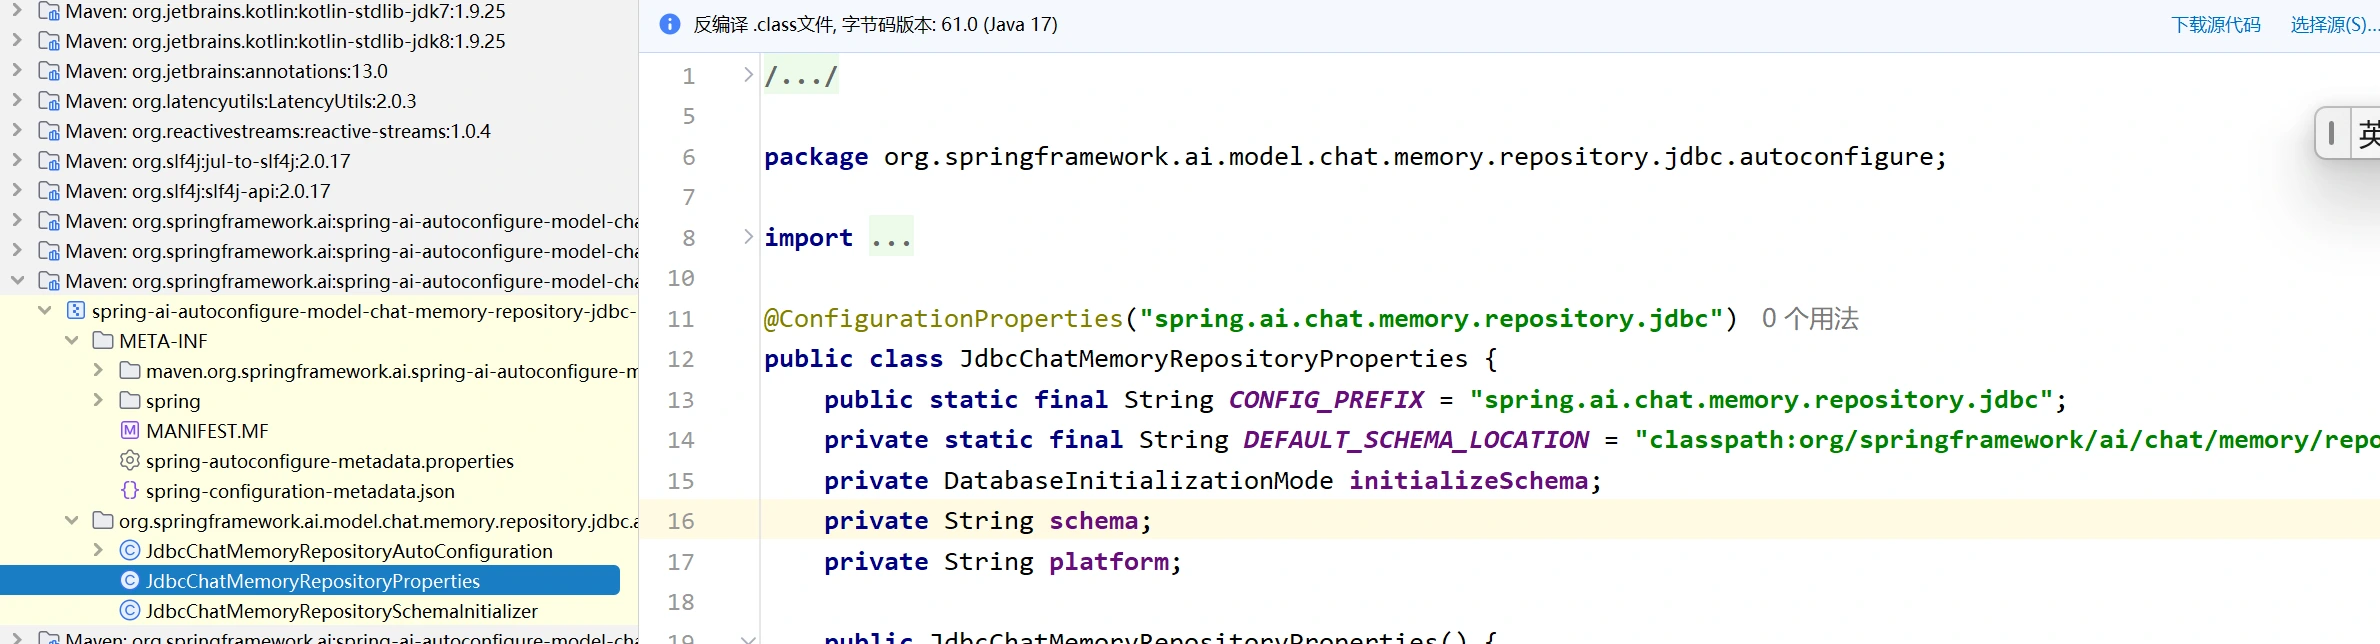
一个是jdbc操作的工具包,一个是对他做自动化配置的。
spring: application: name: demo ai: dashscope: api-key: sk-ws-H.EHMYHYX.VeUc.MEUCIQDyLgMI5VSHAOyUHnbblT4muC2q2DhOXkCPY9OY_a9GCAIga6OiX6wD-bOZtgzy4iGErxOZiP4E_QPbJtUcEPGYYr4 chat: memory: repository: jdbc: platform: mysql initialize-schema: always- platform用于指定具体哪个数据库,他支持很多数据库
- 在platform和schema二选一进行配置就行了,就是指定用哪个表结构
CREATE TABLE `spring_ai_chat_memory` ( `conversation_id` varchar(36) CHARACTER SET utf8mb4 NOT NULL, `content` text CHARACTER SET utf8mb4 NOT NULL, `type` enum('USER','ASSISTANT','SYSTEM','TOOL') CHARACTER SET utf8mb4 NOT NULL, `timestamp` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP, KEY `SPRING_AI_CHAT_MEMORY_CONVERSATION_ID_TIMESTAMP_IDX` (`conversation_id`,`timestamp`)) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci;数据库交互还需要一个datasource,我们需要有个数据库连接的能力,
<dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>8.0.33</version></dependency> datasource: url: jdbc:mysql://localhost:3306/springai?useUnicode=true&characterEncoding=UTF-8 # 记得改成你自己的 username: root # 记得改成你自己的 password: 123456 # 记得改成你自己的 driver-class-name: com.mysql.cj.jdbc.Driver引入仓库
@Configurationpublic class JdbcChatMemoryConfiguration {
@Bean public ChatMemory jdbcChatMemory(JdbcChatMemoryRepository jdbcChatMemoryRepository) { return MessageWindowChatMemory.builder().chatMemoryRepository(jdbcChatMemoryRepository).maxMessages(20).build(); }}cassandra和neo4j的支持可供选择
<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-starter-model-chat-memory-repository-cassandra</artifactId></dependency><dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-starter-model-chat-memory-repository-neo4j</artifactId></dependency>Advisor
初识
用于拦截、修改和增强 Spring 应用中的 AI 交互功能
.defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build()).defaultAdvisors( new SimpleLoggerAdvisor()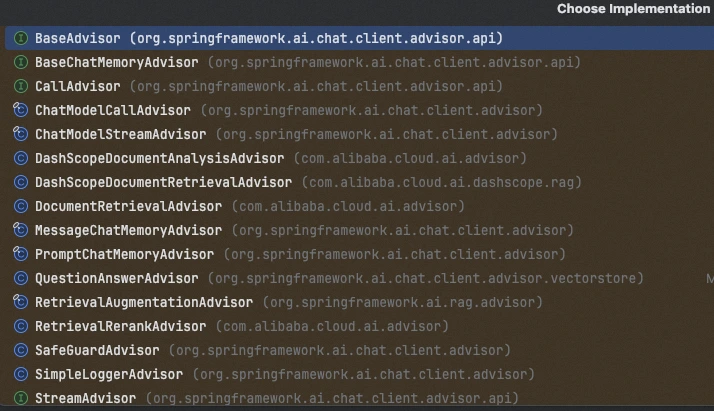
- Advisor接口继承自Ordered,需要在实现
int getOrder();这个方法。 - 这个方法主要是用来设置各个Advisor的顺序的。
public interface Advisor extends Ordered { int DEFAULT_CHAT_MEMORY_PRECEDENCE_ORDER = -2147482648; String getName();}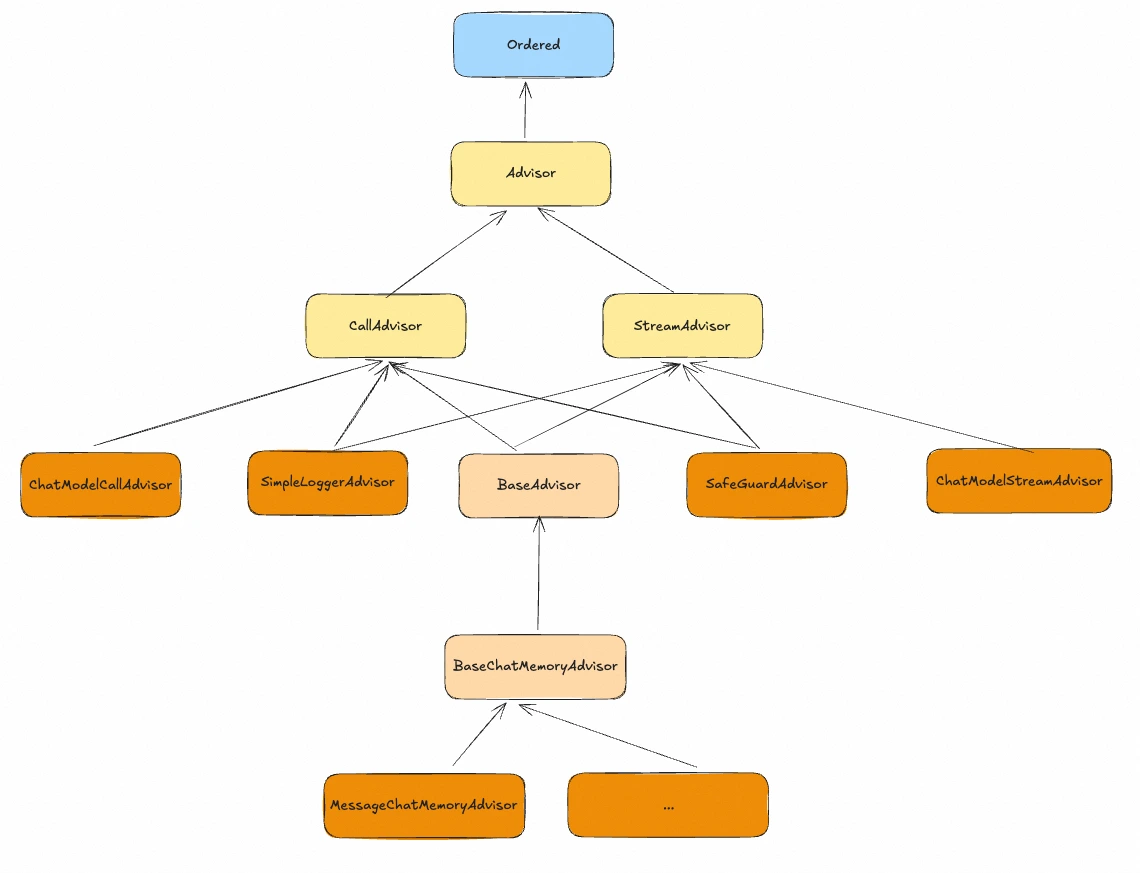
-
最基础的两个接口,一个是CallAdvisor一个是StreamAdvisor,
-
一个是给同步调用使用的,另一个是给流式调用使用的
-
提供了adviseCall和adviseStream方法
ChatClient 不是直接调某个 advisor,而是栈式递归
把所有注册到一个chatClient上的Advisor都找出来,然后按顺序执行
第一步
-
DefaultChatClient` 负责把请求组装好,再启动链。
-
DefaultChatClient会把当前 chatClient 上注册的 advisor 按order组进 advisorChain
第二步
- 然后同步走 nextCall(),流式走 nextStream()
- advisorChain.nextCall(chatClientRequest)
- advisorChain.nextStream(chatClientRequest)
不是“调用一个 advisor”,而是“启动一整条责任链”,每个 advisor 都像 AOP 的一层织入,先进来的先包住请求,最后再包回响应
第三步
- ChatModelCallAdvisor / ChatModelStreamAdvisor`。链上的每个 advisor 都像 AOP 的一层环绕增强,
ChatModelCallAdvisor:终点,真正调用chatModel.call(...),没有它链就断了
顺序
- order 越小,越先进入链
- 越先进入的,越晚拿到响应
- order 越大,越靠近 ChatModelCallAdvisor 这个终点
分类
SimpleLoggerAdvisor:典型环绕型,前后都做日志,不改业务SafeGuardAdvisor:前置拦截 / 后置审查,必要时直接挡掉请求BaseAdvisor:模板层,把before / after这套样板封装掉,让具体 advisor 少写重复代码
ChatModel
直接调用chatModel的call方法
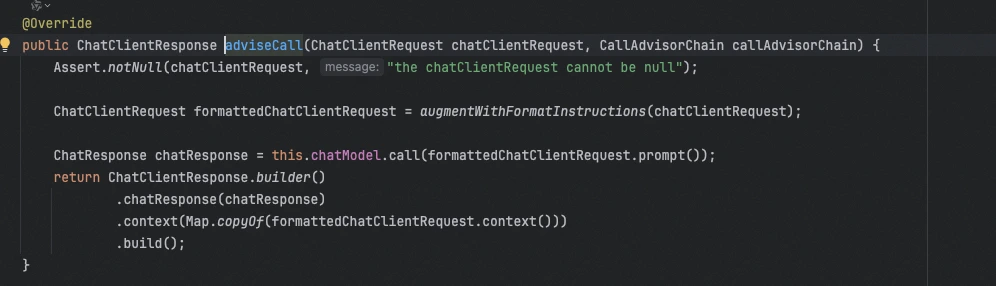
理论上最后执行的,所以getOrder设置的是最低优先级。
@Overridepublic int getOrder() { return Ordered.LOWEST_PRECEDENCE;SimpleLogger
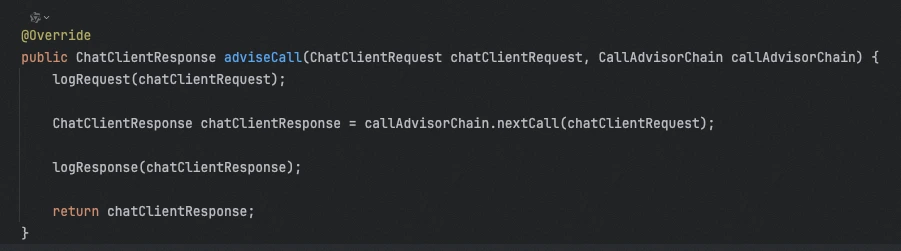
adviseCall实现先记录一下request的日志,在调用之后,再记录一下response的日志。
SafeGuard
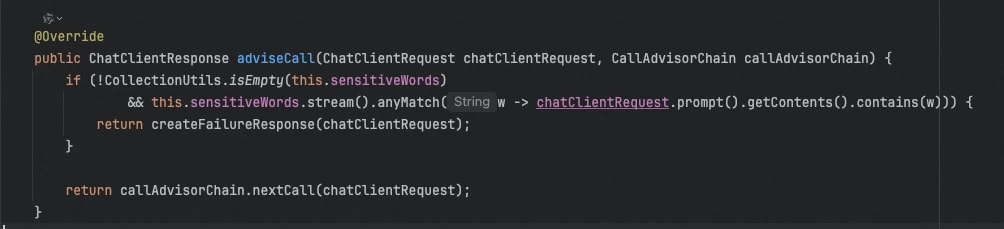
这是一个spring ai内置的安全审查的advisor,实现内容就是做敏感词拦截:
Base
ChatClientRequest processedRequest = before(chatClientRequest, callAdvisorChain);
ChatClientResponse response = callAdvisorChain.nextCall(processedRequest);
return after(response, callAdvisorChain);- before():模型调用前执行,相当于前置增强
- chain.nextCall():继续执行后面的 advisor,直到最后调用模型
- after():模型返回后执行,相当于后置增强
- 如果某个 advisor 不调用 chain.nextCall(),就等于拦截请求,后面的 advisor 和模型都不会执行
Advisor 的“目标方法”不是某个 Service 方法,而是“后续 advisor + 最终 ChatModel 调用”
order 越小,越早处理请求;但它越晚处理响应
MessageChatMemoryAdvisor 的 before
用户这次的问题 + 历史对话记录 ↓组合成新的 Prompt ↓再交给后面的 advisor / ChatModel模型并不是“自动记住上下文”,而是 MessageChatMemoryAdvisor 每次调用前主动把历史消息查出来,再塞到本次请求里。
before 阶段:保存 user messageafter 阶段:保存 assistant messagebefore:读取历史记忆 + 拼进本次请求 + 保存用户消息after:提取模型回复 + 保存助手消息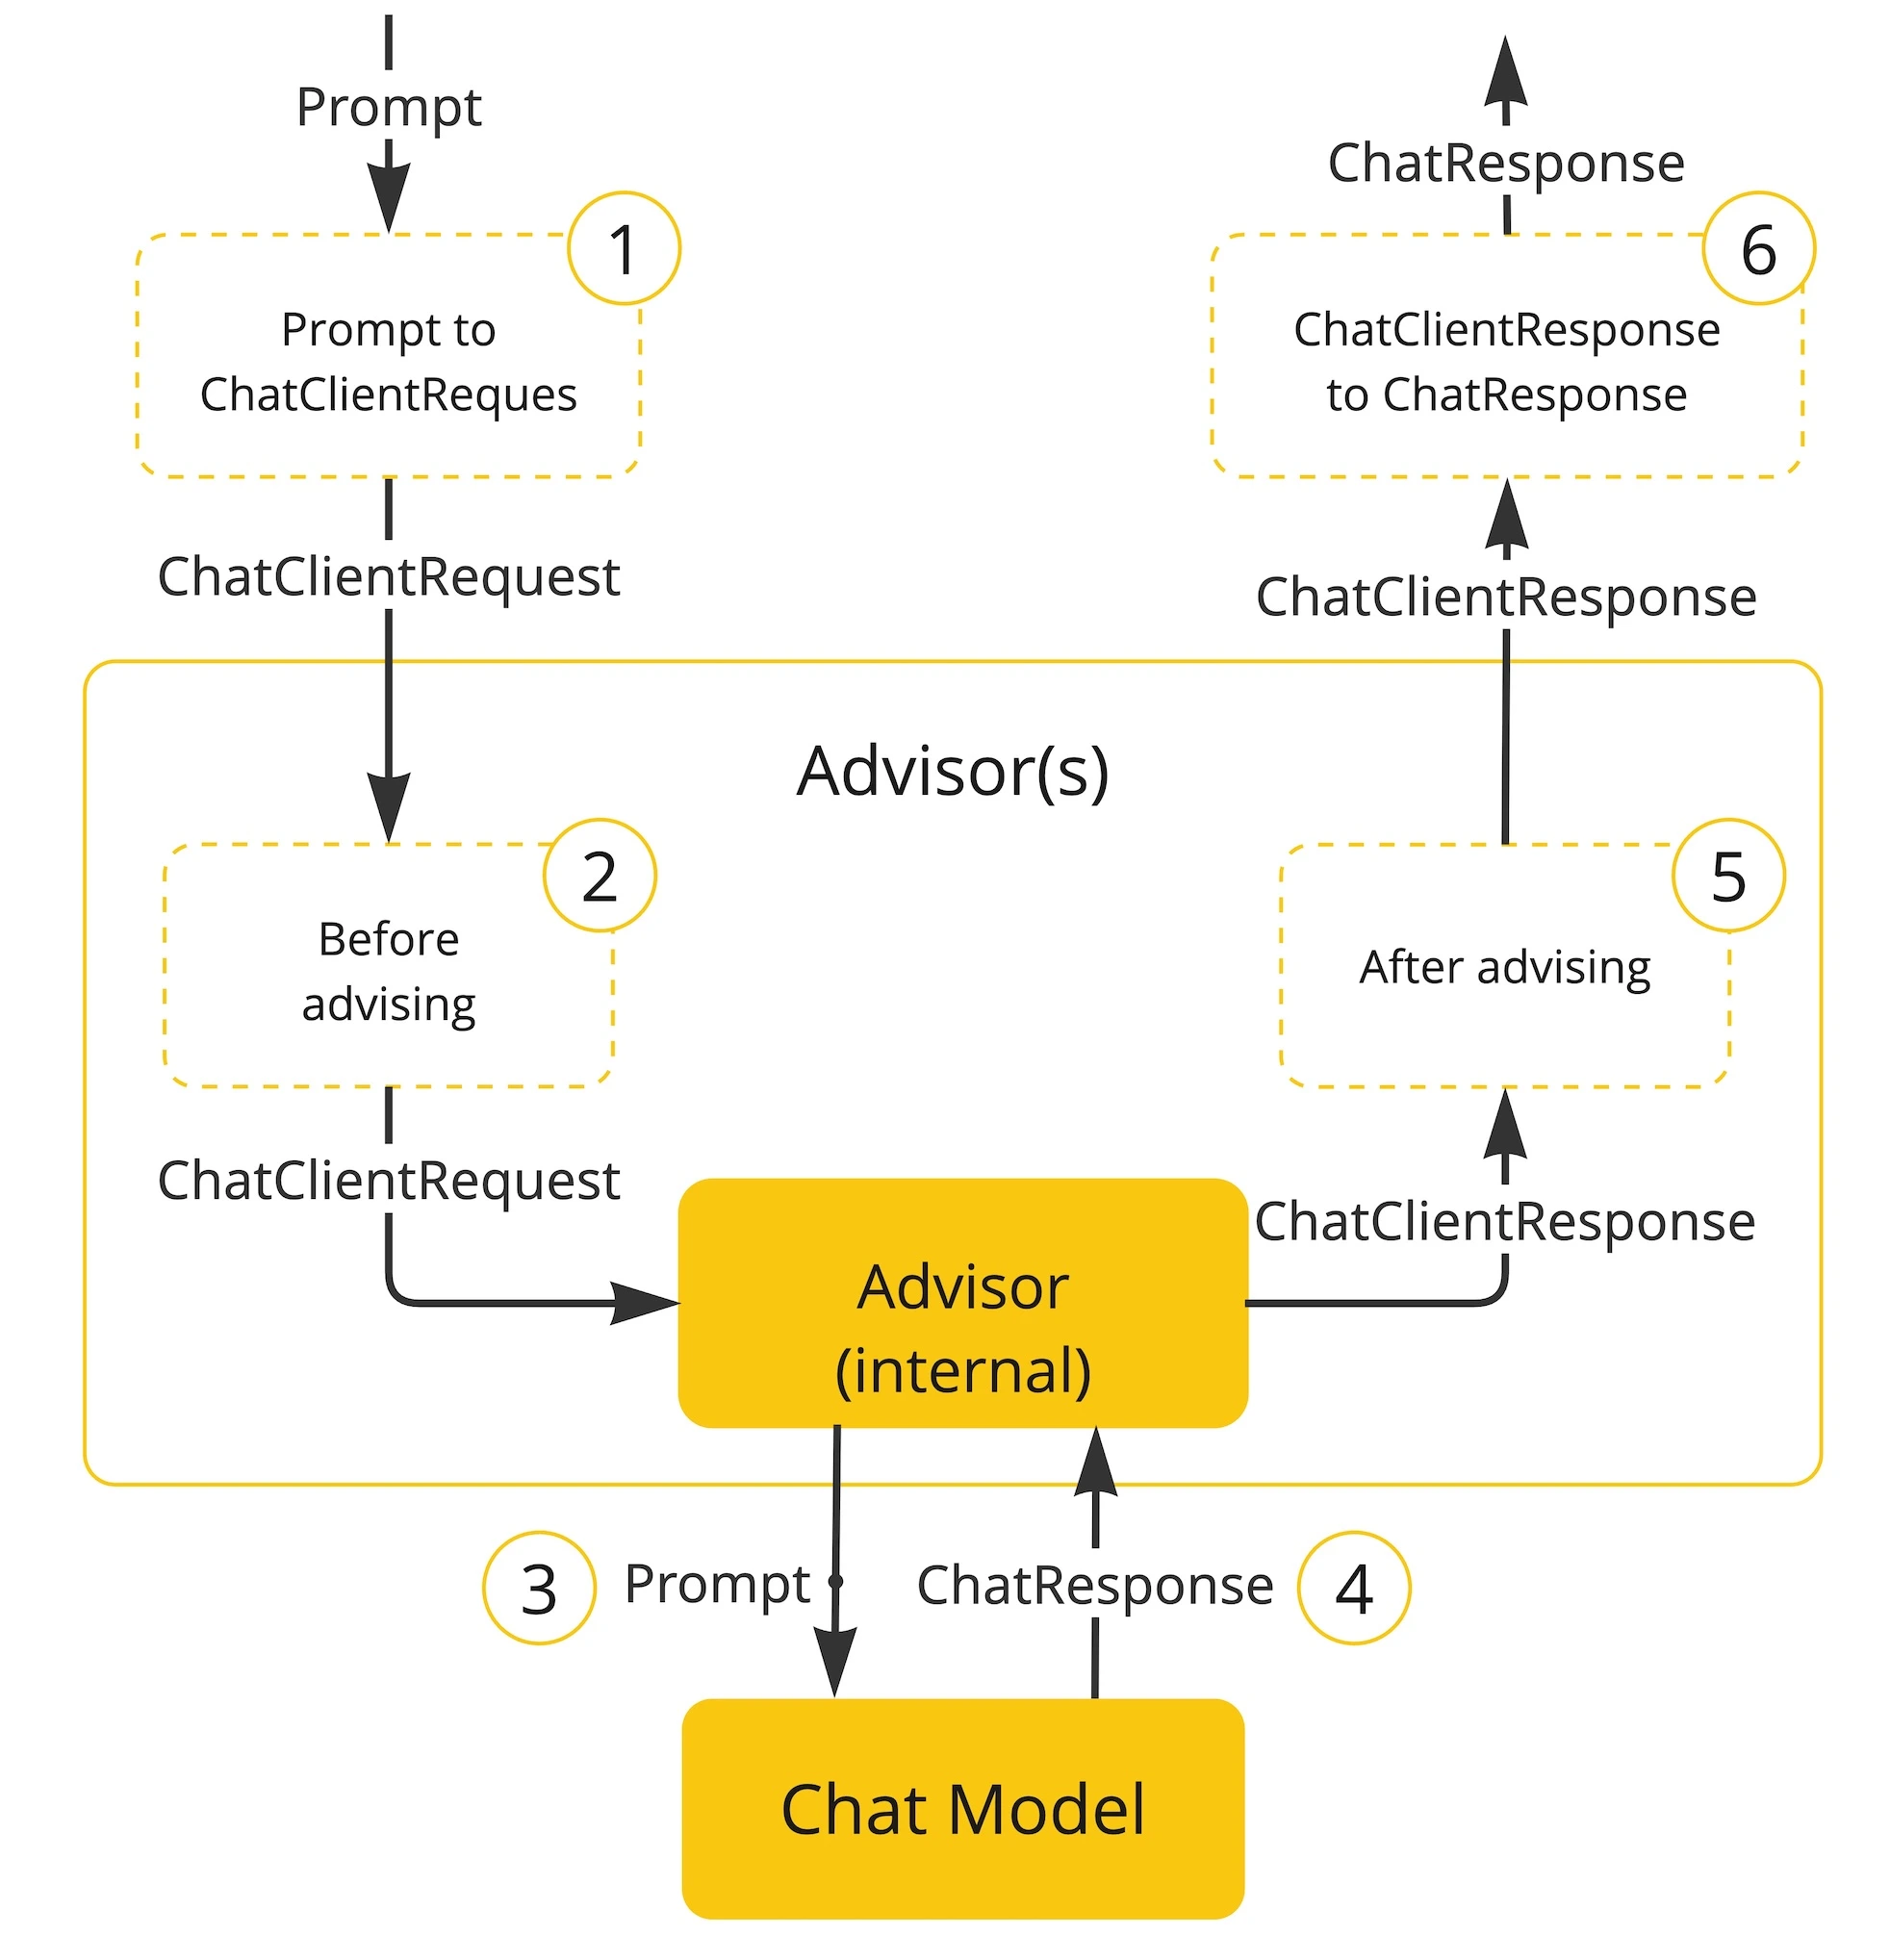
- 用户传入
Prompt,Spring AI 先包装成ChatClientRequest。 - 请求进入 advisor 链,每个 advisor 可以检查、修改、增强请求。
- 最终框架内置的模型调用 advisor 把请求发给
ChatModel。 ChatModel返回ChatResponse。- 响应再倒着穿过 advisor 链,每个 advisor 可以记录、修改或增强响应。
- 最后
ChatClientResponse被转换成用户拿到的content()、chatResponse()或实体对象
本地模型
<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-ollama</artifactId> <version>1.1.0</version> </dependency><dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-autoconfigure-model-ollama</artifactId> <version>1.1.0</version> </dependency>@Autowired@Qualifier("ollamaChatModel")private ChatModel ollamaChatModel;@RestController@RequestMapping("/ai/ollama")public class OllamaChatController {
@Autowired @Qualifier("ollamaChatModel") private ChatModel ollamaChatModel;
@GetMapping("/stream/chat") public Flux<String> streamChat(HttpServletResponse response) { response.setCharacterEncoding("UTF-8"); Flux<ChatResponse> stream = ollamaChatModel.stream(new Prompt("你是谁?")); return stream.map(resp -> resp.getResult().getOutput().getText()); }}LangChain4j
配置
LangChain4j就是一个Java版的LangChain框架
<dependency> <groupId>dev.langchain4j</groupId> <artifactId>langchain4j</artifactId> <version>1.8.0</version></dependency>
<dependency> <groupId>dev.langchain4j</groupId> <artifactId>langchain4j-open-ai-spring-boot-starter</artifactId> <version>1.8.0-beta15</version></dependency>高层次
<dependency> <groupId>dev.langchain4j</groupId> <artifactId>langchain4j-spring-boot-starter</artifactId> <version>1.8.0-beta15</version></dependency>普通对话
只定义一个 Java 接口,LangChain4j 在运行时帮你生成实现类,内部自动完成“组装 Prompt、调用模型、解析结果、处理记忆、工具调用”等流程
@AiServicepublic interface LangChainAiService { String chat(String userMessage);}- @AiService 之后,它会被 Spring 扫描,并注册成一个 Bean
- 被 @AiService标注的接口会自动创建实现类并注册到 Spring 容器中
@Autowiredprivate LangChainAiService aiService;
@RequestMapping("/chat")public String chat(HttpServletResponse response) { response.setCharacterEncoding("UTF-8"); return aiService.chat("日本都有哪些美食?");}流式输出
<dependency> <groupId>dev.langchain4j</groupId> <artifactId>langchain4j-reactor</artifactId> <version>1.8.0-beta15</version></dependency>@AiServicepublic interface LangChainAiService { Flux<String> chatStream(String userMessage);}@GetMapping(value = "/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE)public Flux<String> stream(String msg) { return aiService.chatStream(msg);}普通 String 返回值是“等模型完整回答完再返回”,Flux<String> 是“模型生成一点就返回一点
默认提示词
用 @SystemMessage 和 @UserMessage`给接口方法加默认提示词
@AiServicepublic interface LangChainAiService {
@SystemMessage("你是一个毒舌博主,擅长怼人") @UserMessage("针对用户的内容:{{topic}},先复述一遍他的问题,然后再回答") Flux<String> chatStream(String topic);}@UserMessage(fromResource = "your-prompt-template.txt")String chat(String topic);结构化输出
@AiServicepublic interface LangChainAiService {
@UserMessage("请帮我推荐1本java相关的书") @SystemMessage("你是一个专业的图书推荐人员") Book getBooks();}@RequestMapping("/structure1")public String structure1(HttpServletResponse response) { response.setCharacterEncoding("UTF-8"); Book book = aiService.getBooks(); return book.toString();}对话记忆
@AiServicepublic interface LangChainMemoryAiService {
String chatMemory(@MemoryId String memoryId, @UserMessage String userMessage);}- 如果用了 @MemoryId,就必须配置
ChatMemoryProvider - chatMemoryProvider 根据不同 memoryId 提供不同的 ChatMemory 实例
langChainMemoryAiService = AiServices.builder(LangChainMemoryAiService.class) .chatModel(chatModel) .streamingChatModel(streamingChatModel) .chatMemoryProvider(memoryId -> MessageWindowChatMemory.withMaxMessages(10) ) .build();@RestController@RequestMapping("/langchain")public class LangChainController implements InitializingBean {
private LangChainMemoryAiService langChainMemoryAiService;
@RequestMapping("/memoryChat") public String memoryChat(HttpServletResponse response, String msg, String memoryId) { response.setCharacterEncoding("UTF-8"); return langChainMemoryAiService.chatMemory(memoryId, msg); }
@Override public void afterPropertiesSet() { langChainMemoryAiService = AiServices.builder(LangChainMemoryAiService.class) .chatModel(chatModel) .streamingChatModel(streamingChatModel) .chatMemoryProvider(memoryId -> MessageWindowChatMemory.withMaxMessages(10) ) .build(); }}工具调用
工具调用是让模型在回答前,先判断是否需要调用 Java 方法
@RequestMapping("/toolCalling")public String toolCalling(HttpServletResponse response, String msg) { response.setCharacterEncoding("UTF-8");
LangChainAiService service = AiServices.builder(LangChainAiService.class) .tools(new TemperatureTools()) .chatModel(chatModel) .build();
return service.chat("2025年11月11日,杭州的气温怎样?");}public class TemperatureTools {
@Tool("Get temperature by city and date") public String getTemperatureByCityAndDate(String city, String date) { System.out.println("getTemperatureByCityAndDate invoke..."); return "23摄氏度"; }}按需加载
ToolProvider toolProvider = request -> { if (request.userMessage().singleText().contains("booking")) { ToolSpecification toolSpecification = ToolSpecification.builder() .name("get_booking_details") .description("返回预订详情") .parameters(JsonObjectSchema.builder() .addStringProperty("bookingNumber") .build()) .build();
return ToolProviderResult.builder() .add(toolSpecification, toolExecutor) .build(); }
return null;};Assistant assistant = AiServices.builder(Assistant.class) .chatLanguageModel(model) .toolProvider(toolProvider) .build();@AiService:把接口变成 Spring BeanString 返回值:普通一次性回答Flux<String> 返回值:流式回答,需要 langchain4j-reactor@SystemMessage:系统提示词@UserMessage:用户提示词或模板POJO 返回值:结构化输出@MemoryId + ChatMemoryProvider:多会话隔离记忆.tools(...):固定工具列表.toolProvider(...):按需动态加载工具@AIservice
- 启动时:把接口 Bean 替换成 AiServiceFactory
- 创建时:AiServiceFactory 用 DefaultAiServices 生成 JDK 动态代理
- 调用时:代理拦截接口方法,组装请求,最终调用 ChatModel 或 StreamingChatModel
接口是没法直接实例化的。LangChain4j 把这个接口的 Spring Bean 定义替换掉
@AiService 方法调用 ↓JDK 动态代理 invoke ↓解析方法签名和注解 ↓组装 ChatRequest ↓ChatExecutor 执行 ↓ChatModel.chat ↓返回 String / POJO / Flux持久化记忆
-
@MemoryId区分不同会话
-
ChatMemoryProvider根据 memoryId 创建 ChatMemory
-
MessageWindowChatMemory控制保留最近多少条消息
-
ChatMemoryStore把消息保存到 Redis / MySQL
@AiServicepublic interface LangChainMemoryAiService {
String chatMemory(@MemoryId String memoryId, @UserMessage String userMessage);}public interface ChatMemoryStore {
List<ChatMessage> getMessages(Object memoryId);
void updateMessages(Object memoryId, List<ChatMessage> messages);//这里通常不是“追加一条”,而是“覆盖保存当前窗口内的全部消息 void deleteMessages(Object memoryId); //清空上下文}@Componentpublic class RedisChatMemoryStore implements ChatMemoryStore { private final RedisTemplate<String, String> redisTemplate;
public RedisChatMemoryStore(RedisTemplate<String, String> redisTemplate) { this.redisTemplate = redisTemplate; }
@Override public List<ChatMessage> getMessages(Object memoryId) { String key = buildKey(memoryId); String json = redisTemplate.opsForValue().get(key);
if (json == null || json.isEmpty()) { return Collections.emptyList(); }
return ChatMessageDeserializer.messagesFromJson(json); }
@Override public void updateMessages(Object memoryId, List<ChatMessage> messages) { String key = buildKey(memoryId); String json = ChatMessageSerializer.messagesToJson(messages); redisTemplate.opsForValue().set(key, json); }
@Override public void deleteMessages(Object memoryId) { redisTemplate.delete(buildKey(memoryId)); }
private String buildKey(Object memoryId) { return "langchain4j:chat-memory:" + memoryId; }}langChainMemoryAiService = AiServices.builder(LangChainMemoryAiService.class) .chatModel(chatModel) .chatMemoryProvider(memoryId -> MessageWindowChatMemory.builder().id(memoryId).maxMessages(10).chatMemoryStore(redisChatMemoryStore).build()) .build();Function Calling
-
大模型自己其实不知道实时/外部数据
-
Function Calling = 模型决定要调用哪个函数,并给出参数
-
学会了发起函数调用请求
-
真正执行的是你的程序或框架,比如 LangChain4j / Spring AI
如何定义
方法转成工具
@Configurationpublic class FunctionCallConfiguration { @Bean
@Description("根据用户输入的时区获取该时区的当前时间") public Function<TimeService.Request, TimeService.Response> getTimeFunction(TimeService timeService) { return timeService::getTimeByZoneId; }}-
@Description 告诉模型这个函数能干什么。定义的是工具;
-
Function的定义,他有两个泛型类型参数,分别是T和R
-
T表示这个function的入参,R表示出参
-
需要增加一个清晰的描述,讲清楚这个Function是干什么的,这样才能让模型更好的知道什么时候可以调用这个工具。
@Servicepublic class TimeService { public Response getTimeByZoneId(Request request) { System.out.println("getTimeByZoneId,zoneId=" + request.zoneId); ZoneId zid = ZoneId.of(request.zoneId); ZonedDateTime zonedDateTime = ZonedDateTime.now(zid); DateTimeFormatter formatter = DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss z"); return new Response(zonedDateTime.format(formatter)); }
public record Request(@JsonProperty(required = true, value="zoneId")@JsonPropertyDescription("时区,比如 Asia/Shanghai")String zoneId) {}
public record Response(String time) { }}- 工具的逻辑:模型传入”zoneId”: “Asia/Shanghai”
- ZoneId zid = ZoneId.of(request.zoneId);
- ZonedDateTime zonedDateTime = ZonedDateTime.now(zid);
@RestController@RequestMapping("/function")@Slf4j@RequiredArgsConstructorpublic class FunctionCallController {
@Autowired private OpenAiChatModel chatModel;
private ChatClient chatClient;
@GetMapping("/chat") public String chat(@RequestParam("query") String query) { log.info("chat request => {}", query);
return chatClient.prompt().toolNames("getTimeFunction").user(query).call().content();
}
@PostConstruct public void init() { ChatMemory chatMemory = MessageWindowChatMemory.builder().maxMessages(10).build();
chatClient = ChatClient.builder(chatModel) .defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build()) .build(); }}用户请求 /function/chat?query=上海现在几点-> Controller 收到 query-> chatClient.prompt() 创建一次提示词请求-> toolNames("getTimeFunction") 告诉模型可以用这个函数-> user(query) 放入用户问题-> call() 发起模型调用-> 模型决定调用 getTimeFunction-> Spring AI 执行 TimeService#getTimeByZoneId-> 工具返回当前时间-> 模型生成最终回答-> content() 取出文本结果返回前端自定义工具
- 定义一个工具给LLM用的话,可以直接借助@Tool 注解
- 用@Tool把一个方法声明一个工具,用@ToolParam 来定义每个参数的描述。
@Componentpublic class TimeTools { @Autowired private TimeService timeService;
@Tool(name = "getTimeByZoneId", description = "Get time by zone id") public String getTimeByZoneId(@ToolParam(description = "Time zone id, such as Asia/Shanghai") String zoneId) { System.out.println("getTimeByZoneId,zoneId=" + zoneId); ZoneId zid = ZoneId.of(zoneId); ZonedDateTime zonedDateTime = ZonedDateTime.now(zid); DateTimeFormatter formatter = DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss z"); return zonedDateTime.format(formatter); }}- 方法转工具.toolNames(“getTimeFunction”)调用此方法
- 自定义工具.tools(new TimeTools())调用用此方法
@Service 写真正逻辑交由Spring管理,不代表是AI工具
@Bean Function/@Tool 把它注册成 AI 工具
自动执行
internalToolExecutionEnabled。- 设置为false的话,Spring AI就不会自动调用,需要开发者自己控制工具的调用
- 外部工具调用https://java2ai.com/docs/1.0.0.2/practices/integrations/tool-calling/
ToolCalling
第一步
先把工具注册进去,chatClient.tools(…) 把工具对象交给 Spring AI
this.toolCallbacks.addAll(Arrays.asList(ToolCallbacks.from(toolObjects)));- 把工具对象传给
chatClient.tools(...) ToolCallbacks.from(...)把它们转成一组ToolCallback- Spring AI 后面统一按
ToolCallback去执行
这不是把工具“交给模型”,而是注册给 Spring AI
第二步
Chat Request 里带上 Tool Definition(工具名,工具描述,入参 schema)
-
AI Model 看见这些工具后,决定要不要调用
-
是否要调用工具,并输出工具名和参数;
第三步
如果要调用,模型不会直接执行,而是返回一个 tool call
- 例如:调用哪个工具
- 参数是什么
Spring AI 再检查这个 response 里有没有 tool call,知道springai该调用谁
ToolCall[…, type=function, name=getTimeByZoneId, arguments={“zoneId”:“Asia/Manila”}]
toolExecutionResult = this.toolCallingManager.executeToolCalls(prompt, response);第四步
ToolCall交由 ToolCallingManager找到对应的 ToolCallback 执行工具
ToolCallback = 工具说明 + 工具执行器
ToolCallback 有两个实现(工具入口)
第一个
FunctionToolCallback
多个 builder(...),说明它是把不同函数式对象包装成工具
- 先把模型传来的 JSON 参数转成 Java 对象
- 再直接调用函数
直接持有函数对象,执行时直接 apply
它不是反射,而是函数式回调
第二个
MethodToolCallback
result = this.toolMethod.invoke(this.toolObject, methodArguments);- 持有对象和方法,执行时 Method.invoke(…)
FunctionToolCallback走函数式回调,MethodToolCallback走反射调用- 统一成
ToolCallback,所以调度方式是一致的
第五步
工具执行完,把结果交回给 AI Model
模型结合工具结果,生成最终 Chat Response
MCP
初识
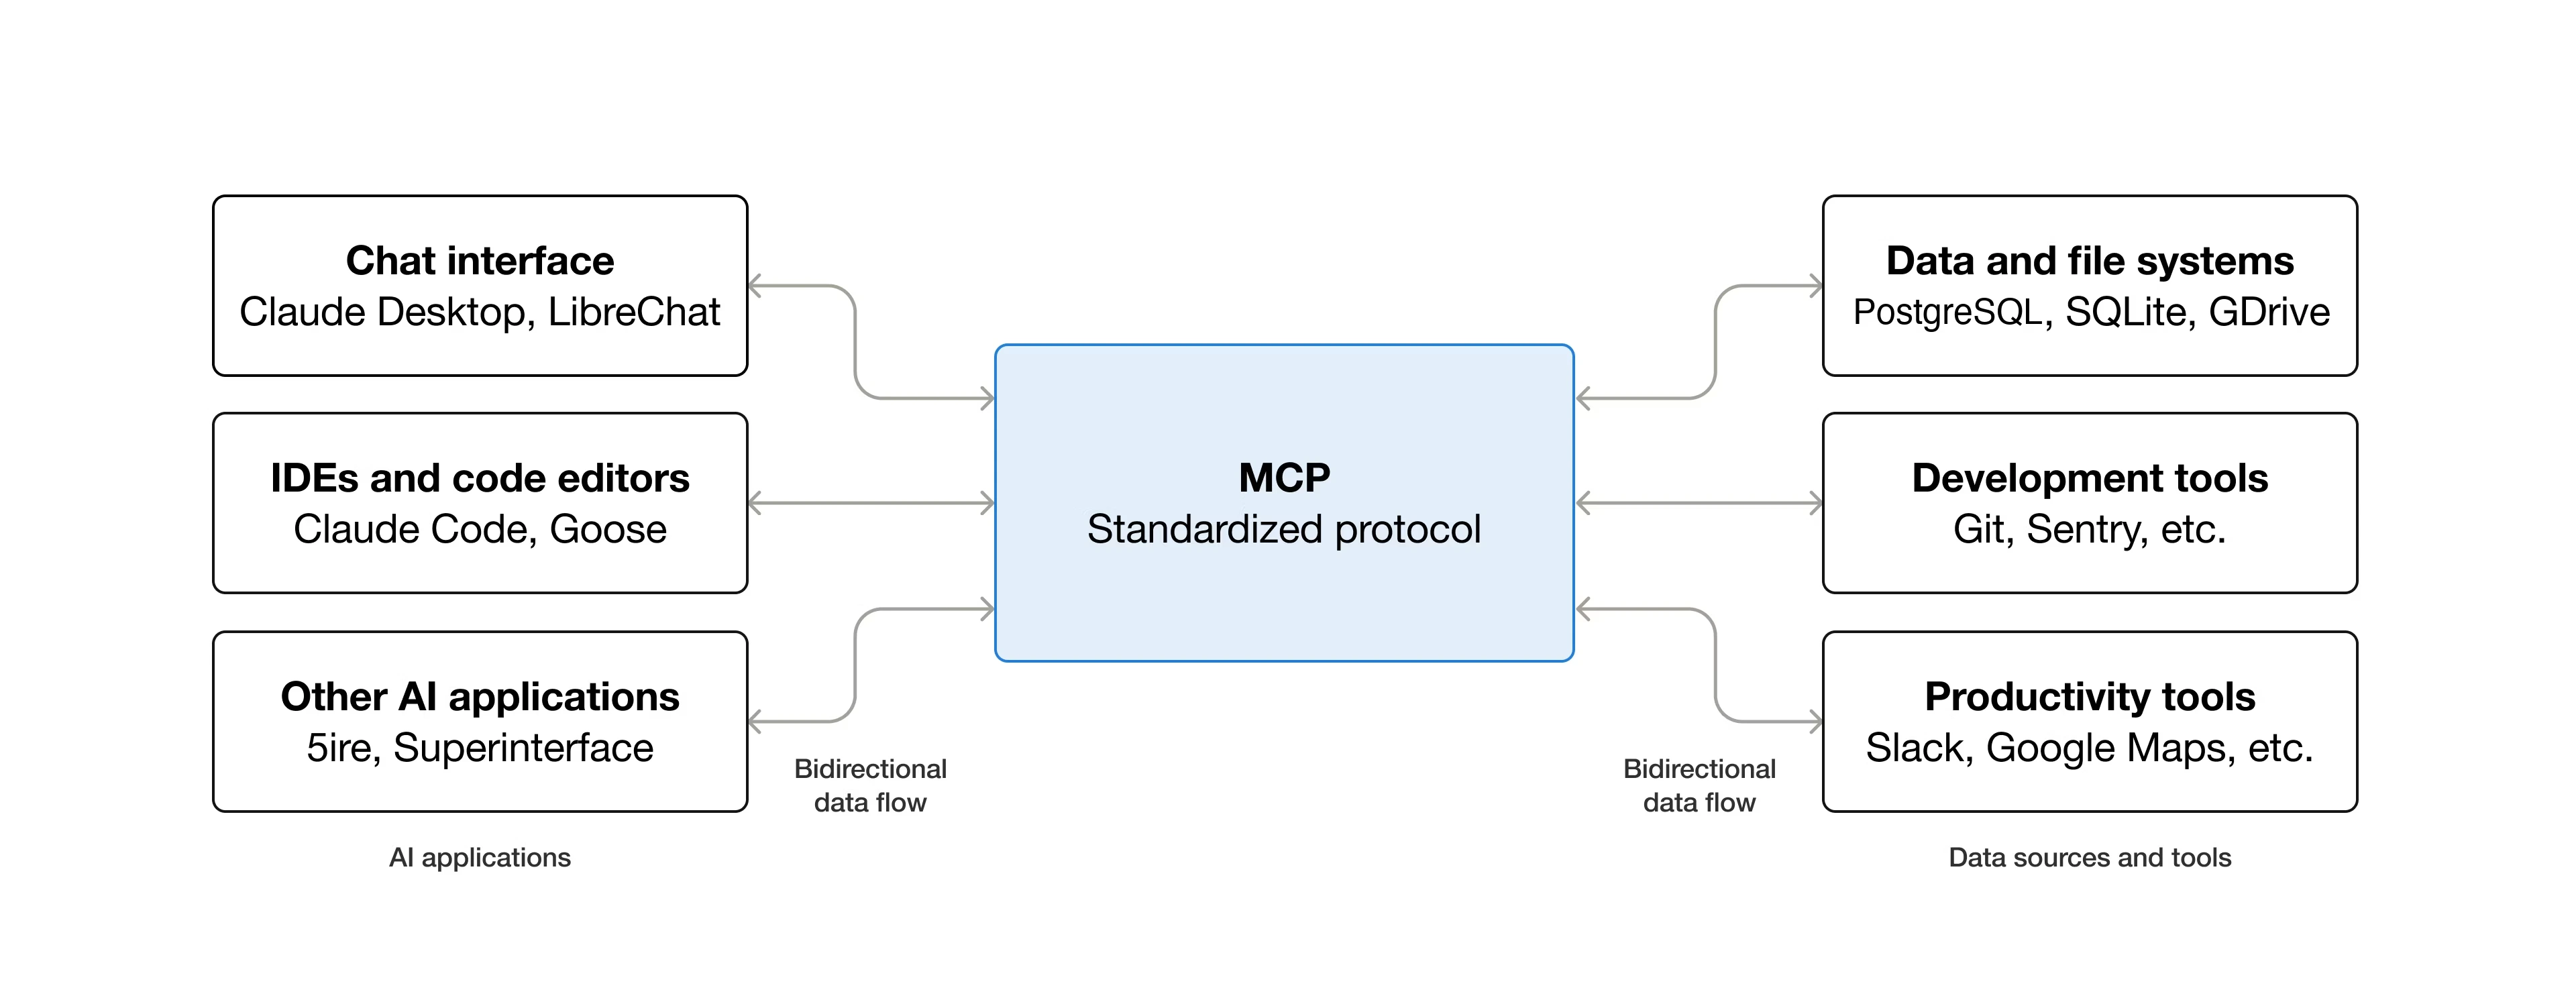
让Agent能接外部世界,协议就能实现一些api调用
无需重复造轮子
- 查天气
- 调交易系统
- 调音乐生成服务
区别
- Function Call 本质上是一种 “硬编码式集成”。每次的工具集成,都是一次完整的开发,不可避免的就回重复造轮子、强耦合。
- Mcp以独立的 MCP Server 暴露能力;Client 负责通过 JSON-RPC 与 Server 进行能力协商与通信扩展性
工作流程
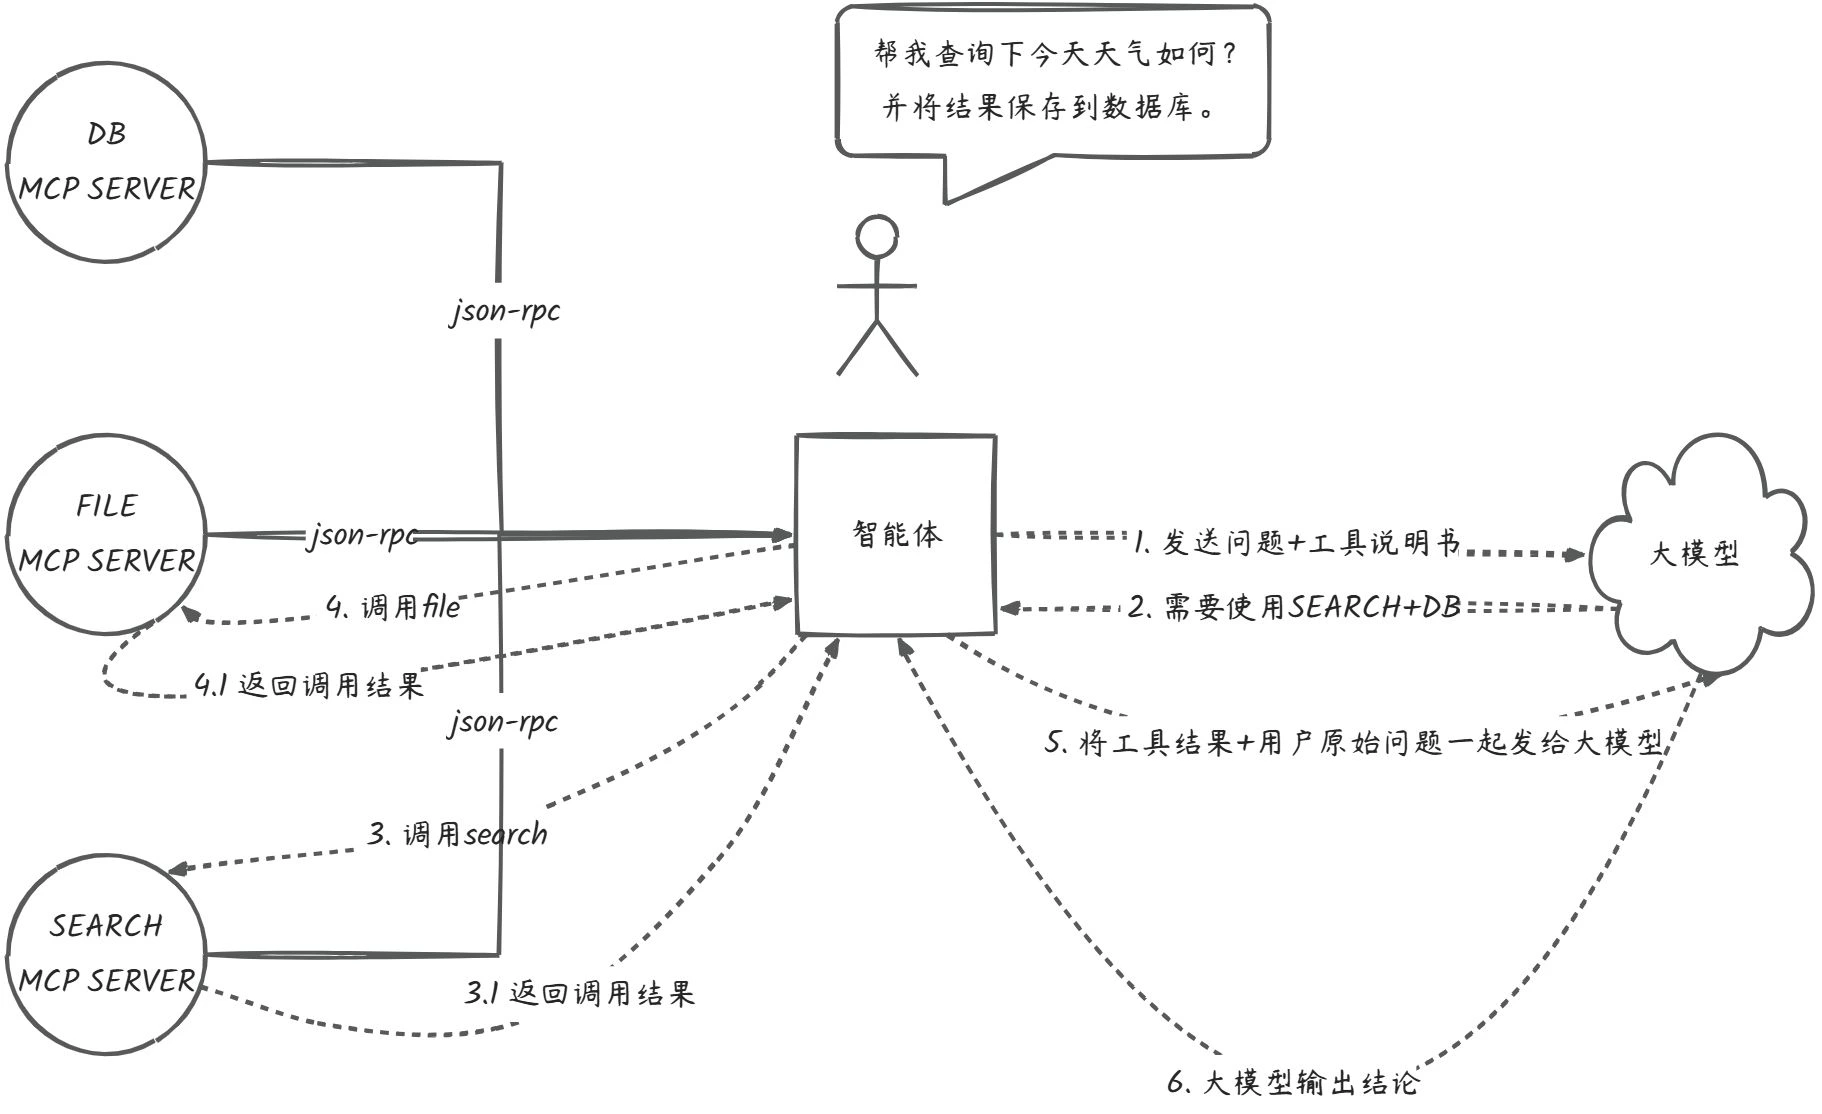
初始化(工具说明获取)
- 智能体初始化的时候,会通过 MCP 协议向所有连接的 MCP Server 使用JSON-RPC 协议请求工具说明书。
- MCP Server 负责提供并确保这些说明书是标准化的JSON格式。
第二阶段:决策(大模型规划)
- 将用户的原始问题和获取到的所有标准化工具说明,发送给大模型。
- 大模型根据这些信息进行规划,并返回一个清晰的工具调用指令。
第三阶段:调用(执行与结果回传)
- 通过 MCP 协议请求对应的 MCP Server 执行工具操作。
- MCP Server 完成实际的工具逻辑(如数据库查询),并将原始执行结果返回给智能体。
第四阶段:总结(生成最终回复)
- 将用户原始问题+工具执行的最终结果+完整的对话历史,再次发回给大模型。
- 大模型基于这个结果进行总结,生成一段自然语言回复,输出给用户。
Function Call 需要由应用自行构造工具说明并封装工具实现逻辑,
MCP 将工具说明与工具执行逻辑都封装成独立的外部服务
技术原理
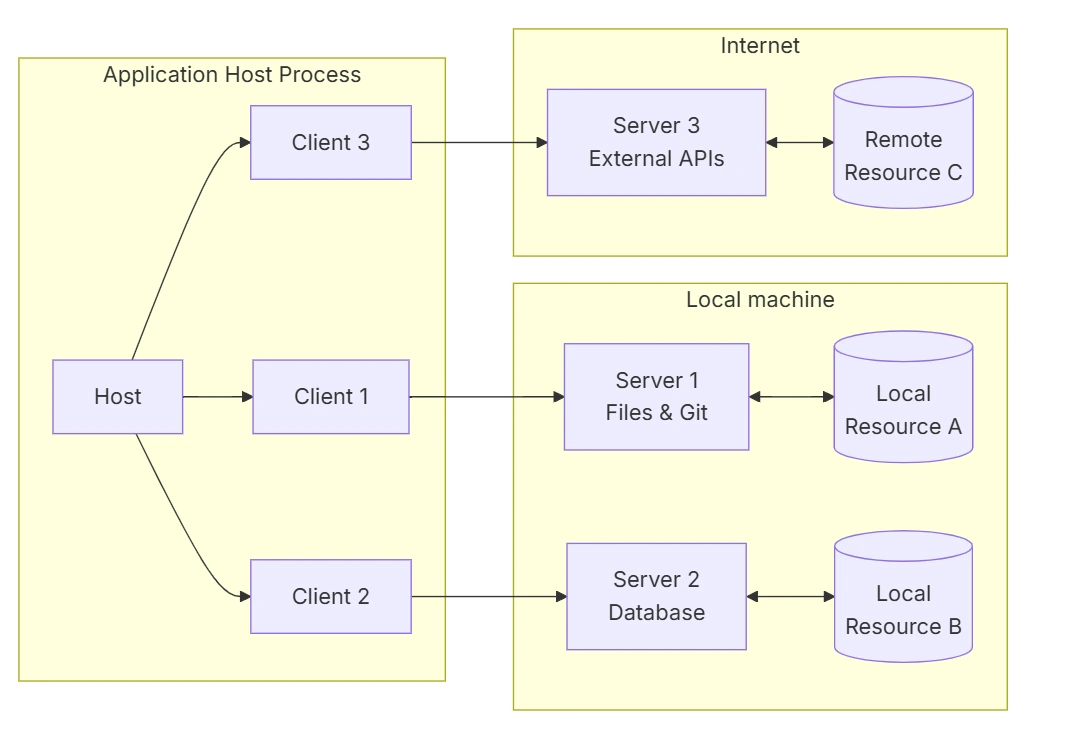
智能体作为客户端,向外部的 MCP Server 去请求能力;工具不再属于智能体,而属于独立的 Server
它不是一个 SDK,也不是一个框架,而是一种协议约定
MCP 的本质是一种能力协商标准,而不是一种调用技术
client 和 server 是一对一的,而 host 中则可以接入多个 client 用于实现智能体的能力扩展。
MCP 则是由两层标准化组成:
数据层:
-
用 JSON-RPC 2.0 统一所有交互格式
-
智能体先
initialize建立连接,再用tools/list获取工具说明书,最后用tools/call触发执行 -
如果工具列表变了,还会收到
notifications/tools/list_changed。这样一来,智能体不需要理解每个工具的内部实现,只要看统一描述就能发现、选择和调用。 -
所有工具都必须用统一的格式描述自己——包括工具名、使用说明、参数结构、返回格式等
传输层
定义了客户端和服务器之间进行数据交换的通信机制和通道,包括特定于传输的连接建立、消息帧和授权。
-
Stdio:本地进程间通信,最快,适合本地客户端和本地 Server。
-
SSE:旧的远程方案,服务端可以推消息,但读写分离,比较笨重。
-
Streamable HTTP:新的主流方案,用一个 HTTP 端点支持流式双向通信,更适合现代云环境
| 传输方式 | 技术原理 | 传输特点 | 核心优势 | 典型应用场景 |
|---|---|---|---|---|
| Stdio(标准输入输出) | 父子进程间通信,Host fork 子进程,数据通过 stdin/stdout 流动 | 下行:Host -> Server(stdin) 上行:Server -> Host(stdout) 错误:Server -> Host(stderr) | 生命周期绑定、无网络开销、延迟极低 | 本地客户端(如 Cursor)、本地智能助手、高性能本地工具集成 |
| SSE(Server-Sent Events,旧) | HTTP 长连接,Server 主动推送消息,Client 通过 POST 发送请求 | 接收通道:GET /sse,长连接 发送通道:POST /messages,短连接 | 可远程通信,支持服务端推送 | 远程工具调用,HTTP/1.1 环境下需服务端主动推送消息 |
| Streamable HTTP(新) | HTTP POST 流式传输,JSON-RPC 数据分块发送 | 单一连接:POST /mcp Server 使用分块传输(Chunked Encoding)返回响应 | 简化架构、双向异步、资源效率高、易恢复、兼容标准 HTTP 基础设施 | 远程工具调用,替代 SSE,支持双向异步通知和流式结果 |
MCPServer
Studio
- Stdio 模式通过标准输入输出与客户端通信
- 服务器启动后直接在控制台读写 JSON-RPC 消息,
- 适合本地轻量化工具或无需网络的场景,要求控制台输出完全干净,保证客户端能够正确解析消息。
<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-starter-mcp-server-webmvc</artifactId></dependency>- 要求你的程序运行时,控制台输出必须是纯 JSON(JSON-RPC)
- 不能有任何多余字符,所以必须关闭 web、关闭 banner、关闭所有日志输出。否则智能体只要解析 stdout 就会报错。
spring: main: web-application-type: none banner-mode: off ai: mcp: server: name: mcp-server version: 1.0.0 stdio: true enabled: true type: SYNC
logging: level: root: OFF工具类
把工具定义和执行逻辑放到同一个方法上
@Servicepublic class WeatherService {
@Tool(description = "根据城市名称查询天气信息") public String getWeather(String city) { if (city == null) { return "请提供城市名称"; } return switch (city) { case "北京" -> "北京: 晴, 25°C"; case "上海" -> "上海: 多云, 22°C"; case "深圳" -> "深圳: 小雨, 28°C"; default -> city + ": 下雪, -20°C"; }; }}将MCP工具注入到ToolCallbackProvider之中
@Beanpublic ToolCallbackProvider weatherTools(WeatherService weatherService) { // 自动扫描 WeatherService 中带有 @Tool 注解的方法 return MethodToolCallbackProvider.builder() .toolObjects(weatherService).build();}在Cline中配置 java jar 启动
{ "mcpServers": {"weather-stdio": {"disabled": false, "timeout": 60,"type": "stdio", "command": "java","args": [ "-jar", "D:\\LLMentor\\LLMentor\\mcp\\mcp-server-stdio\\target\\mcp-server-stdio-1.0.0-SNAPSHOT.jar" ] } }}HttpSSE
SSE(Server-Sent Events)模式基于 HTTP,采用双端点架构
- sse-message-endpoint 是 MCP Client 用来向服务器发送请求、调用工具的接口,客户端通过约定的 JSON-RPC 协议将参数传入并获取响应。
- sse-endpoint 是 MCP Client 用来监听服务器主动推送消息的通道,比如工具列表更新、状态变更等。
- 二者配合构成了 MCP SSE 的核心通信机制,使客户端既能主动发起操作,也能实时接收服务器推送的变化,实现双向互动和高效协作
server: port: 8003
spring: application: name: mcp-weather-sse ai: mcp: server: enabled: true name: weather-sse-server version: 1.0.0 type: SYNC capabilities: tool: true resource: false prompt: false completion: false sse-message-endpoint: /mcp/messages # 客户端发送消息的HTTP endpoint ("写信发消息") sse-endpoint: /sse # 客户端订阅SSE的endpoint ("听收音机")通过localhost<8003>/sse返回响应数据以json
id:aef80411-4d14-4d18-b8d4-74b1017a69f6event:endpointdata:/mcp/messages?sessionId=aef80411-4d14-4d18-b8d4-74b1017a69f6- /mcp/messages?sessionId=aef80411-4d14-4d18-b8d4-74b1017a69f6
- 利用这个地址发送消息,8003
进行初始化
{ "jsonrpc": "2.0", "id": 1, "method": "initialize", "params": { "protocolVersion": "2024-11-05", "capabilities": { "roots": { "listChanged": true }, "sampling": {}, "elicitation": {} }, "clientInfo": { "name": "ExampleClient", "title": "Example Client Display Name", "version": "1.0.0" } }}告诉客户端已完备
{ "jsonrpc": "2.0", "method": "notifications/initialized"}获取工具说明书
{ "jsonrpc": "2.0", "method": "tools/list", "params": {}, "id": 100}执行工具
"jsonrpc": "2.0", "method": "tools/call", "params": { "name": "get_weather", "arguments": { "city": "Beijing" } }, "id": 101}StreamHttp
单一 HTTP 端点实现请求发送与流式响应接收,支持 断续重连和未确认消息重发,
server: port: 8004 servlet: encoding: charset: UTF-8 force: true enabled: true
spring: application: name: mcp-weather-streamable ai: mcp: server: ## 这个地方改成STATELESS,就是无状态模式 protocol: STREAMABLE name: streamable-mcp-server version: 1.0.0 type: SYNC ###定义 MCP Server 的提示词,指导模型行为 instructions: "这个服务是用来查询城市天气的。" resource-change-notification: true tool-change-notification: true prompt-change-notification: true streamable-http: ####一个端口就可以实现双向通信 mcp-endpoint: /api/mcp ####保证长连接稳定。 keep-alive-interval: 30s无状态
- 在内存中保存客户端会话,也不会分配或要求 Mcp-Session-Id
- 每个请求都是独立处理的,服务器不会记录多轮对话历史或流式事件状态
- 适合单次调用,纯POST请求,而不是SSE请求来调用
有会话
先初始化可能返回SSE 流或者普通的 JSON 响应,Header里设置text/event-stream,application/json
响应:Mcp-Session-Id用于记忆。以后
Spring AI 的mcp server同样支持pojo类作为入参和出参。
@Tool( name = "query_weather_by_city&date", description = "根据城市和日期获取天气信息")public WeatherResponse queryWeather(WeatherRequest request) { try { // 模拟调用api Thread.sleep(10000); } catch (InterruptedException e) { throw new RuntimeException(e); } double temp = Math.random() * 15 + 10; return new WeatherResponse( request.getCity(), request.getDate(), request.getI(), request.getS(), "晴朗,有微风", temp );@Datapublic class WeatherRequest { @ToolParam(description = "城市") private String city;
@ToolParam(description = "日期") private String date;
@ToolParam(description = "区县") private String i;
@ToolParam(description = "街道") private String s;}@ToolParam 来说明参数的值
MCPClient
配置
传统web项目直接无脑用 webmvc 即可,追求响应式编程的可以使用 webflux二选一
<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-starter-mcp-client</artifactId></dependency><dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-starter-mcp-client-webflux</artifactId></dependency>spring: ai: mcp: client: enabled: true #开启 MCP 客户端自动装配 name: my-mcp-client version: 1.0.0 request-timeout: 60s type: SYNC #同步客户端 stdio: connections: weather-stdio: command: java args: - -jar - "D:\\LLMentor\\LLMentor\\mcp\\mcp-server-stdio\\target\\mcp-server-stdio-1.0.0-SNAPSHOT.jar" sse: connections: weather-sse: url: http://127.0.0.1:8003 sse-endpoint: /sse streamable-http: connections: weather-streamable: url: http://127.0.0.1:8004/stream/test/ endpoint: api/mcp- spring.ai.mcp.client.enabled: true 开启 MCP 客户端自动装配
- type: SYNC 说明这里要的是同步客户端
自动注入
McpSync
- Spring Boot 读取 spring.ai.mcp.client.*
- 自动创建对应的 MCP 传输层和 McpSyncClient
- 初始化时和 Server 做握手,拿到 server info 和工具清单
- Spring 把这些客户端收集起来,供你注入 List
或SyncMcpToolCallbackProvider` SyncMcpToolCallbackProvider再把工具包装成ToolCallback[]ChatClient通过这些 callback 间接调用 MCP 工具
public McpSchema.CallToolResult callTool(String type) { String toolName = "getWeather"; #### 工具参数 Map param = new HashMap(); param.put("city", "北京");
####遍历List<McpSyncClient>里面是客户端(Serverinfo和工具清单) for (McpSyncClient client : mcpSyncClients) {
####### 识别当前连的是哪个 server McpSchema.Implementation clientInfo = client.getClientInfo(); McpSchema.Implementation serverInfo = client.getServerInfo(); log.info("clientInfo: {}", JSON.toJSONString(clientInfo)); log.info("serverInfo: {}", JSON.toJSONString(serverInfo));
try { if (clientInfo.title().contains(type)) { log.info("开始调用mcp服务");
########组装 CallToolRequest McpSchema.CallToolRequest request = McpSchema.CallToolRequest.builder().name(toolName).arguments(param).build();
######直接 client.callTool(request) McpSchema.CallToolResult result = client.callTool(request); log.info("callTool result: {}", result); return result; } } catch (Exception ex) { ex.printStackTrace(); } } return null; }Chat
- SyncMcpToolCallbackProvider注入到chatclient中MCP接入
- MCP 工具先被转换成 ToolCallback[]
ChatClient构建时绑定这些工具.builder()- 用户提问后,模型先判断要不要调用工具
- 如果要调用,Spring AI 代为执行 MCP 工具
- 工具结果再回灌给模型生成最终回答
@Autowiredprivate SyncMcpToolCallbackProvider toolCallbackProvider;
@PostConstructpublic void init() {里 ToolCallback[] toolCallbacks = toolCallbackProvider.getToolCallbacks(); this.chatClient = ChatClient.builder(chatModel) .defaultToolCallbacks(toolCallbacks) .build();}原理
McpSyncClient是怎么来的
- spring.ai.mcp.client.type=SYNC
- 触发 McpToolCallbackAutoConfiguration
- 里面构建 SyncMcpToolCallbackProvider
McpSyncClient又来自McpClientAutoConfiguration- 具体 transport 由
NamedClientMcpTransport组织 - stdio / sse / streamable 各自有自己的自动配置去读 properties 并创建 transport
SyncMcpToolCallbackProvider
- SyncMcpToolCallbackProvider不是一个具体工具,而是一个工具提供者。
- 它内部可以管理多个 McpSyncClient,每个 McpSyncClient责连接一个 MCP Server
- 当
ChatClient需要工具列表时,会调用 SyncMcpToolCallbackProvider#getToolCallbacks(), - Provider 就会遍历所有 MCP Client,分别调用 listTools()获取远程工具列表,
- 把每个远程工具都包装成一个 SyncMcpToolCallback
SyncMcpToolCallback
-
SyncMcpToolCallback = 把 MCP Client 变成 Spring AI 工具的适配器
-
McpSyncClient = 真正连 MCP Server 的客户端
-
mcpClient.callTool(…) 调远程 MCP Server
-
ToolCallback = ChatClient 能识别的工具格式
SyncMcpToolCallbackProvider中的getToolCallbacks()
getToolCallbacks()
- 读取已经初始化好的 McpSyncClient
- 为每个 client 生成一个 SyncMcpToolCallback
- 返回 ToolCallback[]
@Autowiredprivate SyncMcpToolCallbackProvider mcpTools;
@Beanpublic ChatClient chatClient(ChatModel chatModel) { return ChatClient.builder(chatModel) .defaultTools(mcpTools) .build();}ChatClient 调 MCP
ChatClient.builder(chatModel).defaultTools(…)把工具注册进 DefaultChatClient
- .call()或.stream()进入DefaultChatClient先构建 advisor chain
- ToolCallingAdvisor 自动接管工具循环
- 进入 OpenAiChatModel.internalCall()
- 先发一次模型请求
- 模型返回后,检查是否有 tool_calls
- 如果有,就进入工具执行流程
- DefaultToolCallingManager.executeToolCalls()
- 从 toolcallback 的 toolmetadata 中获取这个 returnDirect的
- 最终会走到 toolCallback.call(…)
- 也就是又回到 SyncMcpToolCallback.call()
- 执行结果写回 `ToolResponseMessage
- 工具结果回灌给模型,必要时递归再问一次模型
先问模型 -> 模型决定要不要调用工具 -> 框架执行工具 -> 工具结果回给模型 -> 模型组织最终回复为什么要递归?
- 只要工具结果,不需要总结
- 工具执行完,还要模型把结果整理成自然语言
internalCall() 里会判断
returnDirect == true:直接返回工具结果- 否则把
conversationHistory拼回去,再递归调用模型
SSE重连
SSE 模式下 MCP Client 断线后不会自动恢复,要自己做一层重连机制
McpSyncClient的ping()做心跳检测,失败后重新 buildClient() + initialize(),并且重建 ChatClient
- 项目启动的时候先初始化一次,如果初始化失败,就会启动一个后台重试线程,不停地尝试重新初始化。
- 利用一个定时任务,做心跳检测,可以每隔 5 秒 ping 一次 MCP Server。并且使用了原子标记,只会启动一个重试线程,不会出现重复创建多个任务的情况。
- 重试线程会一直循环重连,连成功了就自动停止。这样一来,无论是网络抖一下还是服务器重启,客户端都能自动恢复。
@Service@Slf4jpublic class RetrySSEMcpServer {
@Autowired private OpenAiChatModel chatModel;
private ChatClient chatClient;
private McpSyncClient sseClient;
// 是否正在重试 initialize(保证唯一性) private final AtomicBoolean retrying = new AtomicBoolean(false);
// initialize 重试线程 private final ExecutorService retryExecutor = Executors.newSingleThreadExecutor();
@PostConstruct public void init() { log.info("Initializing SSE MCP Client...");
// 初始化 SSE Client this.sseClient = buildClient();
//调用 initialize() 和 MCP Server 建立会话 try { this.sseClient.initialize(); log.info("SSE MCP client initialized."); } catch (Exception e) { log.error("Initial SSE initialize failed, will rely on retry thread.", e);
// 启动重试线程 startRetryInitialize(); }
// 初始化 toolcallback(收集已初始化的 McpSyncClient) SyncMcpToolCallbackProvider provider = SyncMcpToolCallbackProvider.builder() .mcpClients(List.of(this.sseClient)) .build();
//把 MCP 工具转换成 ToolCallback ToolCallback[] callbacks = provider.getToolCallbacks();
this.chatClient = ChatClient.builder(chatModel) .defaultToolCallbacks(callbacks) .defaultTools() .build(); }- SyncMcpToolCallbackProvider 主要负责收集已初始化的 McpSyncClient
- getToolCallbacks() 时把这些客户端的工具能力转换成 ToolCallback,供 ChatClient 使用。
- SSE Transport -> McpSyncClient -> SyncMcpToolCallbackProvider -> ToolCallback[] -> ChatClient
/** * 定时任务:每 5 秒 ping 一次 SSE * ping 不通则触发 initialize 重试线程 */ @Scheduled(fixedDelay = 5000) public void pingSse() { log.info("SSE MCP ping..."); if (sseClient == null) { log.warn("SSE client not initialized yet."); startRetryInitialize(); return; } try { sseClient.ping(); log.debug("SSE MCP ping OK."); } catch (Exception e) { log.error("SSE MCP ping failed: {}", e.getMessage()); startRetryInitialize(); } }@EnableScheduling启动类添加
//客户端转为toolBack
private McpSyncClient buildClient() { HttpClientSseClientTransport transport = HttpClientSseClientTransport .builder("http://127.0.0.1:8003") .sseEndpoint("/sse") .build();
return McpClient.sync(transport) .clientInfo(new io.modelcontextprotocol.spec.McpSchema.Implementation("sse-client", "1.0")) .requestTimeout(Duration.ofSeconds(10)) .build(); }
//定时任务
//启动 initialize 重试线程 // 是否正在重试 initialize(保证唯一性) private final AtomicBoolean retrying = new AtomicBoolean(false);
private void startRetryInitialize() { // 保证只启动一个重试线程 if (!retrying.compareAndSet(false, true)) { return; }//只有第一个线程能把 retrying 从 false 改成 true,后面的全部直接返回。这样就保证同一时间只有一个重连任务。
//单线程 retryExecutor.submit(() -> { log.warn("Start retrying SSE MCP initialize...");
while (true) { try { // 重建 sseClient this.sseClient = buildClient(); this.sseClient.initialize(); log.info("SSE MCP re-initialized successfully.");
// chatclient 也同样需要重建 SyncMcpToolCallbackProvider provider = SyncMcpToolCallbackProvider.builder() .mcpClients(List.of(this.sseClient)) .build();
ToolCallback[] callbacks = provider.getToolCallbacks();
this.chatClient = ChatClient.builder(chatModel) .defaultToolCallbacks(callbacks) .defaultTools() .build();
retrying.set(false); return; } catch (Exception e) { log.warn("Retry initialize failed, will retry in 10s. Reason: {}", e.getMessage()); }
try { Thread.sleep(10000); } catch (InterruptedException e) { throw new RuntimeException(e); } } });
}
public String chat(String userMessage) { return chatClient.prompt() .user(userMessage) .call() .content(); }}- McpSyncClient需要重新初始化,我们的Chatclient也同样需要初始化
- ChatClient 内部的 ToolCallback 是在初始化时注入的。
- ToolCallback 绑定的 McpSyncClient 是旧的,会话已断开。即使你重新初始化了 sseClient,ChatClient 没有同步更新,仍然会继续调用旧的客户端。
改为Https
Server
HTTP 属于明文传输协议
生成自签名CA证书
//如果有重复生成,请先执行删除keytool -delete -alias local-ssl -keystore keystore.p12 -storepass 123456
//生成p12服务器证书(包含公私钥)keytool -genkeypair -alias local-ssl -keyalg RSA -keysize 2048 -storetype PKCS12 -keystore keystore.p12 -validity 3650 -storepass 123456 -keypass 123456 -dname "CN=localhost, OU=Dev, O=Demo, L=Local, ST=Local, C=CN" -ext "SAN=IP:127.0.0.1,DNS:localhost" -ext "BasicConstraints=ca:true"会生成一个 keystore.p12 证书文件,我们将其放入到项目的resources
server: port: 8443 ssl: key-store: classpath:keystore.p12 key-store-password: 123456 key-store-type: PKCS12 key-alias: local-ssl enabled: trueClient
public static void createSecureHttpsClient(String baseUrl, String endpoint, String caCertPath) { try { // 1. 加载 CA 证书 CertificateFactory cf = CertificateFactory.getInstance("X.509"); FileInputStream fis = new FileInputStream(caCertPath); Certificate caCert = cf.generateCertificate(fis); fis.close();
// 2. 创建 KeyStore 并导入 CA KeyStore ks = KeyStore.getInstance(KeyStore.getDefaultType()); ks.load(null, null); ks.setCertificateEntry("caCert", caCert);
// 3. 构建 TrustManagerFactory TrustManagerFactory tmf = TrustManagerFactory.getInstance(TrustManagerFactory.getDefaultAlgorithm()); tmf.init(ks);
// 4. 创建 SSLContext SSLContext sslContext = SSLContext.getInstance("TLS"); sslContext.init(null, tmf.getTrustManagers(), new java.security.SecureRandom());
// 5. 使用默认 Hostname 验证 HttpClient.Builder httpClient = HttpClient.newBuilder() .connectTimeout(Duration.ofSeconds(30)) .sslContext(sslContext);
// 6. 构建 SSE Transport HttpClientSseClientTransport transport = HttpClientSseClientTransport.builder(baseUrl) .sseEndpoint(endpoint) .clientBuilder(httpClient) .build();
// 7. 初始化 MCP Client McpSyncClient mcp = McpClient.sync(transport).build(); mcp.initialize(); System.out.println("生产环境 MCP Client 初始化成功");
} catch (Exception e) { throw new RuntimeException("创建 Secure MCP Client 失败", e); }}keytool -exportcert -alias local-ssl -keystore keystore.p12 -storetype PKCS12 -storepass 123456 -rfc -file mcp-server.crt实现鉴权
传输安全和访问控制。
- 传输安全:通过 HTTPS 确保数据在传输过程中不被窃取或篡改。
- 访问控制:通过认证和鉴权机制(如请求头携带 Bearer Token),防止工具被任意调用。
本地服务通过环境变量 KEY 来区分访问权限,远程服务可能会重复覆盖
- 服务端用 Spring 拦截器校验
Authorization请求头, - 客户端通过 MCP Transport 的
requestBuilder给请求加上Authorization: Bearer xxx,这样远端 MCP 的 SSE 或 Streamable 通信就能沿用传统 Web 服务的 token 认证机制。
context-path
- 本质上就是改访问入口路径
context-path会改变服务端真实访问路径,而 MCP Client 在拼接baseUrl + endpoint时非常依赖斜杠规则。多一个/或少一个/,最终 URL 就可能被拼错,导致404
context-path: /stream/testHttpClientStreamableHttpTransport transport = HttpClientStreamableHttpTransport.builder("http://127.0.0.1:8004/stream/test/") .endpoint("api/mcp") .build();Client 端 baseUrl 以 / 结尾,endpoint 不以 /`开头
server: servlet: context-path: /test
spring: ai: mcp: server: protocol: SSE sse-endpoint: /sse sse-message-endpoint: /mcp/messages base-url: /testSSE + context-path<建议加> base-url
跳过工具结果总结
多智能体协作
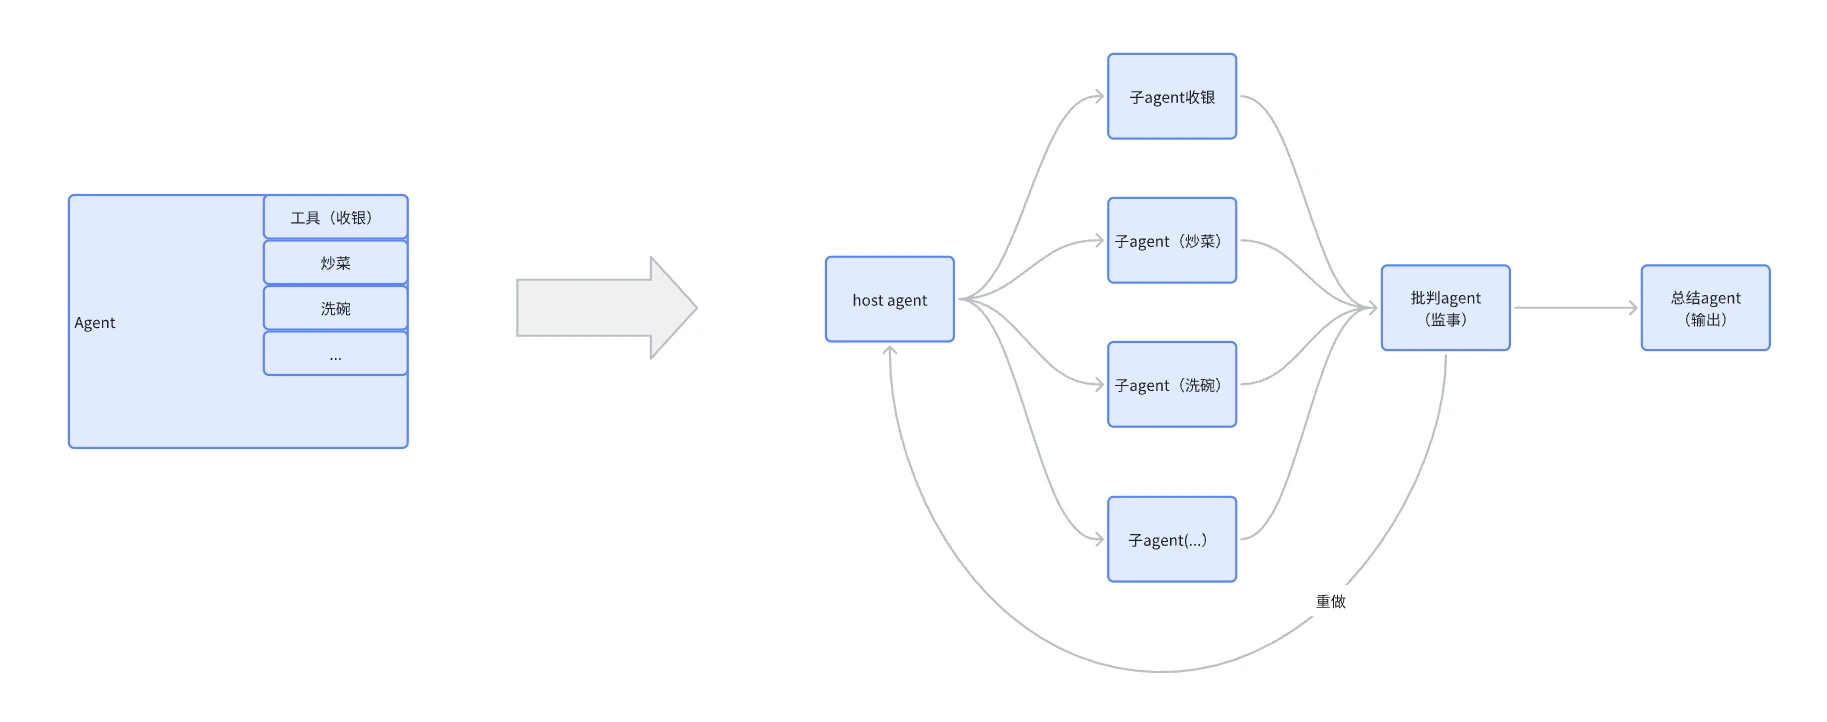
只需要获取到结果就好,在最终总结的时候,将这些中间结果一起抛给最后一个总结智能体中
returnDirect
@Tool(description = "根据城市名称查询天气信息",returnDirect = true)public String getWeather(String city) { if (city == null) { return "请提供城市名称"; } return switch (city) { case "北京" -> "北京: 晴, 25°C"; case "上海" -> "上海: 多云, 22°C"; case "深圳" -> "深圳: 小雨, 28°C"; default -> city + ": 下雪, -20°C"; };}- DefaultToolCallingManager 的 executeToolCall 方法
- 从 toolcallback 的 toolmetadata 中获取这个 returnDirect的
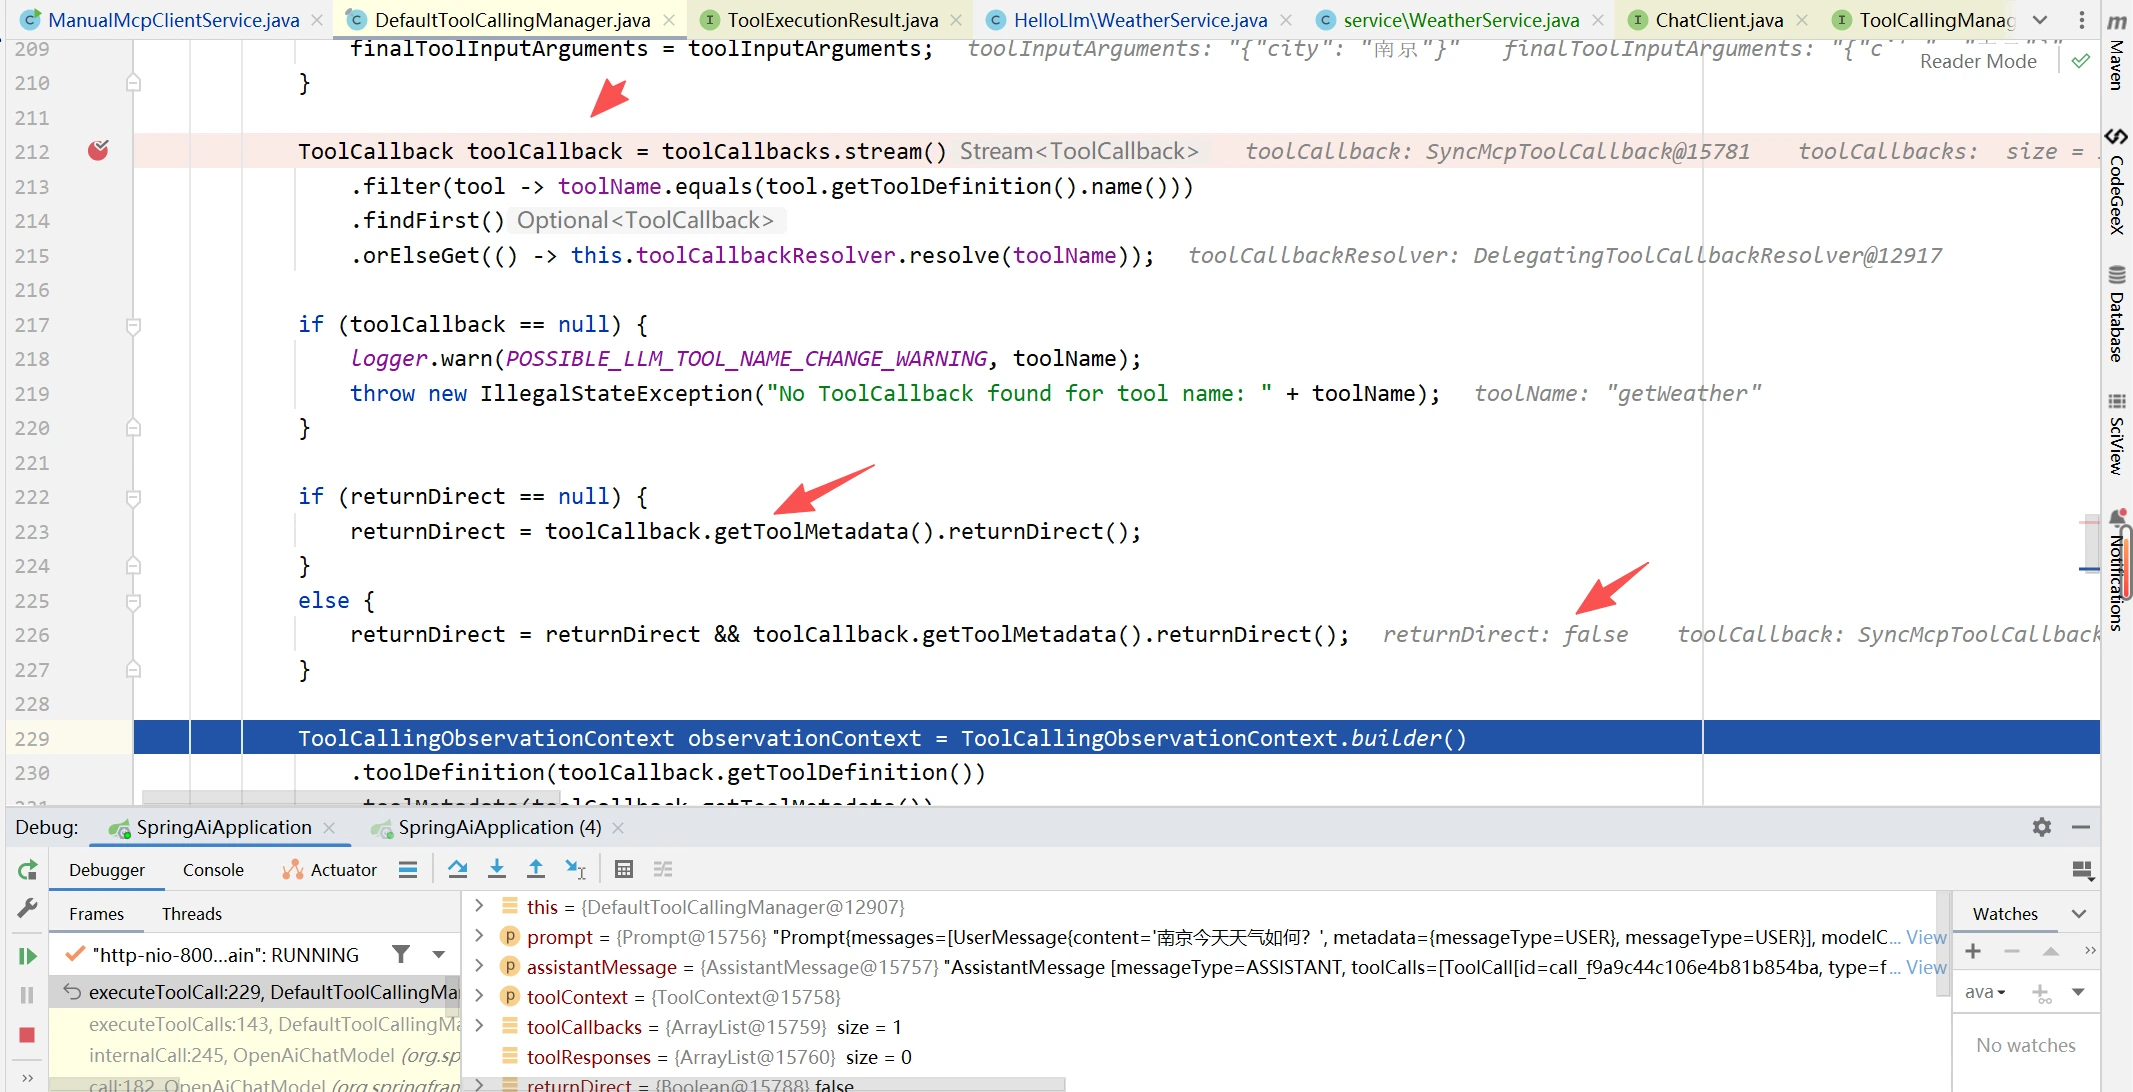
接口toolcallback实现类SyncMcpToolCallback和Function Call
- ToolCallback默认元数据里 returnDirect
是false - SyncMcpToolCallback 没有把 MCP Server 端的这个配置传回来
- 所以
DefaultToolCallingManager看到的还是false
MCP 场景下,returnDirect 目前不生效;但传统 Function Call 场景是可以生效的。
this.chatClient = ChatClient.builder(chatModel)// .defaultToolCallbacks(callbacks) .defaultTools(new WeatherService()) .build();如果你想让 MCP 也跳过总结,就得自己继承并改造:
- SyncMcpToolCallback
- SyncMcpToolCallbackProvider
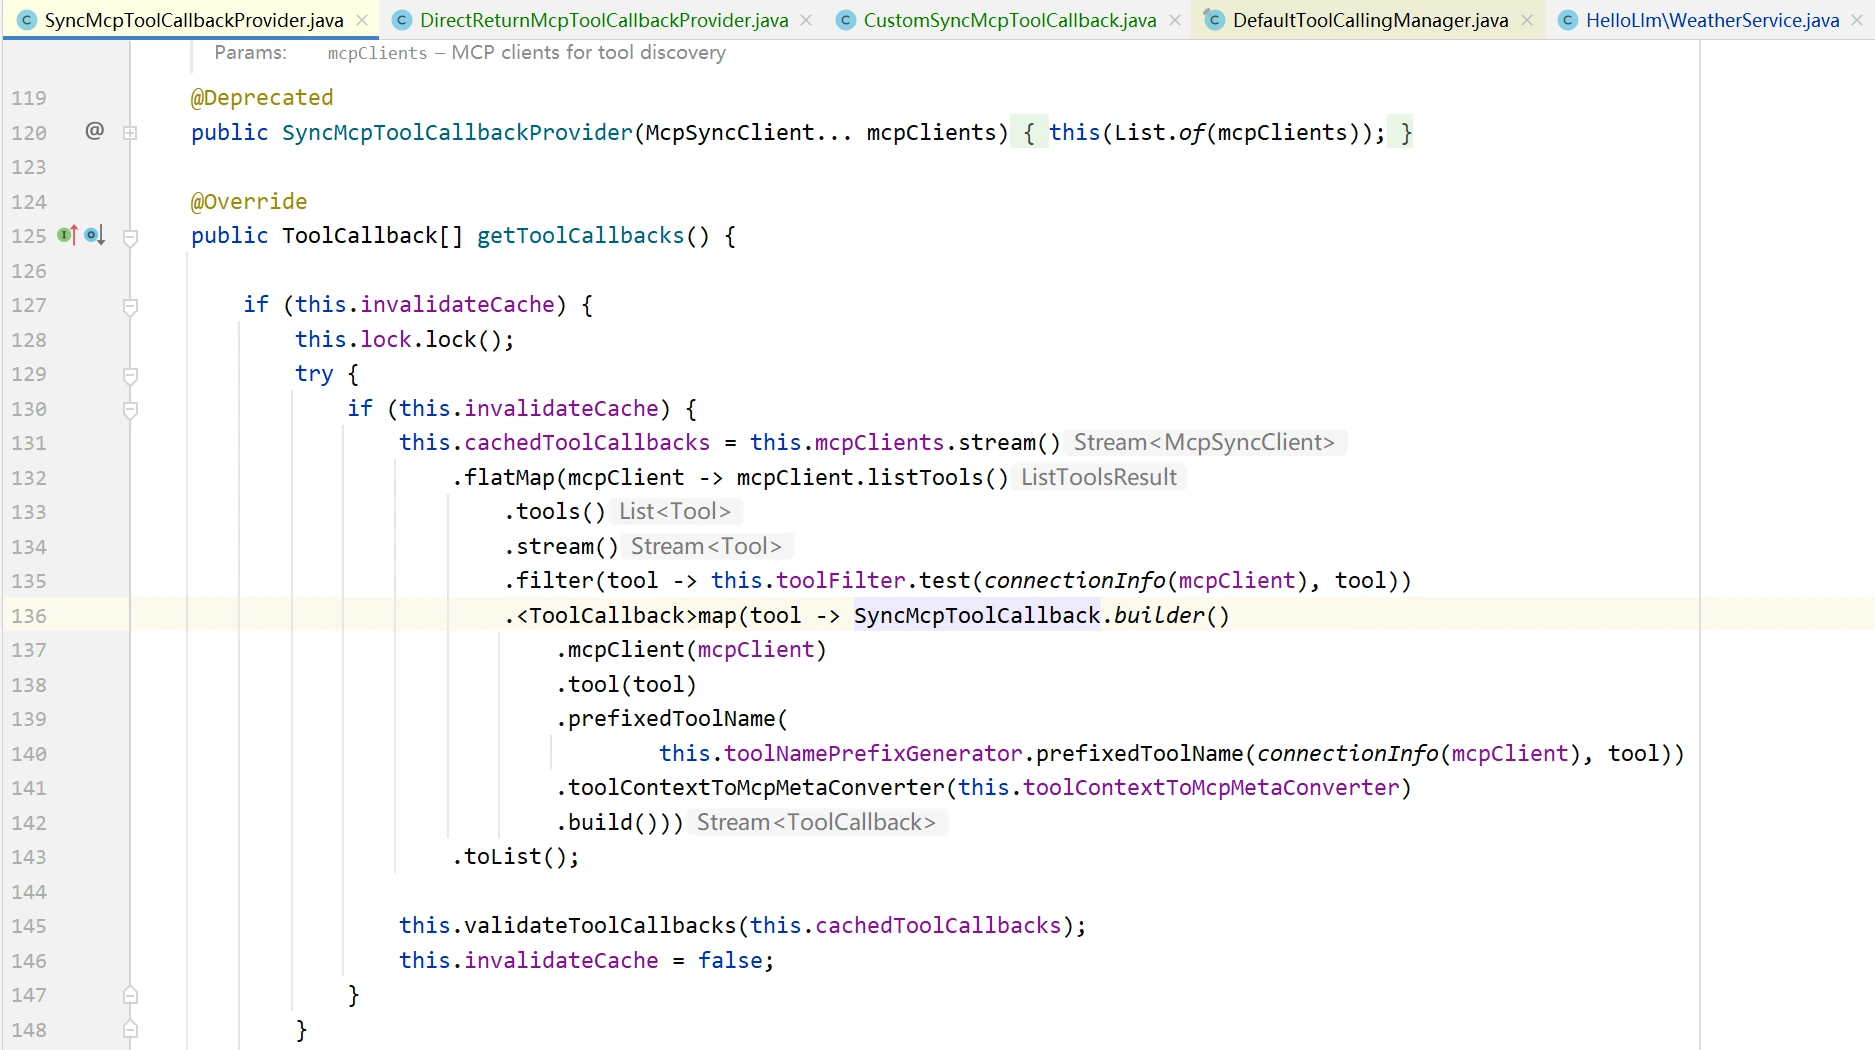
public class ReturnDirectSyncMcpToolCallback extends SyncMcpToolCallback {
private final boolean returnDirect;
public ReturnDirectSyncMcpToolCallback(McpSyncClient client, McpSchema.Tool tool, boolean returnDirect) { super(client, tool); this.returnDirect = returnDirect; }
@Override public ToolMetadata getToolMetadata() { return ToolMetadata.builder() .returnDirect(returnDirect) .build(); }}@Slf4jpublic class DirectReturnMcpToolCallbackProvider extends SyncMcpToolCallbackProvider {
private final List<McpSyncClient> mcpClients; private boolean returnDirect;
public DirectReturnMcpToolCallbackProvider(List<McpSyncClient> mcpClients, boolean returnDirect) { super(mcpClients); this.mcpClients = mcpClients; this.returnDirect = returnDirect; }
@Override public ToolCallback[] getToolCallbacks() { var toolCallbacks = new ArrayList<>();
for (McpSyncClient mcpClient : mcpClients) { List<McpSchema.Tool> toolList = Collections.emptyList();
try { toolList = mcpClient.listTools().tools(); } catch (Exception e) { // 跳过该 MCP,继续处理其它的 continue; }
for (var tool : toolList) { toolCallbacks.add(new CustomSyncMcpToolCallback(mcpClient, tool, returnDirect)); } } var array = toolCallbacks.toArray(new ToolCallback[0]); validateToolCallbacks(array); return array; }
private void validateToolCallbacks(ToolCallback[] toolCallbacks) { List<String> duplicateToolNames = ToolUtils.getDuplicateToolNames(toolCallbacks); duplicateToolNames.forEach(s -> log.info("tool name found: {}", s)); if (!duplicateToolNames.isEmpty()) { throw new IllegalStateException( "Multiple tools with the same name (%s)".formatted(String.join(", ", duplicateToolNames))); } }}DirectReturnMcpToolCallbackProvider callbackProvider = new DirectReturnMcpToolCallbackProvider(clients,true);
this.chatClient = ChatClient.builder(chatModel) .defaultToolCallbacks(callbackProvider) .build();工具过滤
MCP Server 往往会包含大量工具
SyncMcpToolCallbackProvider 中就有这个 McpToolFilter 来控制要不要构建 SyncMcpToolCallback。
McpToolFilter 是继承于 BiPredicate。
- **boolean test(T t, U u)**接收两个输入参数(类型 T 和 U),返回一个 boolean 值
- 第一个参数是连接信息 McpConnectionInfo,第二个参数是具体工具
McpTool - 返回
true,工具保留 ,返回 false,工具就过滤
Spring AI 这边的默认行为是全放行。
@Service@Slf4jpublic class WeatherService {
@Tool(name = "weatherQueryByCity", description = "根据城市名称查询天气信息") public String getWeatherByCity(String city) { if (city == null) return "请提供城市名称"; return switch (city) { case "北京" -> "北京: 晴, 25°C"; case "上海" -> "上海: 多云, 22°C"; case "深圳" -> "深圳: 小雨, 28°C"; default -> city + ": 下雪, -20°C"; }; }
@Tool(name = "weatherForecast", description = "查询未来天气预报") public String getWeatherForecast(String city) { if (city == null) return "请提供城市名称"; return city + ": 明天多云,后天有小雨。"; }
@Tool(name = "weatherAlert", description = "获取城市天气预警信息") public String getWeatherAlert(String city) { if (city == null) return "请提供城市名称"; return city + ": 暴雨黄色预警,注意安全。"; }
@Tool(name = "climateIndex", description = "查询城市气候指数") public String getClimateIndex(String city) { return city + ": 舒适度 72/100,相对湿度 65%。"; }}- ,给工具增加name属性
- 其中3个方法的name以weather打头,另外一个方法则不是,用于区分过滤效果。
HttpClientStreamableHttpTransport streamableTransport = HttpClientStreamableHttpTransport.builder("http://127.0.0.1:8004/stream/test/").endpoint("api/mcp").build();McpSyncClient streamableClient = McpClient.sync(streamableTransport) .clientInfo(new io.modelcontextprotocol.spec.McpSchema.Implementation("streamable-client", "1.0")) .requestTimeout(Duration.ofSeconds(10)) .build();streamableClient.initialize();
List<McpSyncClient> clients = List.of(streamableClient);
SyncMcpToolCallbackProvider provider = SyncMcpToolCallbackProvider.builder() .mcpClients(clients) // 关键过滤方法 .toolFilter((conn, tool) -> tool.name().startsWith("weather")) .build();
ToolCallback[] callbacks = provider.getToolCallbacks();
this.chatClient = ChatClient.builder(chatModel) .defaultToolCallbacks(callbacks) .build();RAG
RAG出现原由
让agent拥有你想要的知识
LLM的问题:
-
不知道你私有数据
-
容易幻觉
-
无法实时更新
-
LLM的知识停留在训练时刻,无法回答私有领域问题。RAG通过检索外部知识库为LLM补充实时、精准的上下文,使其回答有据可依。
构建索引
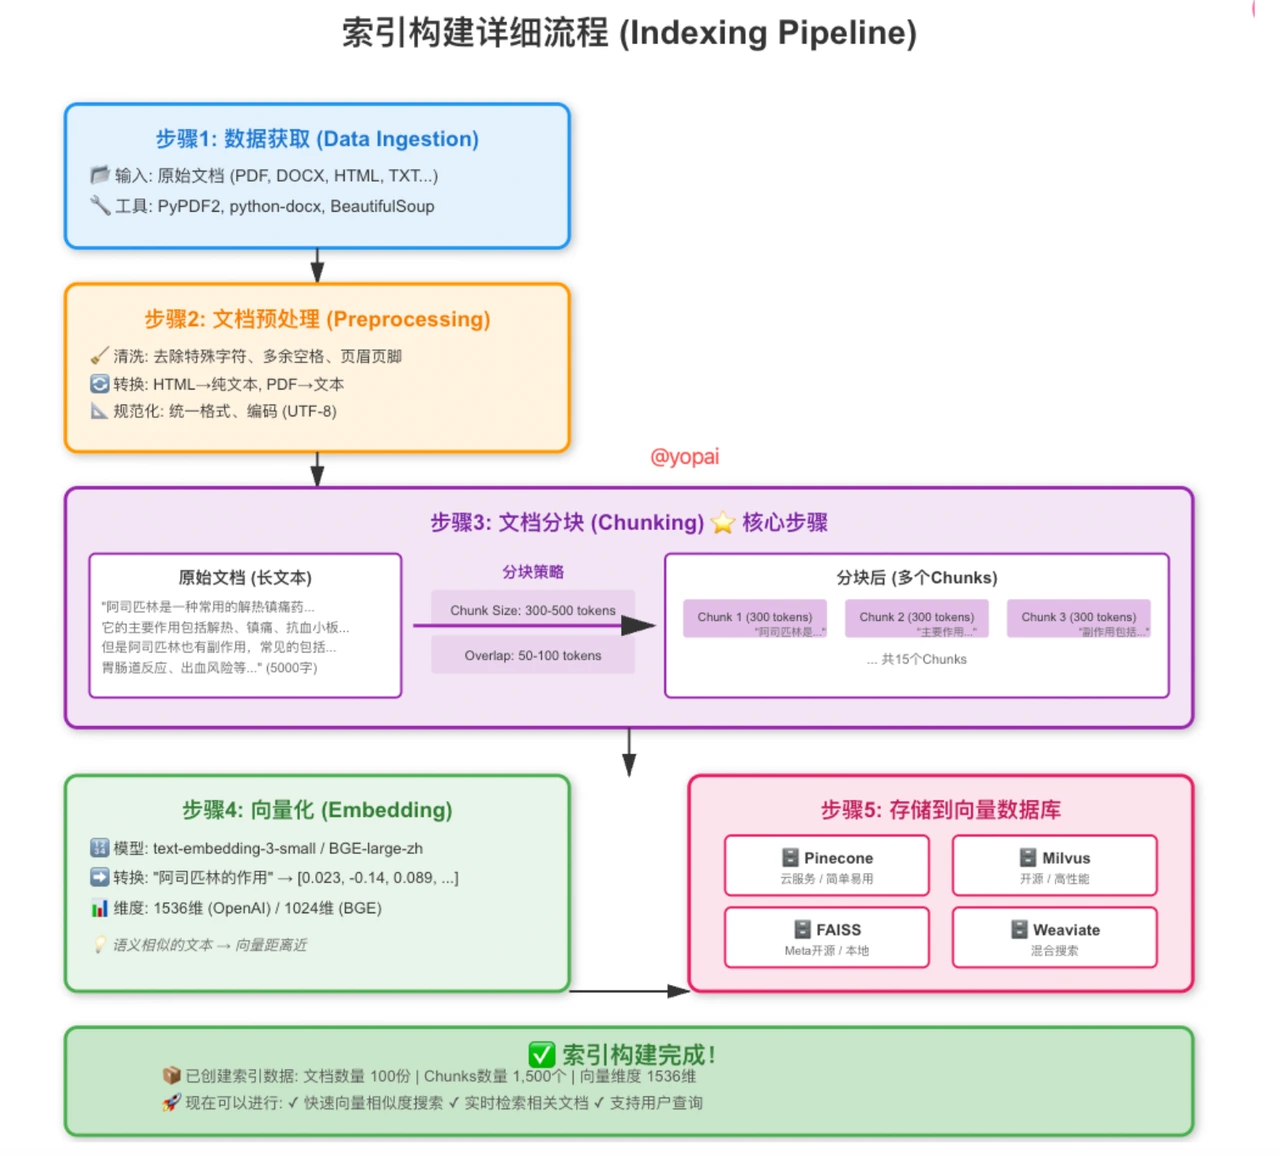
预处理文档
让后续的“分片”和“向量化”能够在干净的数据上进行,从源头上保证知识库索引的质量。
文档读取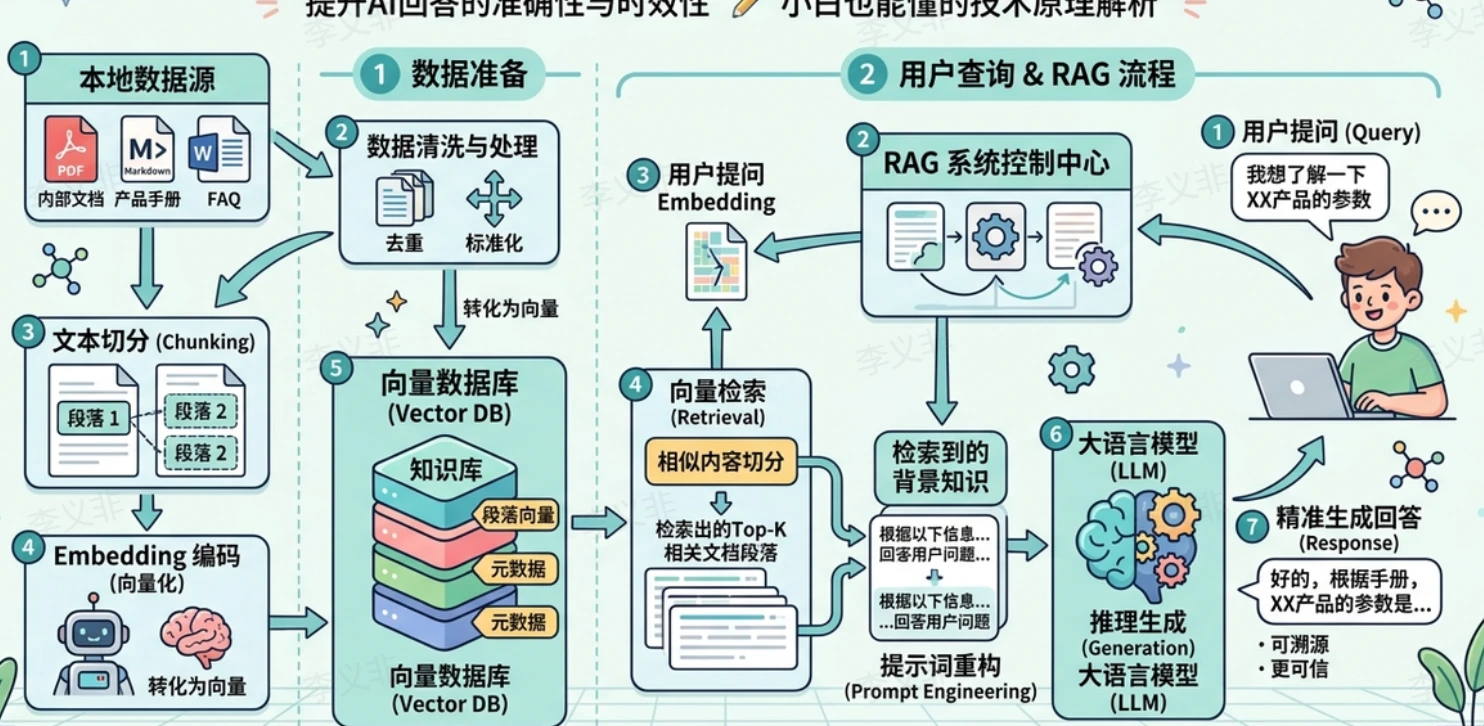
image.webp
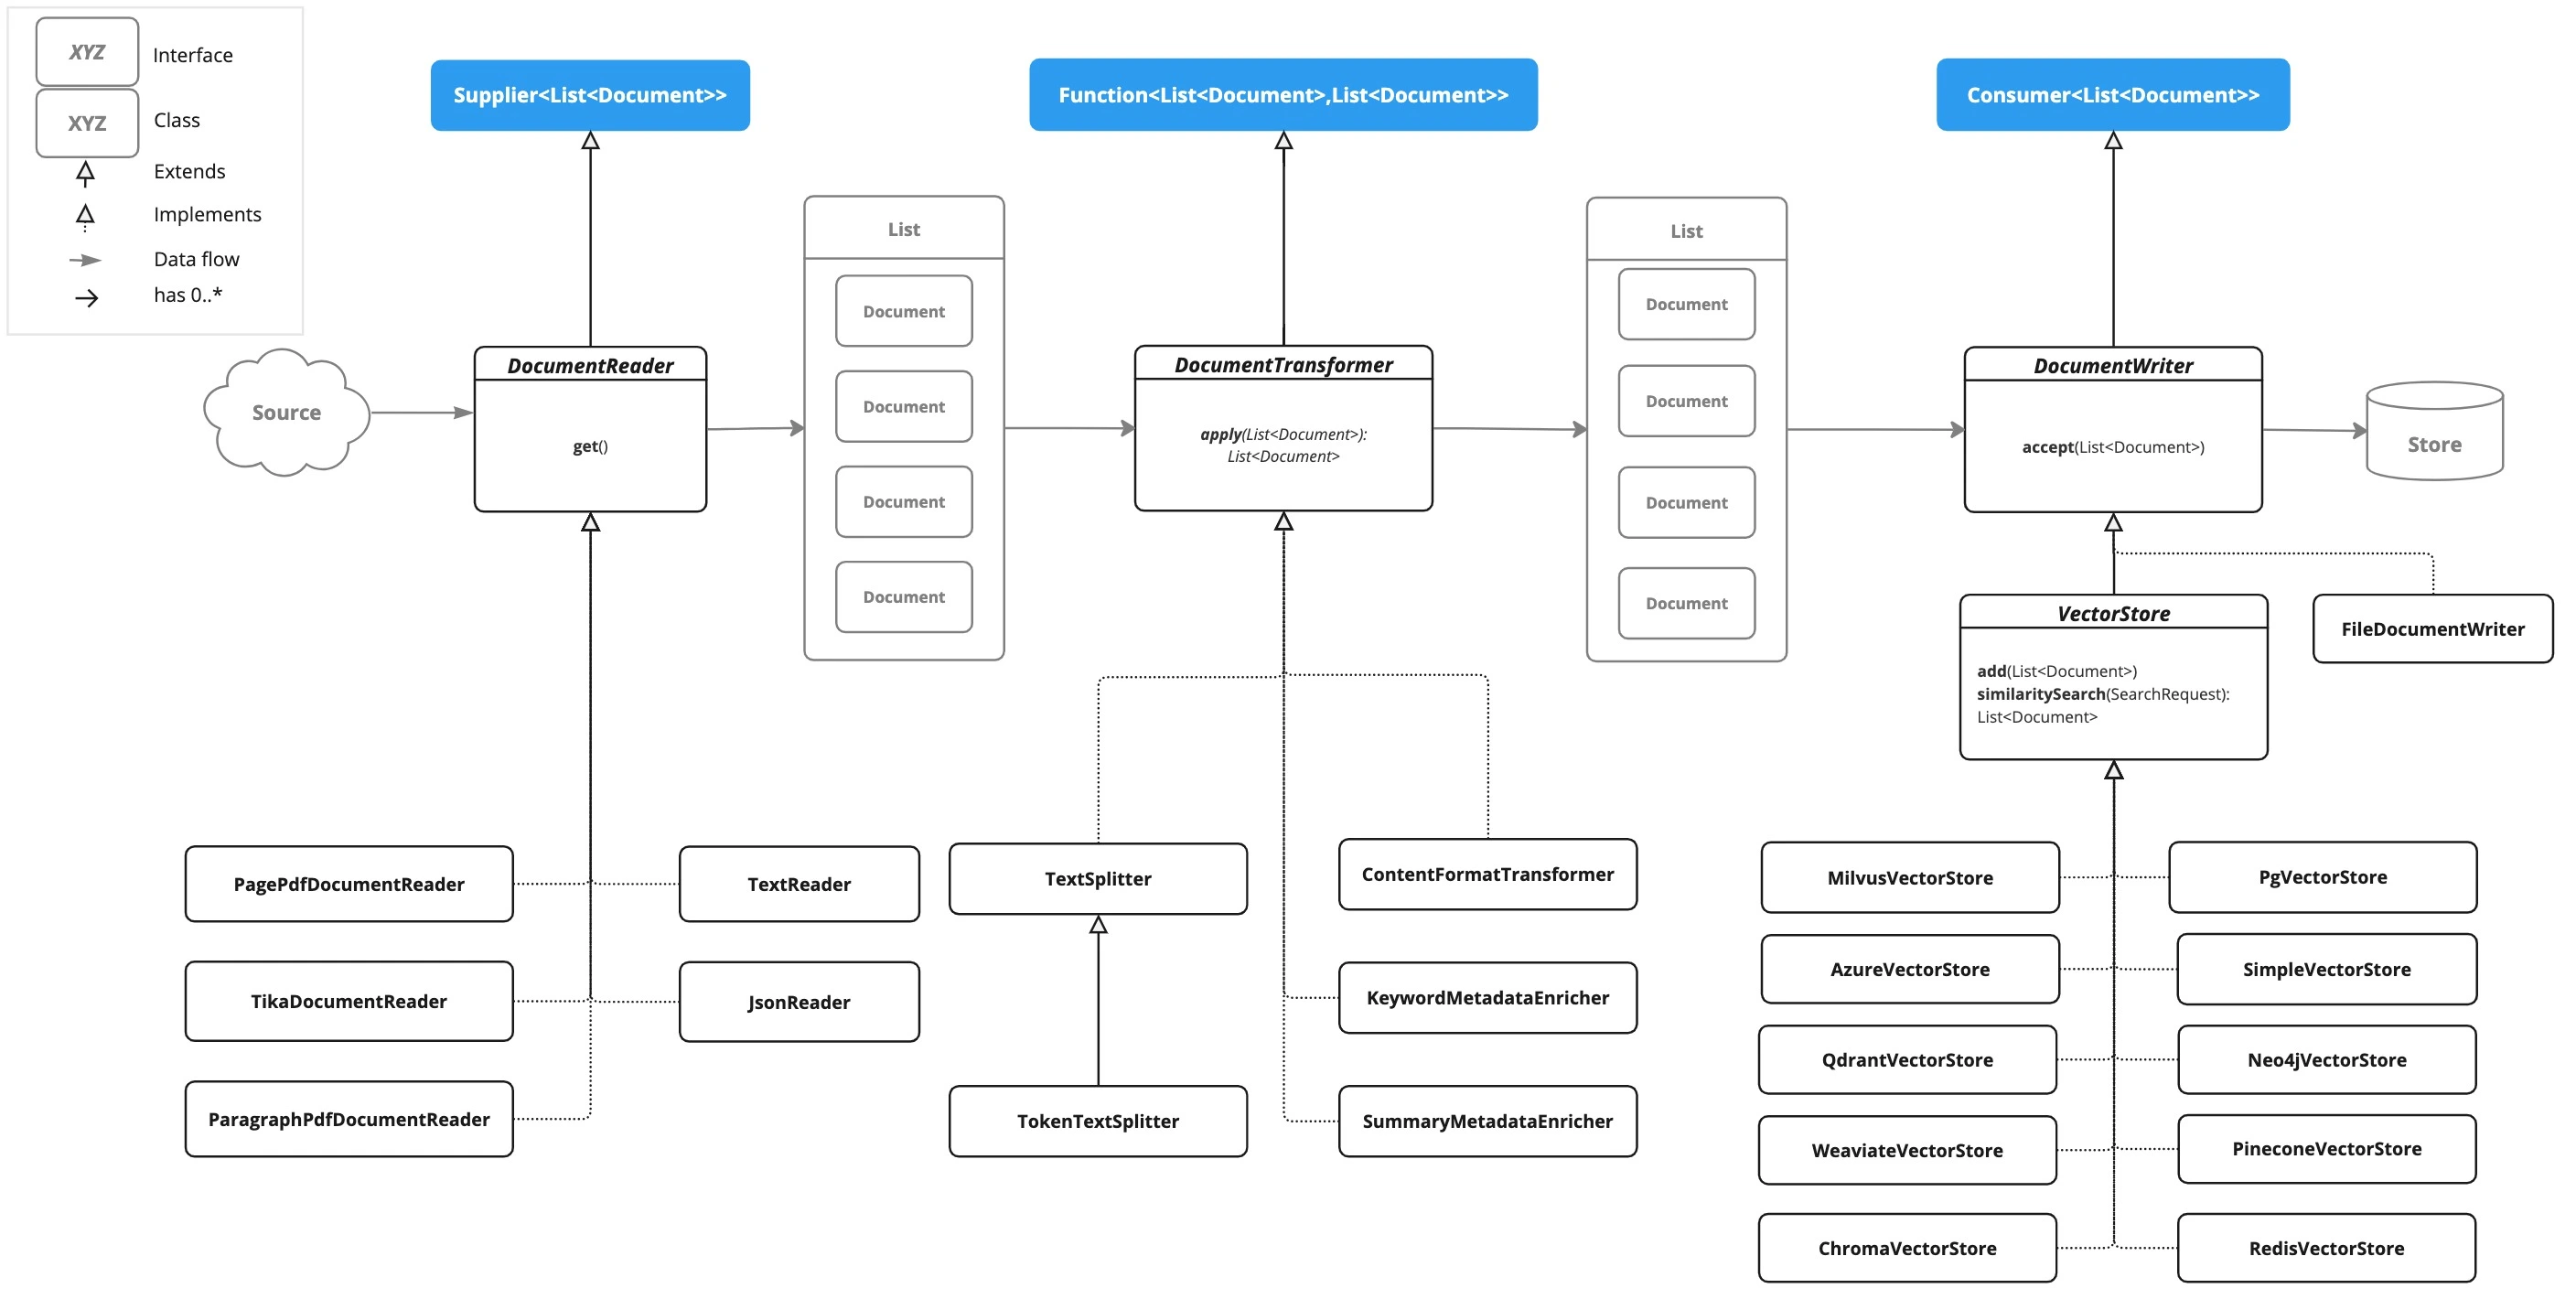
DocumentReader 是一个用于从各种格式的文档中提取文本内容并将其转换为 Document 对象的核心组件。Document 对象随后可以被用于向量嵌入(embedding)、语义搜索、RAG:
统一读取接口:提供标准化方式从不同来源(如 PDF、Word、TXT、HTML、Markdown 等)加载原始文本。
结构化输出:将原始内容封装为 org.springframework.ai.document.Document 对象,包含:
- content:文档的文本内容
- `metadata:元数据(如文件名、页码、来源 URL、创建时间等)
- 支持扩展:开发者可自定义实现特定格式的解析器。
调用read/get方法,就能得到一个Document的List
接口
public interface DocumentReaderStrategy { //判断是否支持该文件 boolean supports(File file);
//读取文件并返回 Document 列表 List<Document> read(File file) throws IOException;}文本
public class TextReaderStrategy implements DocumentReaderStrategy {
@Override public boolean supports(File file) { String name = file.getName().toLowerCase(); return name.endsWith(".txt") || name.endsWith(".tex") || name.endsWith(".text"); }
@Override public List<Document> read(File file) throws IOException { Resource resource = new FileSystemResource(file); return new TextReader(resource).get(); }}Resource — jakarta.annotation.Resource(注解)≠ org.springframework.core.io.Resource(Spring 资源)。
Document — javax.swing.text.Document(Swing 画图组件≠org.springframework.ai.document.Document
Json
@Componentpublic class JsonReaderStrategy implements DocumentReaderStrategy {
public boolean supports(File file) { String name = file.getName().toLowerCase(); return name.endsWith(".json"); }
@Override public List<Document> read(File file) throws IOException { Resource resource = new FileSystemResource(file); // 假设目标提取json的两个字段description和content JsonReader jsonReader = new JsonReader(resource, "description", "content"); return jsonReader.get(); }}<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-pdf-document-reader</artifactId> <version>1.1.0</version>
</dependency>- 两个reader:ParagraphPdfDocumentReader、PagePdfDocumentReader
- 区别是PagePdfDocumentReader 是“按页切分”,而 ParagraphPdfDocumentReader是“按语义段落切分
@Componentpublic class PdfReaderStrategy implements DocumentReaderStrategy { @Override public boolean supports(File file) { return file.getName().toLowerCase().endsWith(".pdf"); }
@Override public List<Document> read(File file) throws IOException { // 读取配置 PdfDocumentReaderConfig config = PdfDocumentReaderConfig.builder() .withPageTopMargin(50) // 忽略顶部50个单位的页眉 .withPageBottomMargin(50) // 忽略底部50个单位的页脚 .withPagesPerDocument(1) // 每一页作为一个 Document .withPageExtractedTextFormatter(new ExtractedTextFormatter.Builder() .withNumberOfTopTextLinesToDelete(0) // 每页再额外删掉前0行 .build()) .build();
Resource resource = new FileSystemResource(file); return new PagePdfDocumentReader(resource, config).get(); }}html
<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-jsoup-document-reader</artifactId> <version>1.1.0</version>
</dependency>@Componentpublic class HtmlReaderStrategy implements DocumentReaderStrategy {
@Override public boolean supports(File file) { String name = file.getName().toLowerCase(); return name.endsWith(".html") || name.endsWith(".htm"); }
@Override public List<Document> read(File file) throws IOException { // 读取配置 JsoupDocumentReaderConfig config = JsoupDocumentReaderConfig.builder() // 只提取p标签段落 .selector("p") // 文件编码 .charset("UTF-8") // 包含超链接 .includeLinkUrls(true) // 提取meta标签的元数据 .metadataTags(List.of("author", "date")) // 添加自定义元数据 .additionalMetadata("filename", file.getName()) .build(); Resource resource = new FileSystemResource(file); return new JsoupDocumentReader(resource, config).get(); }Markdown
<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-markdown-document-reader</artifactId> <version>1.1.0</version>
</dependency>public class MarkdownReaderStrategy implements DocumentReaderStrategy {
@Override public boolean supports(File file) { String name = file.getName().toLowerCase(); return name.endsWith(".md"); }
@Override public List<Document> read(File file) throws IOException { // 读取配置 MarkdownDocumentReaderConfig config = MarkdownDocumentReaderConfig.builder() // 水平线分割生成新文档 .withHorizontalRuleCreateDocument(true) // 不包含代码块 .withIncludeCodeBlock(false) // 不包含引用 .withIncludeBlockquote(false) // 添加文件名元数据 .withAdditionalMetadata("filename", file.getName()) .build(); Resource resource = new FileSystemResource(file); return new MarkdownDocumentReader(resource, config).get(); }}pdf,ppt,word读取
<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-tika-document-reader</artifactId> <version>1.1.0</version>
</dependency>public class TikaReaderStrategy implements DocumentReaderStrategy {
@Override public boolean supports(File file) { String name = file.getName().toLowerCase(); return name.endsWith(".doc") || name.endsWith(".docx"); }
@Override public List<Document> read(File file) throws IOException { Resource resource = new FileSystemResource(file); return new TikaDocumentReader(resource).get(); }}文档清洗
@GetMapping("/read")public List<Document> readDocument(@RequestParam("path") String path) { File file = new File(path); if (!file.exists() || !file.isFile()) { throw new IllegalArgumentException("文件不存在或不是有效文件: " + path); } try {
List<Document> documents = selector.read(file);
return cleanDocuments(documents);
} catch (IOException e) { throw new RuntimeException("读取文件失败: " + e.getMessage(), e); }}
/** * 文本清洗 */public List<Document> cleanDocuments(List<Document> documents) { if (CollectionUtils.isEmpty(documents)) { return documents; }
return documents.stream() .map(doc -> { if (doc == null || doc.getText() == null) { return doc; }
String text = doc.getText();
// 1. 去掉多余空白字符(空格、制表符、换行等) text = text.replaceAll("\\s+", " ").trim();
// 2. 去掉无意义的乱码或特殊符号 text = text.replaceAll("[^\\p{L}\\p{N}\\p{P}\\p{Z}\\n]", "");
// 3. 可选:统一大小写 // text = text.toLowerCase();
// 4. 按换行拆分段落,去除重复段落 String[] paragraphs = text.split("\\n+"); Set<String> seen = new LinkedHashSet<>(); for (String para : paragraphs) { String trimmed = para.trim(); if (!trimmed.isEmpty()) { seen.add(trimmed); } }
text = String.join("\n", seen);
return new Document(text); }) .collect(Collectors.toList());}文本分割
读取文件类型统一入口
@Componentpublic class DocumentReaderFactory {
@Autowired private List<DocumentReaderStrategy> strategies;
public List<Document> read(File file) throws IOException { for (DocumentReaderStrategy strategy : strategies) { if (strategy.supports(file)) { return strategy.read(file); } } throw new IllegalArgumentException("不支持的文件类型: " + file.getName()); }}- Spring 会自动把所有实现了 DocumentReaderStrategy接口的 Bean 注入到 strategies`集合中。
- 当调用
read(file)方法时,它会遍历所有读取策略。 - 每个策略通过
supports(file)判断自己是否支持当前文件。 - 找到支持的策略后,就调用它的
read(file)方法完成文件解析。 - 如果所有策略都不支持,就抛出异常,提示“不支持的文件类型
文档切片
Chunking
把长文档切成多个较小文本块,方便后续进行向量化、检索和生成答案。
-
Embedding 模型的 Token 限制 嵌入模型一次只能处理有限数量的 Token。文档超过限制时,必须先切分。
-
文本的语义完整性 每个文本块应尽量表达完整内容。切分位置不合理,会把相关信息拆散,降低检索结果的准确性。
固定长度分割:根据embedding模型的token长度限制,将文本分割为固定长度(例如256/512个tokens),这种切分方式会损失很多语义信息,一般通过在头尾增加一定冗余量来缓解。
-
chunk_size:块中的字符数量
-
chunk_overlap: 顺序块中重叠的字符数。减少语义割裂
TextSplitter 是所有文本拆分器的抽象基类
TokenTextSplitter 会先将文本编码成模型的 token,然后根据设定的每块 token 数,把文本拆成多个长度适合模型上下文的小文本块。
SpringAI不支持overlap字段采用SpringAlibaba递归分块
或是Langchin4j的语义分块
- 递归分块:以“句”的粒度进行切分,保留一个句子的完整语义。常见切分符包括:句号、感叹号、问号、换行符等。
RecursiveCharacterTextSplitter splitter = new RecursiveCharacterTextSplitter(100);List<String> chunks = splitter.splitText("""
""");
chunks.forEach(System.out::println); //文档清洗 List<Document> allChunkedDocuments = DocumentCleaner.cleanDocuments(documents).stream() .flatMap(document -> { // 分块 //Spring自定义分割器实现Overlap功能 OverlapParagraphTextSplitter splitter = new OverlapParagraphTextSplitter(1000, 50); return splitter.split(document).stream(); }) .collect(Collectors.toList());文档不能先清洗依赖这些特殊符号
- 文档分块
- 语义分块
文本分割策略
**策略一:递归字符分割(Recursive Character Splitting)—— 通用首选**这是 LangChain 默认且最推荐的分割器(RecursiveCharacterTextSplitter)。
-
原理:它不是傻傻地按字数切,而是有一个优先级列表。
a. 先尝试按
\n\n(段落)切。 b. 如果切完还太大,就尝试按\n(换行)切。 c. 还大?按.(句号)切。 d. 最后才按字符切。 -
优点:它极力保证了段落和句子的完整性,语义最连贯。
-
适用:Word、TXT、PDF 提取后的纯文本。
策略二:按结构分割(Structural Splitting)—— Markdown/代码神器
如果你的原始文档格式很好(比如 Markdown 或代码),千万不要当成纯文本处理。
- Markdown Header Splitter:
- 原理:根据
# 标题1、## 标题2进行层级分割。 - 神来之笔:它会将标题作为**元数据(Metadata)**附带在每一个切片里。
- 例子:
- 切片内容:
“部署命令是 docker-compose up” - 元数据:
{Header: "第三章:部署指南", SubHeader: "Linux环境"}
- 切片内容:
- 效果:当 LLM 检索到这段话时,它知道这是属于“Linux部署”的,而不是“Windows部署”的,上下文极强。
- 原理:根据
策略三:Small-to-Big(父子索引)—— 进阶大招
这是目前提升 RAG 效果最有效的手段之一(LlamaIndex 中叫 ParentDocumentRetriever)。
痛点:
- 切片太小:含有语义信息少,LLM 看不懂上下文。
- 切片太大:包含了太多噪音,向量检索不准(因为向量是取平均值的)。
解决方案:“存大找小”。
a. **切两刀: **
- 小切片(Child Chunk):比如 128 Token。用来做 Embedding 和检索。
- 大切片(Parent Chunk):比如 1024 Token(包含那个小切片)。
b. 检索时:用“小切片”去匹配用户的 Query(因为小切片语义聚焦,匹配最准)。
c. 给 LLM 时:找到小切片后,**把它的“父切片”(整段话)**扔给 LLM。
效果:检索极其精准,同时 LLM 获得的上下文非常丰富。
用户问题**** ↓ 检索小切片 ↓ 找到最匹配的子切片 ↓ 根据父子关系找到父切片 ↓ 把完整父切片交给 LLM
大分块不包含子分块
父分块放到关系型数据库,子替换父,然后父分片的去重、查询的加速、以及如何替换等问题
- 我是一个完整的句子 ,id =5 ——> MySQL
- 我是一个完 , parentChunkId = 5 ——> pgvector(代指pg的向量库)
- 整的句子 , parentChunkId = 5——> pgvector
向量化
初识
embedding
- 向量化将文本数据转化为向量矩阵(一串数字)的过程,会直接影响到后续检索的效果。[0.1, 0.3, 0.5]
- 把文字转换成数字向量,相似的文字会得到相似的向量
向量模型
SpringAI提供了EmbeddingModel接口
DashScopeEmbeddingModel
spring: ai: dashscope: embedding: options: model: text-embedding-v4 dimensions: 768OpenAiEmbeddingModel
<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-starter-model-openai</artifactId></dependency>spring: ai: openai: embedding: base-url: https://dashscope.aliyuncs.com/compatible-mode/ api-key: xxxxxxxxxxxxxxxxxxxxxxxxxxxx options: dimensions: 768 model: text-embedding-v4向量化的过程本质上是对 List
public List<float[]> embed(List<Document> documents) { if (CollectionUtils.isEmpty(documents)) { return new ArrayList<>(); }
return documents.stream().map(doc -> openAiEmbeddingModel.embed(doc)).collect(Collectors.toList());ChatGPT-Embedding
https://platform.openai.com/docs/guides/embeddings/what-are-embeddings
ERNIE-Embedding V1
ERNIE-Embedding V1由百度公司提供,依赖于文心大模型能力,以接口形式调用。
https://cloud.baidu.com/doc/WENXINWORKSHOP/s/alj562vvu
M3E
M3E是一款功能强大的开源Embedding模型,包含m3e-small、m3e-base、m3e-large等多个版本,支持微调和本地部署。
https://huggingface.co/moka-ai/m3e-base
BGE
BGE由北京智源人工智能研究院发布,同样是一款功能强大的开源Embedding模型,包含了支持中文和英文的多个版本,同样支持微调和本地部署。
https://huggingface.co/BAAI/bge-base-en-v1.5
坑1:切片长度(Sequence Length)
- 老模型限制:很多早期的模型(如 BERT,text2vec-base-chinese)只能处理 512 个 Token(约 300-400 个汉字)。
- 后果:如果你的文档切片是 800 字,后面的内容直接被模型截断丢弃了,根本搜索不到。
- 建议:务必选择支持 512 以上长度的模型。BGE-M3 和 OpenAI 都支持 8192,完全够用。
坑2:指令前缀(Instruction Prefix)
- 说法:有些模型(如 BGE)在生成向量时,需要加一个特定的前缀字符串。
- 查询时:
"为这个句子生成表示以用于检索相关文章:"+ 用户问题。 - 入库时:不需要前缀。
- 查询时:
- 后果:如果你代码里忘了加这个前缀,检索效果会断崖式下跌。
- 建议:仔细阅读 HuggingFace 模型页面的 Usage 说明。
坑3:维度大小(Dimension)
- 说法:维度越高,存储越贵,检索越慢,但理论上信息量越大。
- OpenAI:1536 维或 3072 维。
- BGE-large:1024 维。
- M3E-base:768 维。
- 建议:对于百万级以下的数据量,768 维(base 版本)性价比最高,速度和精度的平衡点。不要盲目追求大维度。
总结推荐
- 无脑首选:BGE-M3(或者是
bge-large-zh-v1.5)。- 理由:中文最强,支持长文本,功能全,开源免费。
- 备选方案:M3E-base。
- 理由:老牌稳定,特定领域可能更准,部署更轻量。
- 不要选:早期的
text2vec系列(过时了),或者 OpenAI 的text-embedding-ada-002(性价比低,效果一般)。
数据入库
为什么不用普通数据库?
-
普通数据库(MySQL、MongoDB)擅长精确查询:“找ID=123的记录”。但向量搜索是相似性查询:“找和[0.1, 0.3, 0.5]最相似的10个向量”。
-
向量数据库用了特殊的索引算法(如HNSW、IVF),能在百万、千万级向量中毫秒级找到最相似的。
-
数据向量化后构建索引,并写入数据库的过程可以概述为数据入库过程,适用于RAG场景的数据库包括:FAISS、Chromadb、ES、milvus等。
| 向量数据库 | 简介 | 适用场景 | 特点 |
|---|---|---|---|
| Milvus | 开源的分布式向量数据库,专为大规模、高性能向量检索设计 | 海量数据、高并发、大规模向量检索 | 性能强、支持分布式、适合生产级大规模场景 |
| Elasticsearch | 传统文本检索引擎,同时支持向量检索 | 文本检索 + 向量检索的混合检索场景 | 生态成熟,适合做关键词检索与语义检索结合 |
| Chroma | 轻量级向量数据库,优先考虑易用性和开发友好性 | 小规模应用、原型验证、本地开发 | 上手简单,适合快速集成和 Demo 场景 |
| PGvector | 基于 PostgreSQL 的向量扩展 | Java 后端项目、中小规模向量检索、已有 PostgreSQL 项目 | 部署简单,可用 Navicat 可视化查看,对 Java 后端程序员友好 |
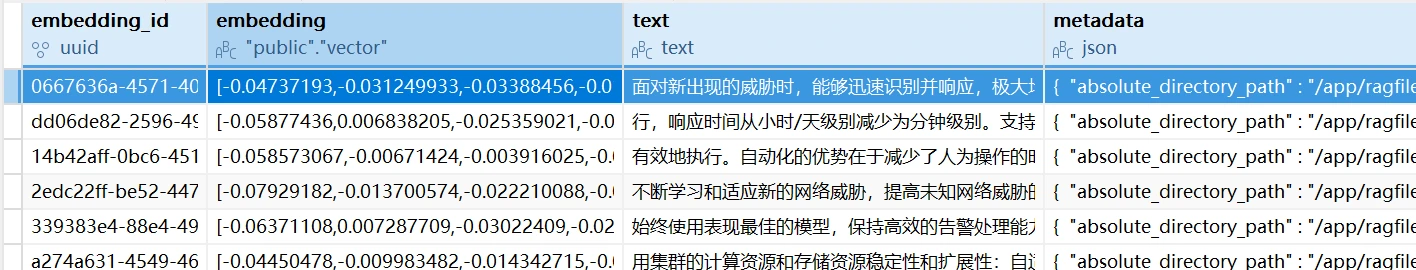
- 主键embedding_id,高维向量embedding、原始文本块text、元数据metadata。
- 高维向量embedding:也就是表达语义信息,用于索引的相似度匹配查询。
- 原始文本块text:我们检索出来,让大模型引用参考的其实就是一些列的原始文本块,高维向量的只是一个用于相似度查询的索引,模型只有基于原始文本块才可以去进行回答效果的增强。
- 元数据metadata:则让我们在检索时能做精确的过滤、分组或追溯来源。如文件名过滤、时间戳过滤
docker run --name pgvector \ -e POSTGRES_USER=pgvector \ -e POSTGRES_PASSWORD=pgvector \ -e POSTGRES_DB=rag_test \ -p 5433:5432 \ -v /home/docker_pgvector:/var/lib/postgresql/data \ -d ankane/pgvector:v0.5.0<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-starter-vector-store-pgvector</artifactId> <version>1.1.0</version></dependency>vectorStore的bean被注入
- JdbcTemplate用于和向量数据库交互, 做CRUD。
- EmbeddingModel用来做embed,把文本转换成向量表示。
spring: datasource: url: jdbc:postgresql://localhost:5433/rag_test username: pgvector password: pgvector ai: vectorstore: pgvector: # 向量索引类型 index-type: HNSW # 距离度量,余弦值 distance-type: COSINE_DISTANCE # 向量维度 dimensions: 768 # 批量处理大小 max-document-batch-size: 9 # 启动时是否自动创建表 initialize-schema: true # 创建的表名 table-name: vector_st- embed方法:使用openAiEmbeddingModel的embed方法对document做向量化,并把结果返回。
- embedAndStore方法:使用vectorStore的add方法完成向量化+储存到向量数据库
public void doAdd(List<Document> documents) { List<float[]> embeddings = this.embeddingModel.embed( documents, EmbeddingOptions.builder().build(), this.batchingStrategy );
List<List<Document>> batchedDocuments = this.batchDocuments(documents); batchedDocuments.forEach(batchDocument -> this.insertOrUpdateBatch(batchDocument, documents, embeddings) );}- PgVectorStore.add()内部,真正执行的是 doAdd() 方法
- 会先调用 embeddingModel
把Document转成向量,然后再通过 JdbcTemplate`把文本、向量、元数据等信息写入 PostgreSQL。 max-document-batch-size控制的是一次最多向量库入库多少个 Document,并不是控制一次传给 embedding 模型多少个 Document。
检索生成
数据检索
常见的数据检索方法包括:相似性检索、全文检索等,根据检索效果,一般可以选择多种检索方式融合,提升召回率。
- 相似性检索:即计算查询向量与所有存储向量的相似性得分,返回得分高的记录。常见的相似性计算方法包括:余弦相似性、欧氏距离、曼哈顿距离等。
public static final int DEFAULT_TOP_K=5;
public List<Document> similarSearch(String query) { return vectorStore.similaritySearch(SearchRequest .builder() .query(query) .topK(DEFAULT_TOP_K) .similarityThreshold(0.7f) .build());}
public LIst<Document> similarSearch(SearchRequest){return VectorStore.similaritySearch(SearchRequest)}VectorStore继承于VectorRetriever接口
| 参数 | 含义 | 示例值 | 说明 |
|---|---|---|---|
query | 用于检索的查询语句 | "什么是Mybatis?" | 该 query 会被自动向量化,并与向量库中的向量做相似度对比 |
topK(int) | 返回结果条数(Top-K) | 5 | 数值越大,返回匹配内容越多;一般 3~10 较合理 |
similarityThreshold(float) | 相似度阈值(0~1) | 0.7f | 用于过滤不相关内容,越接近 1 越严格;常用范围 0.6~0.8,需要结合业务反复调测 |
检索增强
@Autowired private ChatModel chatModel;
@GetMapping("/retrieve") public String retrieve(String query, double threshold) { List<Document> documents = embeddingService.similaritySearch(SearchRequest .builder() .query(query).similarityThreshold(threshold).build());
//检索的内容并流式输出 String documentContent = documents.stream() .map(Document::getText) .collect(Collectors.joining("\n\n=========文档分隔线===========\n\n"));
// 2. 构建提示词模板 String promptTemplate = """ 请基于以下提供的参考文档内容,回答用户的问题。 如果参考文档中没有相关信息,请直接说明"没有找到相关信息",不要编造内容。
参考文档: {documents}
用户问题: {question} """;
PromptTemplate prompt = new PromptTemplate(promptTemplate); Prompt realPrompt = prompt .create(Map.of("documents", documentContent, //检索参考文档 "question", query));//询问用户问题 return chatModel.call(realPrompt).getResult().getOutput().getText(); }QuestionAnswer
- 提供了 Advisor 来自动化 RAG 流程
- Advisor可以在模型调用前自动插入检索、重写Prompt以及后处理回答,从而无需手写检索和提示词拼接逻辑。
<dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-advisors-vector-store</artifactId> <version>1.1.0</version></dependency>@RestController@RequestMapping("/rag/retriever")public class RagRetrieverController implements InitializingBean {
private ChatClient chatClient;
@GetMapping("/retrieveAdvisor") public String retrieveAdvisor(String query) { return chatClient.prompt(query).call().content(); }
@Autowired private PgVectorStore vectorStore;
@Override public void afterPropertiesSet() throws Exception {
// 自定义Prompt模板 PromptTemplate promptTemplate = new PromptTemplate(""" 请基于以下提供的参考文档内容,回答用户的问题。 如果参考文档中没有相关信息,请直接说明"没有找到相关信息",不要编造内容。
参考文档内容: {question_answer_context}
用户问题: {query} """);
QuestionAnswerAdvisor questionAnswerAdvisor = //放入自己的向量数据库 QuestionAnswerAdvisor.builder(vectorStore)
.searchRequest(SearchRequest.builder() //设置检索阈值(低于这个值会被过滤) .similarityThreshold(0.5)
//返回的个数 .topK(5).build())
//设置提示词模板 .promptTemplate(promptTemplate).build();
this.chatClient = ChatClient.builder(chatModel) // 实现 Logger 的 Advisor .defaultAdvisors(questionAnswerAdvisor)
// 设置 ChatClient 中 ChatModel 的 Options 参数 .defaultOptions( DashScopeChatOptions.builder() .withTopP(0.7) .build() ).build(); }}**QuestionAnswerAdvisor实现了 BaseAdvisor **
初始化
QuestionAnswerAdvisor(VectorStore vectorStore, SearchRequest searchRequest, @Nullable PromptTemplate promptTemplate, @Nullable Scheduler scheduler, int order)- 校验 vectorStore 和 searchRequest 不能为空
- 保存向量库对象
- 保存检索参数
- 如果没传模板,就用默认模板
- 如果没传调度器,就用默认调度器
- 保存执行顺序 order
QuestionAnswerAdvisor.before(…) 先做检索和提示词增强
QuestionAnswerAdvisor.after(…)不改答案正文,只把检索到的文档塞进响应元数据里。
保留证据链,方便追踪和调试
- 全文检索:全文检索是一种比较经典的检索方式,在数据存入时,通过关键词构建倒排索引;在检索时,通过关键词进行全文检索,找到对应的记录。
检索策略 相似性检索
这是 RAG 与传统搜索引擎最大的区别,也是让知识库具备“语义理解”能力的根本。
- 原理:不再匹配字面上的词,而是匹配意思。
- 用户搜:“我想退货”。
- 文档里:“消费者享有7天无理由售后服务”。
- 结果:传统检索(关键词)完全匹配不上,但相似性检索能匹配上,因为这两个句子的向量在多维空间里靠得很近。
- 距离算法选择:
- 余弦相似度(Cosine Similarity):RAG 领域的绝对主流。 它衡量的是两个向量方向是否一致,对文本长度不敏感。
- 欧氏距离(L2):衡量两点间的直线距离。通常用于图像检索,文本用得少。
- 内积(IP, Inner Product):如果你已经把向量做了归一化(Normalized),内积计算最快,效果等同于余弦相似度。
- 工程陷阱:
- 语义漂移:有时候“苹果公司”和“苹果手机”很近,但“苹果水果”也很近。纯向量检索容易被看起来相关但逻辑无关的词带偏。
2. 全文检索(Full-Text Search / Keyword Search)
这是老派技术(如 ElasticSearch、Lucene),但在 RAG 时代依然不可或缺。
- 原理:基于倒排索引(Inverted Index)。
- 它把文章拆成词(Token),建立“词 -> 文章ID”的索引。
- 用户搜:“错误码 5003”。
- 文档里:“…遇到 5003 报错…”。
- 结果:精准命中。
- 为什么 RAG 还需要它?
- 专有名词/精确匹配:向量检索对于数字、型号、人名、缩写非常不敏感(因为这些词在语义空间里很难定位)。比如搜“合同号 2023-A-01”,向量检索可能给你找来一堆“2023年的合同”,但不一定是 A-01。此时必须靠全文检索。
- 融合策略:混合检索(Hybrid Search)
- 这是目前最高级的玩法:
- 同时并行跑两路检索:一路向量(查语义),一路全文(查关键词)。
- 通过 **RRF(Reciprocal Rank Fusion)**算法把两路结果合并、去重、排序。
- 结果:既懂语义,又能精确匹配关键词。
3. BM25
4. 图检索
向量检索
#用户问题question = "阿司匹林有哪些副作用?"
#问题向量化question_embedding = embeddings.embed_query(question)
#向量检索(找最相似的3个)results = vectorstore.similarity_search_by_vector( embedding=question_embedding, k=3 # 返回top3)
for i, doc in enumerate(results): print(f"结果{i+1}:") print(doc.page_content) print(f"相似度: {doc.metadata['score']}") print("-" * 50)- 单纯向量搜索
- 优点:能理解语义
- 缺点:对专有名词、数字等不敏感
- 混合搜索(Hybrid Search)
- 关键词检索(BM25/ES)与向量相似度检索,提升精确度
-
向量搜索 + 关键词搜索
-
综合排序,取最优结果
#混合搜索示例def hybrid_search(query, alpha=0.5): # alpha: 向量搜索权重(0-1) # 向量搜索结果 vector_results = vectorstore.similarity_search(query, k=10) # 关键词搜索结果(BM25算法) keyword_results = bm25_search(query, k=10) # 融合排序 final_results = merge_results(vector_results, keyword_results, alpha) return final_results[:3] # 返回top3重排序(Re-ranking)
初步检索后,用更精细的模型重新排序,提高精度。
from sentence_transformers import CrossEncoder
#加载重排序模型reranker = CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')
#对检索结果重新打分query = "阿司匹林副作用"candidate_docs = ["文档1内容", "文档2内容", "文档3内容"]
scores = reranker.predict([(query, doc) for doc in candidate_docs])
#按分数排序ranked_docs = [doc for _, doc in sorted(zip(scores, candidate_docs), reverse=True)]| 指标 | 含义 | 公式 | 目标 |
|---|---|---|---|
| Recall@K | 前K个结果中,包含多少相关文档 | 检索到的相关文档数 / 总相关文档数 | 越高越好 |
| Precision@K | 前K个结果中,有多少是相关的 | 相关文档数 / K | 越高越好 |
| MRR | 第一个相关文档的排名倒数 | 1 / 第一个相关文档的排名 | 越高越好 |
| NDCG | 考虑排序质量的综合指标 | 复杂公式 | 越高越好 |
提示词工程
在 RAG 场景下,提示词工程的目标只有一个:强迫 LLM“忘记”它自带的训练知识,完全依赖你喂给它的“上下文”来回答问题(Grounding)。
标准 RAG 提示词架构:
一个优秀的 RAG Prompt 通常包含以下 4 个部分,顺序很重要:
- 角色设定(Role):告诉 LLM 它是谁(专业的知识库助手)。
- 任务指令(Instruction):核心规则(比如“只根据上下文回答”、“不要编造”)。
- 上下文数据(Context):这是你检索到的那几段文字,通常用特殊符号包裹。
- Json输出可以加一层校验可能引入{}
- 用户问题(Query):用户真正问的内容。
- 结构化提示词 #角色 # 规则
- Few-Short少量样本(几个示例)
- 提供上下文信息(RAG增强检索)
结构化提示词
# Role
你是一个专业的企业知识库助手。你的任务是根据提供的【参考文档】回答用户的问题。
# Rules(关键!防幻觉指令)
1. 必须**仅依赖**下方的【参考文档】进行回答,不要使用你内部的训练知识。2. 如果【参考文档】中没有包含回答问题所需的信息,请直接回答:“知识库中未找到相关信息”。3. 回答需要逻辑清晰,分点表述。4. 如果可能,请在回答的末尾注明引用的文档名称。
# Context(检索到的片段)
以下是参考文档片段:
<context>{context_str}</context>
# User Question
用户的问题是:{query_str}
# Answer请开始回答:
Few-Short少量样本方法二:给予示例工程示例1示例2messages=[ {"role": "system", "content": "You are a helpful assistant."}, {"role": "user", "content": "你是谁?"}, ]系统提示词
- 用户通常看不到或不能直接修改;但是做大模型应用开发的时候,代码里面是可以指定系统提示词的。
- 在每次对话中隐式地作用于模型;
- 是模型“默认行为”的基础。
用户提示词
- 由用户自由输入;
- 决定单次交互的具体内容方向
# 角色定义你是一名专业的旅行规划顾问,擅长根据用户偏好制定个性化的旅游计划。你需要以Markdown格式输出一份简洁、清晰、实用的行程安排。---# 任务描述根据用户输入的出行需求(如目的地、天数、兴趣点等),制定一个详细的旅行计划。要求内容包括:1. 每日行程安排(含景点、交通、餐饮推荐)2. 总体花费预估(以人民币计)3. 温馨提示(如天气、穿衣建议、注意事项)---# 景点参考信息(上下文信息)以下是部分城市旅游参考资料(供你在规划时参考):[文档片段1]北京以历史文化景点为主,热门景点包括故宫、长城、颐和园。春秋季节气候宜人,适合户外活动。
[文档片段2]上海以现代都市景观与夜景闻名,热门景点包括外滩、迪士尼、豫园。地铁交通便利,美食多样。
[文档片段3]成都以美食和休闲文化著称,热门景点包括宽窄巷子、大熊猫基地、都江堰,节奏悠闲,消费亲民。---# 示例## 示例1:输入:我想去北京玩两天,主要想看名胜古迹。输出:```markdown # 北京两日游行程规划
## 第一天:历史文化探索 - 上午:参观 **故宫** - 下午:游览 **天安门广场**、**王府井步行街** - 晚餐推荐:全聚德烤鸭
## 第二天:自然与皇家园林 - 上午:游览 **颐和园** - 下午:前往 **八达岭长城** - 晚餐推荐:老北京炸酱面
### 预算预估 约 ¥1200 / 人(含交通与餐饮)
### 温馨提示 - 早晚温差较大,请带外套。 - 部分景区需提前预约。```
## 示例2:输入:帮我规划一个上海三天的亲子游。输出:```markdown # 上海三日亲子游计划
## 第一天:城市初体验 - 上午:参观 **上海自然博物馆** - 下午:漫步 **外滩**,夜游黄浦江 - 晚餐推荐:蟹粉小笼包
## 第二天:迪士尼奇幻乐园 - 全天游玩 **上海迪士尼乐园** - 晚餐推荐:园区主题餐厅
## 第三天:城市休闲与购物 - 上午:游览 **豫园** - 下午:南京路步行街自由活动 - 晚餐推荐:新天地西餐厅
### 预算预估 约 ¥2200 / 人(含门票与住宿)
### 温馨提示 - 提前预约迪士尼门票。 - 夏季炎热,请携带防晒用品。 ```
---
# 按照如下格式输出:# <城市+天数>行程规划标题
## 第一天:- 上午:- 下午:- 晚餐推荐:
## 第二天:- 上午:- 下午:- 晚餐推荐:
## 第三天:- 上午:- 下午:- 晚餐推荐:
### 预算预估### 温馨提示
---
# 当前任务请根据以下用户输入,生成Markdown格式的旅行行程方案:
用户输入:“我打算去成都玩三天,想吃美食也想看看大熊猫。”请确保按照指定的输出格式输出,不要输出多余解释或说明。优化
思维链(模型thking过程)一步一步完成
- 首先输出一个详细的、逻辑连贯的推理过程,再基于这个过程得出结论。
- 指定每一个小问题,模型一个个回答
自我一致性(少数服从多数)
- 并发调用:奇数次调用大模型可并行执行,显著降低整体响应时间。
- 参数调节:适当调整tempature温度系数或者top-p等模型超参,控制模型输出的多样性。条件允许的话,也可以使用不同的大模型,以增强推理路径的多样性。
如果孩子被别的小朋友校园霸凌了,要不要鼓励他勇敢打回去?
请从以下多个视角分别独立思考,并综合给出最终答案://多次调用不同模型=>(汇总多个模型回答,分析)1、孩子的父母2、育儿专家3、学校老师4、心理学家5、孩子自身的角度思维树
- 设计三种方案并分别评估优缺点
- 最终拿到最好的结果
[任务]设计订单到期关闭方案
[步骤一]设计3种订单到期关闭的方案[步骤二]对每种方案评估他的优缺点[步骤三]综合3种方案,选择一个最优方案反思机制
- 增加迭代环节:可以在答案修订和反思审查环节增加循环迭代,通过反复修订+审核,持续提升答案的精度。
生成 → 反思 → 修订 → 再反思 → 再修订 …… → 生成最终答案
ReAct
它是一种结合思考(Reason)与行动(Act)的智能体框架
先思考后行动,再观察结果后修正思考。 思考推理
规划下一步、分解复杂任务或分析上一步行动的结果,生成具体的执行计划。延续了**思维链(CoT)**的优势,提供了动态推理和自主规划的能力。
行动(工具调用)
基于执行计划中每一步的指令要求,模型会自主选择并执行一个外部工具或 API(如联网查询、数学计算、代码生成、知识库查询等)。这也是大模型能够与外部世界建立连接的接口。
观察 / 反馈
反馈智能体成功获取到工具执行的结果后,将会根据原始问题和工具的执行结果,判断任务是否完成,如果未完成,则继续返回思考推理,生成下一步行动的结果,反复循环迭代。如果已完成,则直接进入总结阶段。
输出总结
当判断任务已完成时,它会整合整个循环过程中收集到的所有关键信息,生成一个全面、连贯的最终答案。
LLM生成
【任务描述】假如你是一个专业的客服机器人,请参考【背景知识】,回【背景知识】{content} // 数据检索得到的相关文本【问题】石头扫地机器人P10的续航时间是多久?- Prompt作为大模型的直接输入,是影响模型输出准确率的关键因素之一。
- 在RAG场景中,Prompt一般包括任务描述、背景知识(检索得到)、任务指令(一般是用户提问)
- 根据任务场景和大模型性能在Prompt中适当加入其他指令优化大模型的输出。
RAG 并不是“给大模型接个数据库”这么简单,而是一套完整的信息检索与生成协同系统。Embedding 模型决定你“能不能找对东西”,检索策略决定你“会不会漏掉关键事实”,Prompt 工程决定模型“敢不敢胡说”,而最终的生成效果,往往是这些环节共同作用的结果。
在真实业务中,RAG 的性能瓶颈很少出现在大模型本身,更多出现在数据准备是否合理、切片是否科学、检索是否稳定、Prompt 是否约束到位。一旦其中某一环失控,模型再强,也只能在错误上下文里一本正经地胡说八道。
因此,一个可靠的 RAG 系统,核心目标只有三个:
检索要准、上下文要真、模型要被约束。
只要这三点成立,模型规模反而不是最重要的变量。
后续如果继续展开,可以分别从分块策略优化、召回与重排序、多路检索融合、幻觉评估与监控等角度,进一步把 RAG 从“能跑”推进到“能上线、能长期用”。
| 指标 | 评估内容 | 评估方法 |
|---|---|---|
| Faithfulness | 答案是否忠实于检索文档 | LLM评判 / 人工标注 |
| Relevance | 答案是否回答了问题 | LLM评判 / 相似度计算 |
| Coherence | 答案是否流畅连贯 | 语言模型困惑度 |
| Groundedness | 答案是否有依据 | 检查是否有引用 |
RAG优化
问题改写
分解:
- 增加一模型调用对原问题进行逻辑解析和拆分。
- 检索子查询列表收集所有相关文档块,将所有文档块和原始问题一并输出
富化:指代消除,用于指代模糊信息,重写原问题
多样化:增加模型调用,通过大模型为原始问题生成多个语义相近去重
回溯提示
@Service@Slf4jpublic class QuestionRewriteService {
@Autowired private ChatModel chatModel;
//分解提示词 private static final String DECOMPOSE_PROMPT = """ # 角色 你是一名专业的查询逻辑分析专家。
# 任务 将给定的“用户原始问题”分解为一系列**相互独立、逻辑清晰**,且可单独用于检索的子查询列表。 你的输出必须是一个标准的JSON数组格式。
# 用户原始问题 {QUESTION}
# 输出格式要求 (JSON Array) [ "子查询1", "子查询2", "子查询3", "..." ]
(不强制要求数组元素个数,可根据真实情况输出,至少保留1个)
# 输出 请直接输出JSON数组,不要包含解释或多余的文字。 """;
//问题的富化 private static final String ENRICH_PROMPT = """ # 角色 你是一个专业的问题重写优化器。
# 任务 根据提供的“对话历史”和“用户原始问题”,重写为一个独立、完整、且包含所有必要背景信息的新查询,用于RAG检索。
## 对话历史: {CHAT_HISTORY}
## 原始问题: {QUESTION}
# 输出 输出富化过后的新问题,不要包含多余的解释性内容 """;
//问题的多样化 private static final String DIVERSIFY_PROMPT = """ # 角色 你是一名专业的语义扩展专家。
# 任务 为给定的“原始问题”生成**3个**语义相同但**措辞完全不同、且利于检索**的查询变体,以提高检索的召回率。 你的输出必须是一个标准的JSON数组格式。
# 原始问题 {QUESTION}
# 输出格式要求 (JSON Array) [ "变体1", "变体2", "变体3" ]
# 输出 输出富化过后的新问题,不要包含多余的解释性内容 """;
private static final String STEP_BACK = """ # 角色 你是一个擅长抽象思维和原理推理的专家。
# 任务 请根据用户提出的具体问题,先“后退一步”,将其转化为一个更通用、更本质的问题,聚焦于背后的原理、规律、概念或一般性知识,而不是具体细节。
# 原始问题
{QUESTION}
# 输出 请只输出改写后的“后退问题”,不要解释,不要包含原始问题,也不要回答它。 """;
private static final String QUESTION = "QUESTION"; private static final String CHAT_HISTORY = "CHAT_HISTORY";
/** * 问题分解 * * @param question * @return */ public List<String> decompose(String question) { log.info("===========进入问题分解流程==========="); log.info("原始问题: {}", question); PromptTemplate promptTemplate = new PromptTemplate(DECOMPOSE_PROMPT); promptTemplate.add(QUESTION, question);
String result = chatModel.call(promptTemplate.create()).getResult().getOutput().getText(); log.info("===========问题分解完成,结果: {} ===========", result); return JSON.parseArray(result, String.class); }
/** * 问题富化 */ public String enrich(String chatHistory, String question) { log.info("===========进入问题富化流程==========="); log.info("对话历史: {}", chatHistory); log.info("原始问题: {}", question); PromptTemplate promptTemplate = new PromptTemplate(ENRICH_PROMPT); promptTemplate.add(CHAT_HISTORY, chatHistory); promptTemplate.add(QUESTION, question);
String result = chatModel.call(promptTemplate.create()).getResult().getOutput().getText(); log.info("===========问题富化完成,结果: {} ===========", result); return result; }
/** * 问题多样化 */ public List<String> diversify(String question) { log.info("===========进入问题多样化流程==========="); log.info("原始问题: {}", question); PromptTemplate promptTemplate = new PromptTemplate(DIVERSIFY_PROMPT); promptTemplate.add(QUESTION, question);
String result = chatModel.call(promptTemplate.create()).getResult().getOutput().getText(); log.info("===========问题多样化完成,结果: {} ===========", result); return JSON.parseArray(result, String.class); }
/** * 问题回退 * * @param question * @return */ public String stepBack(String question) { log.info("===========进入问题回退流程==========="); log.info("原始问题: {}", question); PromptTemplate promptTemplate = new PromptTemplate(STEP_BACK); promptTemplate.add(QUESTION, question);
String result = chatModel.call(promptTemplate.create()).getResult().getOutput().getText(); log.info("===========问题回退完成,结果: {} ===========", result); return result; }
// 组合方法 public List<String> rewriteQuery(String query) { log.info("===========进入问题重写组合策略流程==========="); log.info("原始问题: {}", query);
//回退 String stepBackQuery = this.stepBack(query);
// 分解 List<String> decomposedQueries = this.decompose(stepBackQuery);
// 多样化 List<String> finalQueries = new ArrayList<>(); for (String subQuery : decomposedQueries) { List<String> variations = this.diversify(subQuery); finalQueries.addAll(variations); }
if (finalQueries.isEmpty()) { finalQueries.add(query); }
log.info("===========组合重写完成,最终查询列表: {} ===========", finalQueries); return finalQueries; }}@GetMapping("/chatWithQueryRewrite")public String chatWithQueryRewrite(@RequestParam("query") String query) { List<String> rewriteQuery = queryRewriteService.rewriteQuery(query); // set用作文档去重 Set<Document> similarDocs = new LinkedHashSet<>(); for (String q : rewriteQuery) { List<Document> docs = embeddingService.similarSearch(q); if (docs != null && !docs.isEmpty()) { similarDocs.addAll(docs); } } // 2. 构建提示词模板 String promptTemplate = """ 请基于以下提供的参考文档内容,回答用户的问题。
参考文档: {documents}
用户问题: {question} """;
log.info("共检索到 {} 个相关文档块。", similarDocs.size());
// 3. 处理检索到的文档内容 String documentContent = similarDocs.stream() .map(Document::getText) .collect(Collectors.joining("\n\n=========文档分隔线===========\n\n"));
log.info("查询到的文档信息:{}", documentContent);
// 4. 填充模板参数 Map<String, Object> params = new HashMap<>(); params.put("documents", documentContent); params.put("question", query); PromptTemplate prompt = new PromptTemplate(promptTemplate); Prompt realPrompt = prompt.create(Map.of("documents", documentContent, "question", query));
// 5. 调用大模型生成回答 String text = chatClient.prompt(realPrompt).call().chatResponse().getResult().getOutput().getText();
return text;}- 调用
queryRewriteService.rewriteQuery(query)生成多个查询语句。 - 每个查询语句都执行一次向量检索。
- 用
LinkedHashSet<Document>去重。 - 把所有检索到的文档块拼接起来。
- 再交给大模型生成最终回答。
查询路由
数据源
- 不能只靠向量数据库
- Query Routing把用户的请求转发到不同的数据库上面去查询
定义路由
定义四个数据库路由的执行方法
@Servicepublic class GraphDatabaseService {
public String searchGraphDatabase(String query) { return "图数据库搜索结果: 基于关系图谱,找到与'" + query + "'相关的实体关系和路径。" + "这里模拟返回了知识图谱的实体关联结果,实际应用中会连接到Neo4j、ArangoDB或Amazon Neptune等图数据库。"; }}意图识别
基于LLM设置提示词做意图识别
@Servicepublic class QueryRouteService {
private static final String DATASOURCE_ROUTE_PROMPT = """ 你需要判断用户的查询问题适合使用哪种数据库进行检索。 如果是语义相似性搜索、文档检索、内容推荐类问题,回答'VECTOR' 如果是关系查询、知识图谱、实体关联类问题,回答'GRAPH' 如果是结构化数据查询、统计分析、精确匹配类问题,回答'RELATIONAL' 如果无法确定,请回答'VECTOR' 只回答VECTOR、GRAPH或RELATIONAL,不要其他内容。
用户问题: {QUESTION} """;
@Autowired private ChatModel chatModel;
public String route(String query) { PromptTemplate promptTemplate = new PromptTemplate(DATASOURCE_ROUTE_PROMPT); promptTemplate.add("QUESTION", query);
return chatModel.call(promptTemplate.create()).getResult().getOutput().getText(); }
}根据用户的问题,决策出要调具体的数据库服务
@RestController@RequestMapping("/rag/router")public class RagRouterController {//引入4个路由 @Autowired private QueryRouteService queryRouteService; @Autowired private VectorDatabaseService vectorDatabaseService; @Autowired private GraphDatabaseService graphDatabaseService; @Autowired private RelationalDatabaseService relationalDatabaseService;
@RequestMapping("/query") public String ragQuery(HttpServletResponse response, @RequestParam String question) { response.setCharacterEncoding("UTF-8"); //意图识别 String databaseType = queryRouteService.route(question);
String result; switch (databaseType.trim()) { case "VECTOR": result = vectorDatabaseService.searchVectorDatabase(question); break; case "GRAPH": result = graphDatabaseService.searchGraphDatabase(question); break; case "RELATIONAL": result = relationalDatabaseService.searchRelationalDatabase(question); break; default: result = "无法确定合适的数据库类型,默认使用向量数据库: " + vectorDatabaseService.searchVectorDatabase(question); }
return String.format("路由到: %s 数据库\n\n查询结果:\n%s", databaseType, result); }}text2sql
- 把用户问题路由到不同的数据库中去查询。如果是向量数据库,那么就可以去向量数据库查询了。
- 但是如果是图数据库或者关系型数据库,就需要先把自然语言转成SQL或者Cypher 才行
# 角色你是一个SQL专家。请根据以下表结构信息将用户问题转换为SQL查询语句。特别注意,你只能查询,不能做修改、删除等操作。
# 表结构信息
{tables}
# 用户问题
{user_query}
# 要求1. 只返回SQL语句,不需要包含任何解释和说明2. 确保SQL语法正确3. 使用上下文中提供的表名和字段名4. 如果根据所提供的表无法做查询,请直接返回空字符串""
# 其他说明今天是:{today}prompt
- Prompt 1:你是一个专业的医生,可以从专业的医疗角度给出患者建议。
- Prompt 2:你是一个专业的药学专家,掌握丰富的药品知识,能够在用药方面给出更好的建议。
- 根据用户是询问病情还是用药建议,使用不同的提示词。
@AiServicepublic interface MedicalPromptRoutingService {
@SystemMessage("你是一个专业的医生,可以从专业的医疗角度给出患者建议。") Flux<String> doctorConsultation(String userMessage);
@SystemMessage("你是一个专业的药学专家,掌握丰富的药品知识,能够在用药方面给出更好的建议。") Flux<String> pharmacistConsultation(String userMessage);
@SystemMessage("你需要判断用户的询问是关于病情咨询还是用药建议。如果是询问病情、症状、诊断相关的问题,回答'DOCTOR'。如果是询问药物、用药方法、药物副作用相关的问题,回答'PHARMACIST'。只回答DOCTOR或PHARMACIST,不要其他内容。") String determineConsultationType(String userMessage);}determineConsultationType方法,用来做意图识别
@RequestMapping("/medical")@RestControllerpublic class MedicalAssistantController {
@Autowired private MedicalPromptRoutingService medicalRoutingService;
@RequestMapping("/consultation") public Flux<String> medicalConsultation(HttpServletResponse response, @RequestParam String question) { response.setCharacterEncoding("UTF-8");
String consultationType = medicalRoutingService.determineConsultationType(question);
if ("DOCTOR".equals(consultationType.trim())) { return medicalRoutingService.doctorConsultation(question); } else if ("PHARMACIST".equals(consultationType.trim())) { return medicalRoutingService.pharmacistConsultation(question); } else { return medicalRoutingService.doctorConsultation(question); } }问题澄清
- 用户的问题存在模糊、不完整、歧义或需要额外上下文才能被准确回答时,
- 主动与用户进行交互,以获取更多信息或确认其真实意图
public interface TravelPlanningAiService {
@SystemMessage(""" 你是一个专业的旅行顾问,擅长制定个性化的旅行方案。
对话原则: 1. 保持热情、友好的语调,像朋友一样自然对话 2. 基于已有信息给出建议和想法 3. 如需更多信息,自然地询问细节(避免"我需要更多信息"这样的表达) 4. 当信息足够时,生成详细的旅行规划
根据用户输入的不同性质,你需要:
【信息收集阶段】 - 说"听起来很棒!具体想..."来了解细节 - 通过建议来引出问题:"这个地方我很推荐!大概预算多少合适?" - 每次最多问1-2个相关问题
【规划生成阶段】 - 当掌握了目的地、时间、预算、人员等核心信息时 - 生成包含具体日程、住宿、交通、活动的详细规划 - 提供实用的旅行建议和注意事项
始终提供有价值的内容,避免让用户感觉在被"审问"。 """) String chatWithTraveler(@MemoryId String memoryId, @UserMessage String userInput);}需要支持对话记忆,因为用户可能是多轮对话汇总之后才是他的所有要求和基本信息
@RequestMapping("/travelPlan")@RestControllerpublic class SmartTravelPlanningController {
@Autowired private TravelPlanningAiService travelAiService;
@RequestMapping("/start") public Map<String, String> startTravelPlanning(HttpServletResponse response) { response.setCharacterEncoding("UTF-8");
String memoryId = UUID.randomUUID().toString();
String welcomeMessage = """ 🌟 欢迎使用智能行程规划助手!
我可以帮助您制定个性化的旅行计划。为了给您提供最佳的建议,我需要了解一些基本信息:
• 您想去哪里旅行? • 计划什么时候出发? • 大概的预算范围? • 和谁一起旅行? • 您的兴趣爱好?
请告诉我您的旅行想法,我会根据您提供的信息逐步完善行程计划! """;
return Map.of( "sessionId", memoryId, "message", welcomeMessage ); }
@RequestMapping("/chat") public String chatWithPlanner(HttpServletResponse response,@RequestParam String memoryId,@RequestParam String message ) { response.setCharacterEncoding("UTF-8");
return travelAiService.chatWithTraveler(memoryId, message); }
@RequestMapping("/force-plan") public String forcePlan(HttpServletResponse response, @RequestParam String memoryId) { response.setCharacterEncoding("UTF-8");
return travelAiService.chatWithTraveler(memoryId, "请基于我们到目前为止的所有对话,生成完整详细的行程规划方案"); }}通过系统提示词要求 LLM 先判断信息是否足够。如果不够,就进入信息收集阶段;如果足够,就进入规划生成阶段
- start:开启对话
- chatWithPlanner:对话,可能会要求需求澄清或者给出行程建议
- forcePlan:强行生成旅行建议
元数据过滤
初识
- 元数据(Metadata)是附加到文本块(Chunk)上的结构化信息
- 描述文本块的“数据”。 一个文本块的元数据可以包含:文件名、页码、userid等等
- 切块后保存元数据然后向量化保存到向量数据库
作用
精确过滤:关系型数据库的精确检索和相似度查询的结合
- 同一个问题的描述是不一样的,“如何启动汽车”,2023年版中用钥匙启动,2024年版中,用旋钮启动,2025年通过手机来启动
- 用户这候提问“根据《汽车用户手册(2023年版)》,汽车应该如何启动?”,如果没有元数据,普通的相似度检索,三个版本的文本块仅仅是年份的一个数字不一样,相似度其实都非常高,可能会将这三种都检索到,
- 而将文档的名称存入元数据,当我在进行相似度检索之前,进行一次元数据过滤,这样就可以完全过滤掉2024版和2025版这两个版本的相关文本块,仅仅针对元数据是2023年版的做相似度检索
模型给出的回答,用户无法判断这些内容是否真的来自企业知识库
- 参考来源:《汽车用户手册(2024年版)》第5页
访问权限
将访问权限信息一并写入元数据,
先根据用户身份进行一次元数据过滤,屏蔽掉用户无权访问的文本块,再执行相似度检索。
- 部门id/角色id/用户id
- 保密等级
- 生效时间或版本状态等
入库
public void embedAndStore(List<Document> documents) { for (int i = 0; i < documents.size(); i += 9) { List<Document> batches = documents.subList(i, Math.min(i + 9, documents.size())); vectorStore.add(batches); } }vectorStore.add(batches)不是单纯入库,内部完成向量化再入库
@GetMapping("/embedding") public String embedding(String filePath, String fileName) { //读取文档 List<Document> documents; try { documents = documentReaderFactory.read(new File(filePath)); } catch (IOException e) { throw new RuntimeException(e); } //添加元数据 for (Document document : documents) { document.getMetadata().put("fileName", fileName); }
embeddingService.embedAndStore(documents);
return "success"; }你的 EmbeddingService.embedAndStore(...) ↓vectorStore.add(batches) ↓AbstractObservationVectorStore.add(...) ↓PgVectorStore.doAdd(...) ↓embeddingModel.embed(documents, ...) ↓insertOrUpdateBatch(...) ↓写入 content + metadata + embedding向量化的是 Document.getText(),metadata 不参与向量化,只是跟着一起入库。
过滤
@Override public void afterPropertiesSet() throws Exception {
// 自定义Prompt模板 PromptTemplate promptTemplate = new PromptTemplate(""" 请基于以下提供的参考文档内容,回答用户的问题。 如果参考文档中没有相关信息,请直接说明"没有找到相关信息",不要编造内容。
参考文档内容: {question_answer_context}
用户问题: {query} """);
QuestionAnswerAdvisor questionAnswerAdvisor = QuestionAnswerAdvisor.builder(vectorStore) .searchRequest(SearchRequest.builder().similarityThreshold(0.5).topK(5).build()) .promptTemplate(promptTemplate).build();
this.chatClient = ChatClient.builder(chatModel) // 实现 Logger 的 Advisor .defaultAdvisors(questionAnswerAdvisor) // 设置 ChatClient 中 ChatModel 的 Options 参数 .defaultOptions( DashScopeChatOptions.builder() .withTopP(0.7) .build() ).build(); }@GetMapping("/retrieveAdvisorWithMetadata")public String retrieveAdvisorWithMetadata(String query, String fileName) { return chatClient.prompt(query) .advisors(advisorSpec -> advisorSpec.param("qa_filter_expression", "fileName == '" + fileName + "'")) .call().content();}advisorSpec.param(...) ↓参数进入 ChatClientRequest.context() ↓QuestionAnswerAdvisor.before(...) ↓doGetFilterExpression(...) ↓SearchRequest.filterExpression(...) ↓vectorStore.similaritySearch(...)- filterExpression就是过滤匹配的表达式
- 用户问题 + fileName 条件 -> 只在指定文件里找相似内容
- 阈值similarityThreshold调低
- 不同文档、不同提问方式,这个参数都不太一样,你需要找到一个能够最大程度过滤掉无效文本块、保留相似文本块的参数值,需要反复调试
HyDE
- 传统 RAG: 用户问题 -> 向量检索 -> 基于文档生成答案
- HyDE 流程用户问题 -> LLM 生成假设答案 -> 用假设答案检索真实文档 -> 基于真实文档交给LLM生成最终答案
解决问题
- 用户表达和文档表达不一致 用户说得口语化,文档写得专业化,HyDE 可以把用户问题转换成更接近文档风格的表达。
- 用户问题太短、太模糊 原问题信息少,向量检索效果差。假设答案会补充上下文,让检索更稳定。
混合检索
传统检索
向量检索(如基于向量的语义相似度搜索):
- 能捕捉语义信息,但可能在精确关键词匹配上表现不佳。
- 对训练数据、包括文档的质量、切片和嵌入质量高度依赖,容易受嵌入偏差影响
关键字搜索(如 BM25):
- 依赖文档切分出来的关键词进行匹配。
- 无法理解语义相似但用词不同的查询与文档(例如“汽车” vs “轿车”)。
BM25
- ElasticSearch中倒排索引将“关键词”映射到“文档ID”的数据结构,实现了快速定位候选文档
- BM25(则是在通过倒排索引查找到候选文档后,利用其词频(TF)和逆文档频率(IDF)计算相关性得分并排序的算法。
es部署
docker run -d --name es-node \-p 9200:9200 -p 9300:9300 \-e "discovery.type=single-node" \-e "xpack.security.enabled=false" \docker.elastic.co/elasticsearch/elasticsearch:8.19.10 <!-- 引入elasticsearch --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-elasticsearch</artifactId> </dependency>流程
混合检索融合两者的优势,保持语义理解能力的同时保留关键词匹配的精确性,从而提高检索结果的召回率(Recall)和排序质量(Ranking Quality)
混合检索的常见做法就是并行多路召回 + 结果融合
同一个查询同时送入:关键词检索模块(如 Elasticsearch / BM25)、向量检索模块(如 Milvus / FAISS / PgVector),然后再对对两路结果进行融合排序。
- 加权求和(Score Weighting)
最终得分 = α × 向量得分 + (1−α) × 关键词得分(需归一化得分,α 通常通过实验调优) - **重排序,**包括RRF、Cross-Encoder
@GetMapping("/hybridchat")public String hybridchat(@RequestParam("query") String query) throws Exception { log.info("========开始执行混合检索==========="); // 1. 向量检索获取相似文档 List<Document> vectorDocs = embeddingService.similarSearch(query);
log.info("向量查询检索到 {} 个相关文档,chunkId列表:{}", vectorDocs.size(), vectorDocs.stream() .map(doc -> doc.getMetadata().getOrDefault("chunkId", "unknown").toString()) .collect(Collectors.joining(", ")));
// 2. ES 关键词检索 List<EsDocumentChunk> keywordDocs = esRagService.searchByKeyword(query, 5, true);
log.info("ES 关键词查询检索到 {} 个相关文档,chunkId列表:{}", keywordDocs.size(), keywordDocs.stream() .map(doc -> doc.getMetadata().getOrDefault("chunkId", "unknown").toString()) .collect(Collectors.joining(", ")));
// 3. 根据 id 去重并合并文档 Map<String, String> idToContent = new LinkedHashMap<>();
// 向量检索文档 for (Document doc : vectorDocs) { idToContent.putIfAbsent(doc.getId(), doc.getText()); }
// ES 关键词检索文档 for (EsDocumentChunk doc : keywordDocs) { idToContent.putIfAbsent(doc.getId(), doc.getContent()); }
//RRF融合排序 List<String> mergedContents = rrfFusion(vectorDocs, keywordDocs, 5); log.info("RRF 融合后共 {} 个相关文档块。", mergedContents.size());
// List<String> mergedContents = new ArrayList<>(idToContent.values());// log.info("共检索到 {} 个相关文档块(向量 + 关键词融合)。", mergedContents.size());
// 4. 构建提示词模板 String promptTemplate = """ 请基于以下提供的参考文档内容,回答用户的问题。 如果参考文档中没有相关信息,请直接说明"没有找到相关信息",不要编造内容。 如果有了参考文档内容,请务必尽量回答问题。有可能用户的输入比较随意,你可以先尝试回答用户的问题,猜测他的实际需求,先给出回复,你需要尽量去贴合用户的问题需求。
参考文档: {documents}
用户问题: {question}
""";
// 5. 拼接文档内容 String documentContent = String.join("\n\n=========文档分隔线===========\n\n", mergedContents); log.info("查询到的文档信息:{}", documentContent);
// 6. 填充模板参数 PromptTemplate prompt = new PromptTemplate(promptTemplate); Prompt realPrompt = prompt.create(Map.of("documents", documentContent, "question", query));
// 7. 调用大模型生成回答 String text = chatClient.prompt(realPrompt).call().chatResponse().getResult().getOutput().getText();
return text;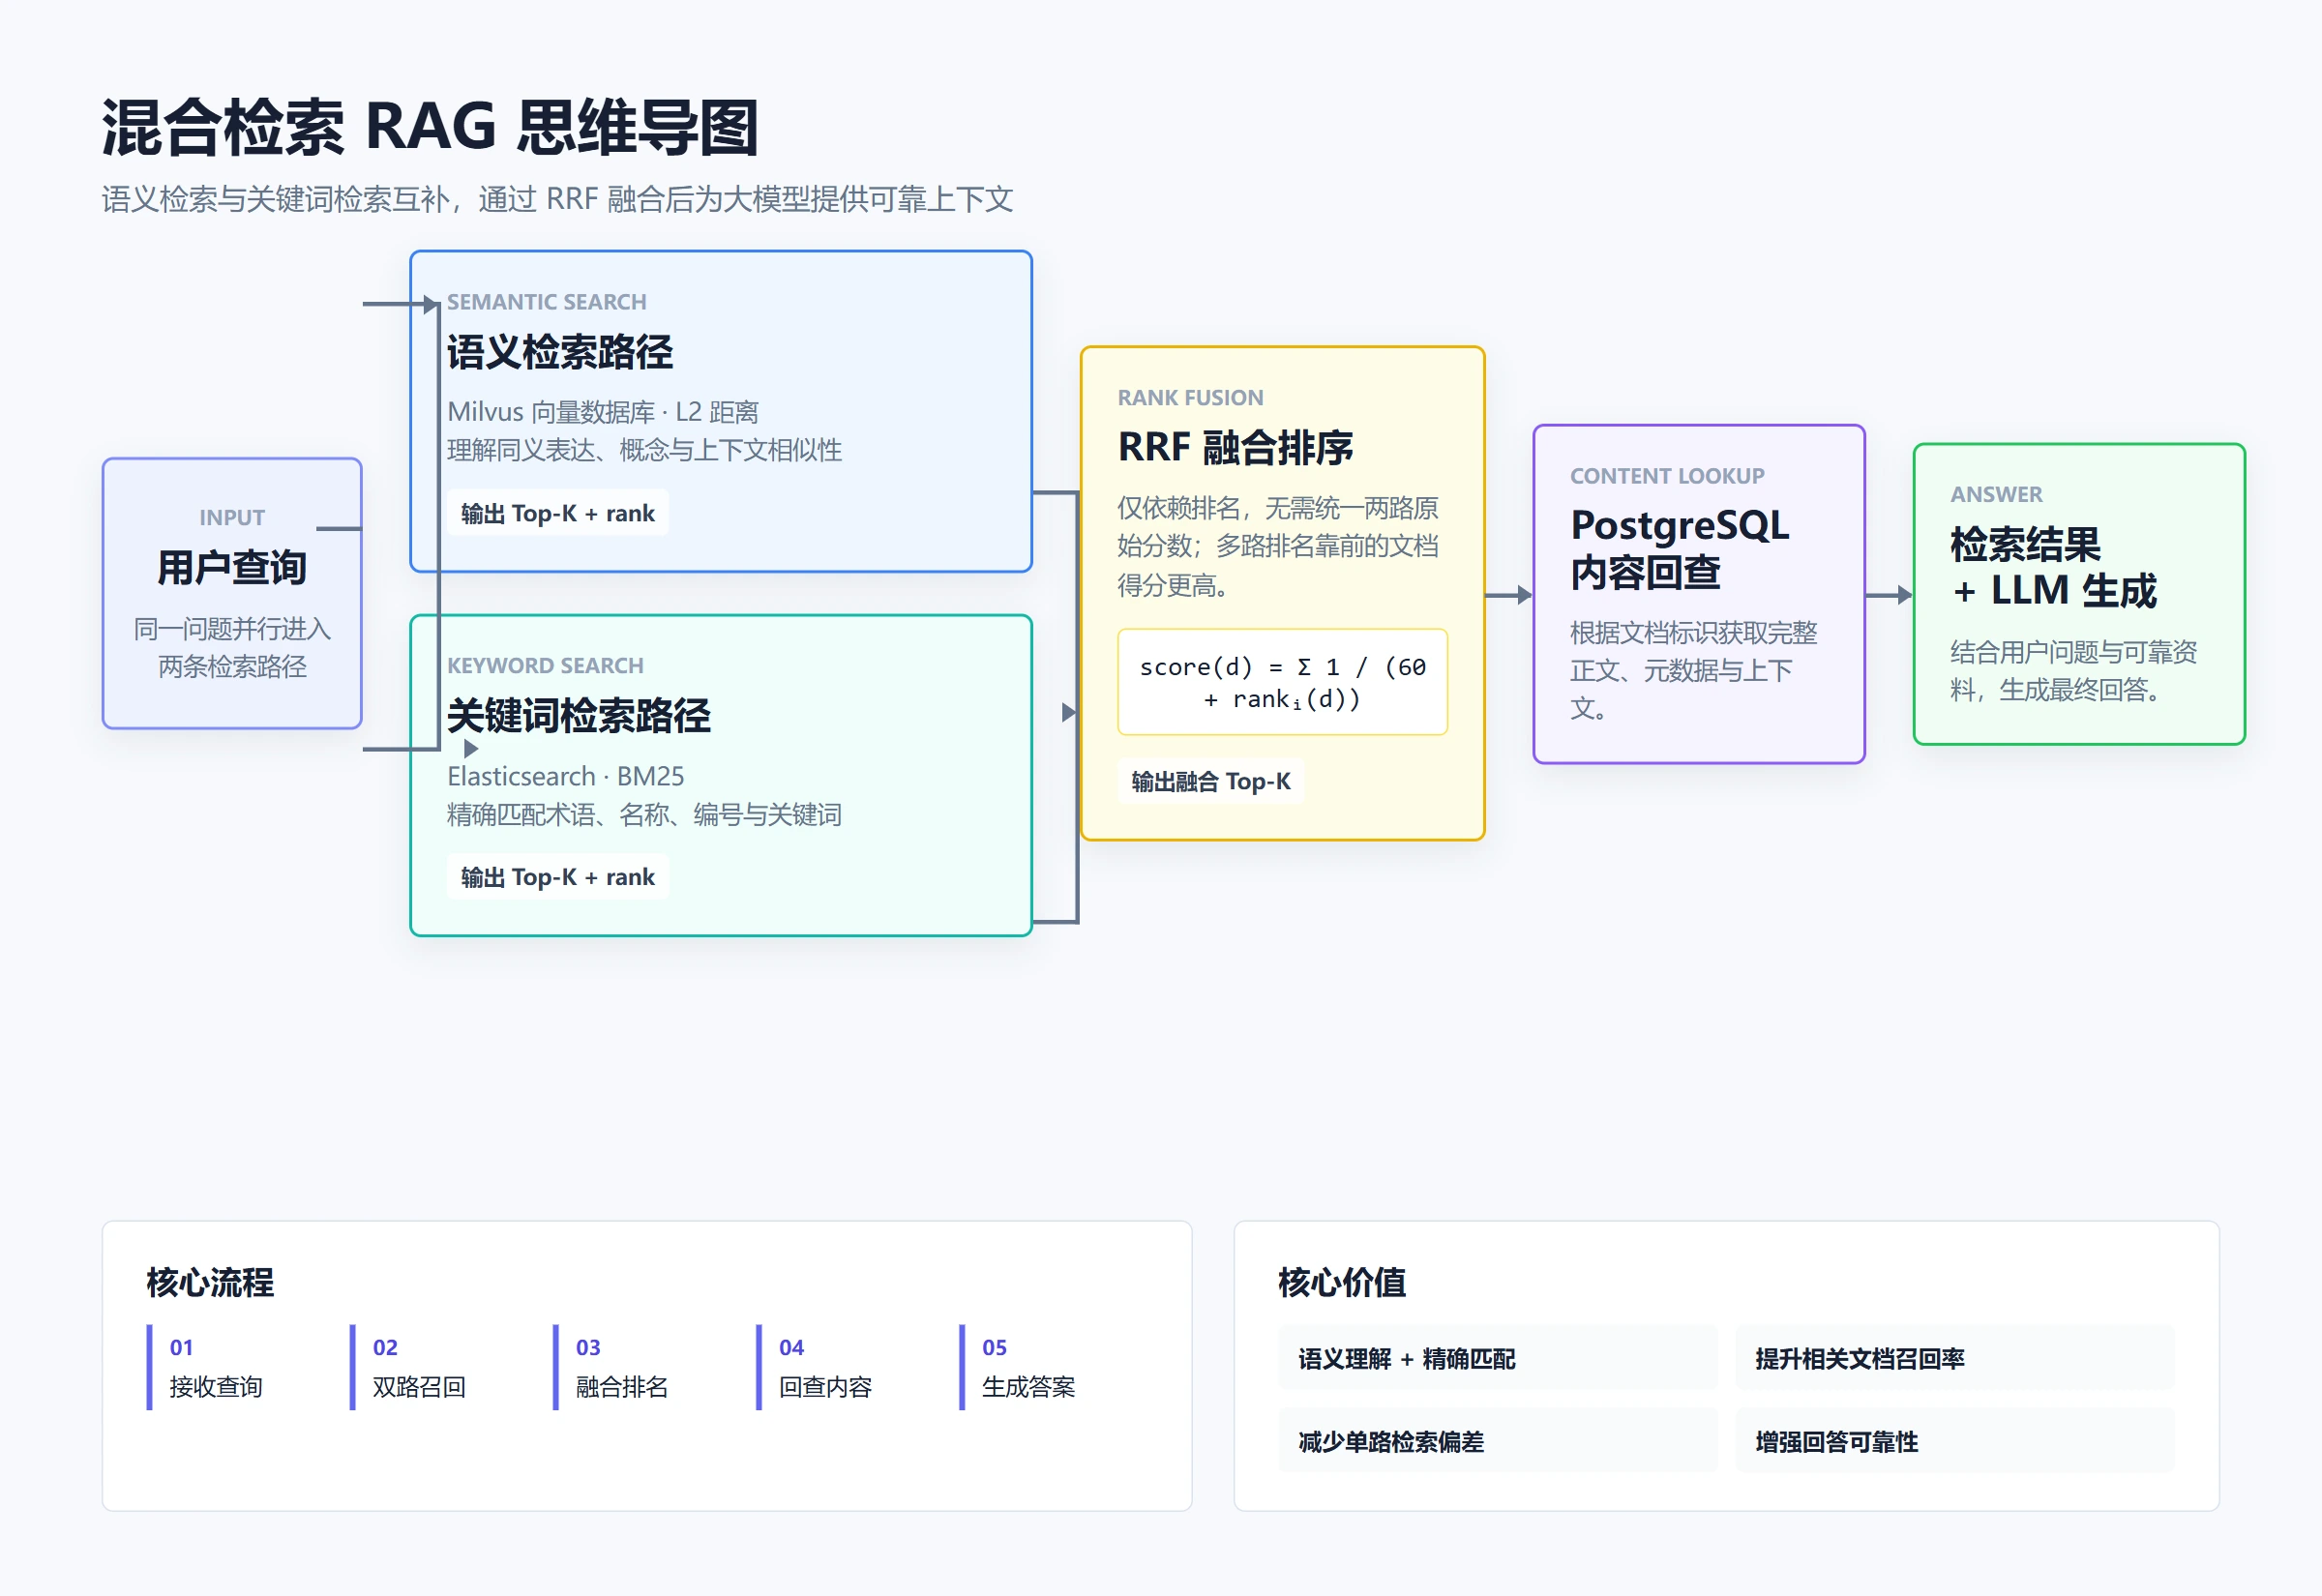
重排序
RRF算法
一个文档在多个排序列表中排名越靠前、出现次数越多其融合得分就越高。
- 无需原始分数**:仅依赖排名,适用于异构系统(如传统 BM25 + 向量检索)。
- 对高排名更敏感:靠前的排名对得分贡献更大(因为是倒数关系)。
- 简单高效:计算开销小,易于实现。
- 实证效果好:在 TREC 等标准评测中表现优异,尤其适合多阶段检索架构。
** * RRF 算法融合向量检索和关键词检索结果 * 公式:RRF Score = Σ(1/(k + rank_i)),其中 k 为常数(通常取60),rank_i 为文档在第i个检索结果中的排名 */private List<String> rrfFusion(List<Document> vectorDocs, List<EsDocumentChunk> keywordDocs, int topK) { // 常数 k,控制低排名文档的权重 final int K = 60; // 存储每个文档ID的RRF得分 Map<String, Double> rrfScores = new HashMap<>(); // 存储文档ID到chunkId的映射 Map<String, String> idToChunkId = new HashMap<>();
// 处理向量检索结果(排名从1开始) for (int i = 0; i < vectorDocs.size(); i++) { Document doc = vectorDocs.get(i); String docId = doc.getId(); // 获取元数据中的chunkId String chunkId = doc.getMetadata().getOrDefault("chunkId", "unknown").toString(); idToChunkId.put(docId, chunkId); // 排名从1开始 int rank = i + 1; double score = 1.0 / (K + rank); rrfScores.put(docId, rrfScores.getOrDefault(docId, 0.0) + score); }
// 处理关键词检索结果(排名从1开始) for (int i = 0; i < keywordDocs.size(); i++) { EsDocumentChunk doc = keywordDocs.get(i); String docId = doc.getId(); // 获取元数据中的chunkId String chunkId = doc.getMetadata().getOrDefault("chunkId", "unknown").toString(); idToChunkId.put(docId, chunkId); // 排名从1开始 int rank = i + 1; double score = 1.0 / (K + rank); rrfScores.put(docId, rrfScores.getOrDefault(docId, 0.0) + score); }
// 收集所有文档ID并按RRF得分降序排序,同时限制返回topK条 List<String> sortedDocIds = rrfScores.entrySet().stream() .sorted(Map.Entry.<String, Double>comparingByValue().reversed()) .map(Map.Entry::getKey) .limit(topK) .collect(Collectors.toList());
// 打印每个文本块的chunkId和分数 String scoresLog = sortedDocIds.stream() .map(docId -> { String chunkId = idToChunkId.getOrDefault(docId, "unknown"); double score = rrfScores.getOrDefault(docId, 0.0); return String.format("chunkId: %s, RRF Score: %.4f", chunkId, score); }) .collect(Collectors.joining("; "));
log.info("RRF融合后top{}结果:{}", topK, scoresLog);
// 构建文档ID到内容的映射 Map<String, String> idToContent = new HashMap<>(); vectorDocs.forEach(doc -> idToContent.putIfAbsent(doc.getId(), doc.getText())); keywordDocs.forEach(doc -> idToContent.putIfAbsent(doc.getId(), doc.getContent()));
// 按排序后的ID提取文档内容 return sortedDocIds.stream() .map(idToContent::get) .filter(Objects::nonNull) .collect(Collectors.toList());}向量检索的文本块排序是0、5、25、15、4,而ES检索的排序是15、25、0、26、3,重排序融合之后的排序就是0、15、25、5、26
ReRank
/** * 使用qwen3-rerank重排序 */private List<String> rerankFusion(List<Document> vectorDocs, List<EsDocumentChunk> keywordDocs, String query, int topK) throws Exception { Map<String, String> idToContent = new LinkedHashMap<>(); Map<String, String> idToChunkId = new HashMap<>();
vectorDocs.forEach(doc -> { String docId = doc.getId(); idToContent.putIfAbsent(docId, doc.getText()); String chunkId = doc.getMetadata().getOrDefault("chunkId", docId).toString(); idToChunkId.putIfAbsent(docId, chunkId); });
keywordDocs.forEach(doc -> { String docId = doc.getId(); idToContent.putIfAbsent(docId, doc.getContent()); String chunkId = doc.getMetadata().getOrDefault("chunkId", docId).toString(); idToChunkId.putIfAbsent(docId, chunkId); });
List<String> documents = new ArrayList<>(idToContent.values()); if (documents.isEmpty()) { log.info("没有检索到任何文档,无需重排序"); return Collections.emptyList(); }
String url = "https://dashscope.aliyuncs.com/api/v1/services/rerank/text-rerank/text-rerank"; HttpHeaders headers = new HttpHeaders(); // 补充自己的apikey headers.set("Authorization", "Bearer sk-xxxxxxxxxxxxxxxxxx"); headers.setContentType(MediaType.APPLICATION_JSON);
Map<String, Object> requestBody = new HashMap<>(); requestBody.put("model", "qwen3-rerank");
Map<String, Object> input = new HashMap<>(); input.put("query", query); input.put("documents", documents); requestBody.put("input", input);
Map<String, Object> parameters = new HashMap<>(); parameters.put("return_documents", true); parameters.put("top_n", topK); parameters.put("instruct", "Given a web search query, retrieve relevant passages that answer the query."); requestBody.put("parameters", parameters);
HttpEntity<Map<String, Object>> request = new HttpEntity<>(requestBody, headers); RestTemplate restTemplate = new RestTemplate(); restTemplate.setRequestFactory(new SimpleClientHttpRequestFactory() {{ setConnectTimeout(5000); setReadTimeout(10000); }});
ResponseEntity<Map> response = restTemplate.postForEntity(url, request, Map.class);
if (!response.getStatusCode().is2xxSuccessful()) { throw new RuntimeException("重排序API调用失败: " + response.getStatusCode() + ",响应: " + response.getBody()); }
Map<String, Object> responseBody = response.getBody(); if (responseBody == null || !responseBody.containsKey("output")) { throw new RuntimeException("API响应格式异常,缺少output字段: " + responseBody); }
Map<String, Object> output = (Map<String, Object>) responseBody.get("output"); List<Map<String, Object>> rerankedResults = (List<Map<String, Object>>) output.get("results"); if (rerankedResults == null || rerankedResults.isEmpty()) { log.warn("重排序返回空结果: {}", output); return Collections.emptyList(); }
List<String> result = new ArrayList<>(); List<String> rankLogs = new ArrayList<>();
for (int i = 0; i < rerankedResults.size(); i++) { Map<String, Object> item = rerankedResults.get(i); String text = (String) ((Map<String, Object>) item.get("document")).get("text"); Double score = null; if (item.containsKey("relevance_score")) { score = ((Number) item.get("relevance_score")).doubleValue(); } else if (item.containsKey("score")) { score = ((Number) item.get("score")).doubleValue(); }
if (text != null) { result.add(text);
String matchedChunkId = "unknown"; for (Map.Entry<String, String> entry : idToContent.entrySet()) { if (entry.getValue().equals(text)) { matchedChunkId = idToChunkId.getOrDefault(entry.getKey(), "unknown"); break; } }
rankLogs.add(String.format("排名 %d: chunkId=%s, 分数=%.4f", i + 1, matchedChunkId, score != null ? score : 0.0)); } }
log.info("qwen3-rerank重排序结果:{}", String.join("; ", rankLogs)); log.info("重排序后返回{}条文档,原始合并{}条", result.size(), documents.size());
return result;}- ReRank 模型通常基于专门训练的语义匹配模型(如 Cross-Encoder 或特化的语义排序模型),它会同时输入**“查询 + 文本”进行相关性评分,因此本质上更偏向于语义层面的匹配**
- RRF 负责“先混起来”,rerank 模型负责“再精排”
GraghRAG
知识图谱
GraghRAG:多跳问题可采用问题拆解
GraphRAG和传统RAG的主要区别就是会借助图数据库和知识图谱技术,抽取文档中的实体之间的关系,构建一个图结构,不再依赖相似度检索,而是改用图的拓扑结构来定位相关信息。
图数据库是一种专门用于存储、查询和管理图结构数据的 NoSQL 数据库
- 节点(Node):表示实体,如“用户”、“商品”、“城市”。
- 边(Edge / Relationship):表示节点之间的关系,如“购买”、“关注”、“位于”。边是有方向的(可选),并可携带属性。
- 属性(Property):键值对,用于描述节点或边的特征,如 {name: “张三”, age: 30}
多跳图查询,我们需要在 Neo4j 中执行以下逻辑:
- 找到电影《十面埋伏》
- 找到导演了这部电影的导演。
- 找出该导演还导演了哪些其他电影。
Neo4J 部署
docker run \ --name neo4j \ -p 7474:7474 -p 7687:7687 \ -v $HOME/neo4j/data:/data \ -v $HOME/neo4j/logs:/logs \ -v $HOME/neo4j/conf:/conf \ -e NEO4J_AUTH=neo4j/neo4j666 \ -e NEO4JLABS_PLUGINS='["apoc"]' \ -d neo4j:5.22-communityNeo4J接入
依赖
<dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-neo4j</artifactId></dependency>配置
spring: neo4j: uri: bolt://localhost:7687 authentication: username: neo4j password: your_password节点
@Node("Director")public class Director { @Id private String name;
public Director() { }
public Director(String name) { this.name = name; }
public String getName() { return name; }}@Node("Movie")public class Movie { @Id private String title;
private int year;
public Movie() { }
public Movie(String title, int year) { this.title = title; this.year = year; }
// Getters public String getTitle() { return title; }
public int getYear() { return year; }}关系
创建 Repository(操作sql)
@Repositorypublic interface MovieGraphRepository extends Neo4jRepository<Movie, String> { @Query(""" MATCH (m:Movie {title: $title}) <-[:DIRECTED]- (d:Director) -[:DIRECTED]-> (other:Movie) WHERE other.title <> $title RETURN d.name AS director, collect(other.title + ' (' + other.year + ')') AS otherMovies """) List<DirectorMoviesDto> findOtherMoviesBySameDirector(String title);
}返回值我们封装成DirectorMoviesDto
public class DirectorMoviesDto { private String director; private List<String> otherMovies;
public DirectorMoviesDto() { }
public DirectorMoviesDto(String director, List<String> otherMovies) { this.director = director; this.otherMovies = otherMovies; }
public String getDirector() { return director; }
public void setDirector(String director) { this.director = director; }
public List<String> getOtherMovies() { return otherMovies; }
public void setOtherMovies(List<String> otherMovies) { this.otherMovies = otherMovies; }}定义Service
@Servicepublic class GraphService {
@Autowired private MovieGraphRepository repository;
public String retrieveContext(String movieName) { //承接 List<DirectorMoviesDto> results = repository.findOtherMoviesBySameDirector(movieName);
if (results.isEmpty()) { return "未找到导演过《" + movieName + "》的导演的其他作品。"; }
StringBuilder sb = new StringBuilder(); for (Map<String, Object> row : results) { String director = (String) row.get("director"); @SuppressWarnings("unchecked") List<String> movies = (List<String>) row.get("otherMovies"); sb.append(String.format("- 导演 %s 还执导了:%s\n", director, String.join("、", movies))); } return sb.toString().trim();
}
}定义Controller,先做数据初始化
@RequestMapping("/rag/graph")@RestControllerpublic class GraphRagController {
@Autowired private Neo4jTemplate neo4jTemplate;
@Autowired private Neo4jClient neo4jClient;
@GetMapping("/init") public String initData() { // 保存节点 neo4jTemplate.save(new Director("张艺谋")); neo4jTemplate.save(new Director("陈思诚")); neo4jTemplate.save(new Movie("十面埋伏", 2004)); neo4jTemplate.save(new Movie("影", 2016)); neo4jTemplate.save(new Movie("英雄", 2002)); neo4jTemplate.save(new Movie("误杀", 2019));
neo4jClient.query(""" MATCH (p:Director {name: $name}), (m:Movie {title: $title}) MERGE (p)-[:DIRECTED]->(m) """) .bind("张艺谋").to("name") .bind("十面埋伏").to("title") .run(); neo4jClient.query(""" MATCH (p:Director {name: $name}), (m:Movie {title: $title}) MERGE (p)-[:DIRECTED]->(m) """) .bind("张艺谋").to("name") .bind("影").to("title") .run();
neo4jClient.query(""" MATCH (p:Director {name: $name}), (m:Movie {title: $title}) MERGE (p)-[:DIRECTED]->(m) """) .bind("张艺谋").to("name") .bind("英雄").to("title") .run(); neo4jClient.query(""" MATCH (p:Director {name: $name}), (m:Movie {title: $title}) MERGE (p)-[:DIRECTED]->(m) """) .bind("陈思诚").to("name") .bind("误杀").to("title") .run();
return "Data initialized successfully"; }}做图数据库检索及回答
@RequestMapping("/rag/graph")@RestControllerpublic class GraphRagController {
@Autowired private GraphService graphService;
@Autowired private ChatModel chatModel;
@GetMapping("/ask") public String ask(@RequestBody String movieName) {
String context = graphService.retrieveContext(movieName);
String prompt = """ 你是一个电影知识助手,请根据以下上下文回答问题。 如果上下文没有足够信息,请回答“我不知道”。
上下文: %s
问题:%s 回答: """.formatted(context, movieName + "的导演还执导过哪些电影?");
return chatModel.call(prompt); }}
节点
- @Node(“Movie”)表示这个 Java 类对应 Neo4j 里的 Movie节点标签;
- @Id表示唯一标识。这里用电影
title、导演 name 做主键,是为了后面能通过名字精确匹配节点
关系
- MovieGraphRepository负责图查询。它继承 Neo4jRepository<Movie, String>
- 说明主操作对象是 Movie,主键类型是 String。真正关键的是
@Query里的 Cyphe
DirectorMoviesDto 是查询结果 DTO。它把 director 和 otherMovies 封装起来,方便 Service 使用
Service
GraphService.retrieveContext()是 RAG 里的“检索层”。它不直接回答问题,而是把 Neo4j 查到的事实整理成文本上下文
初始化
-
用 Neo4jTemplate.save() 保存节点。
-
用
Neo4jClient.query()执行 Cypher,创建DIRECTED关系。 -
Repository 中写
@Query,完成“电影 -> 导演 -> 其他电影”的多跳查询。 -
Service 把查询结果整理成文本上下文。
-
Controller 把上下文拼进 Prompt,再调用
ChatModel生成自然语言回答
ModularRAG
SpringAi
RetrievalAugmentationAdvisor 封装了完整的 RAG 流程
- 查询预处理(查询重写、查询扩展等)
- 文档检索(从向量数据库做检索)
- 上下文后处理(如文档合并等)
- 提示增强(将检索结果与用户问题合并)
@GetMapping("/chatWithAdvistor")public String chatWithAdvistor(@RequestParam("query") String query, @RequestParam("fileName") String fileName) { //问题改写 RewriteQueryTransformer queryTransformer = RewriteQueryTransformer.builder() .chatClientBuilder(ChatClient.builder(chatModel)) .promptTemplate(new PromptTemplate(""" Given a user query, rewrite it to provide better results when querying a {target}. Remove any irrelevant information, and ensure the query is concise and specific. 如果有表述不清的内容,或者错别字,请修正,如"华子",修改为"华为"
Original query: {query}
Rewritten query: """)) .build();
//问题扩展 QueryExpander queryExpander = MultiQueryExpander.builder() .chatClientBuilder(ChatClient.builder(chatModel)) .numberOfQueries(3) .includeOriginal(true) .build();
//向量检索DocumentRetriever retriever = VectorStoreDocumentRetriever.builder() .vectorStore(vectorStore) // 必需:绑定向量存储 .topK(5) // 返回最相似的 5 个文档 .similarityThreshold(0.6) // 相似度低于 0.6 的过滤掉 .filterExpression("source == 'docs.spring.io'") // 元数据过滤表达式 .build();
QueryAugmenter queryAugmenter = ContextualQueryAugmenter.builder() .allowEmptyContext(true) .emptyContextPromptTemplate(new PromptTemplate("请回答以下用户问题")) .build();
//Advisor分发地Advisor advisor = RetrievalAugmentationAdvisor.builder() // 检索阶段:从向量库检索文档(必需) .documentRetriever(retriever) //向量库检索 // 查询预处理:转换查询(可选) .queryTransformers(queryTransformer) ////问题改写利用提示词模板 // 查询预处理:扩展查询(可选) .queryExpander(queryExpander) //一个查询扩展成多个查询 // 后处理阶段:合并文档(当使用查询扩展时推荐) .documentJoiner(documentJoiner) //文档合并 // 生成阶段:构建增强提示词(可选,有默认实现) .queryAugmenter(queryAugmenter) //构建增强提示词 .build();
//响应数据 return chatClient.prompt(query).advisors(advisor).call().content(); String answer = chatClient.prompt() .advisors(retrievalAugmentationAdvisor) //元数据过滤 .advisors(a -> a.param(VectorStoreDocumentRetriever.FILTER_EXPRESSION, "fileName == '" + fileName + "'")) .user(query) .call() .content(); return answer;}- 检索前用 QueryTransformer
和QueryExpander 改造问题 - 检索中用 DocumentRetriever 从向量库取文档
- 检索后用 DocumentJoiner 合并、去重、排序
- 生成前用
QueryAugmenter把文档和问题拼成最终 Prompt
LangChain4j
初识
- LangChain4J中提供了RetrievalAugmentor接口,
- 默认的实现DefaultRetrievalAugmentor,和Spring AI中的RetrievalAugmentationAdvisor类似
DefaultRetrievalAugmentor augmentor =DefaultRetrievalAugmentor.builder()// 1. ContentRetriever - 从向量数据库或其他数据源检索内容(必需).contentRetriever(EmbeddingStoreContentRetriever.builder() .embeddingStore(embeddingStore) // 向量数据库 .embeddingModel(embeddingModel) // 向量模型 .maxResults(5) // 返回Top-K结果 .minScore(0.7) // 最小相似度阈值 .build())
// 2. QueryTransformer - 查询转换器(可选).queryTransformer(queryTransformer)
// 3. QueryRouter - 查询路由器(可选).queryRouter(queryRouter)
// 4. ContentAggregator - 内容聚合器(可选).contentAggregator((contentAggregator)
// 5. ContentInjector - 内容注入器(可选).contentInjector(contentInjector)
.build();DefaultRetrievalAugmentor注入到AiServices中:
AiServices.builder(LangChainAiService.class) .chatModel(chatModel) .chatMemoryProvider(memoryId -> MessageWindowChatMemory.withMaxMessages(10)) .retrievalAugmentor(DefaultRetrievalAugmentor.builder().build()) .build(); //8.调用AI服务 return langChainAiService.chat(query);转换
QueryTransformer是检索前处理。它的接口返回的是 Collection
| 类名 | 作用 | 说明 |
|---|---|---|
| DefaultQueryTransformer` | 不修改问题 | 原样返回,不做任何处理 |
CompressingQueryTransformer | 压缩追问 | 结合历史对话,将追问压缩成独立问题 |
CompressionQueryTransformer | 压缩问题 | 将当前问题整理为更简洁、独立的表达 |
ExpandingQueryTransformer | 扩展问题 | 把一个问题扩展成多个相关问题 |
MultiQueryExpander | 多查询扩展 | 生成多个相关查询,用于提升召回或覆盖面 |
检索
- ContentRetriever必须要有
- ContentRetriever是QueryRouter接口实现,路由到检索路径
- ContentRetriever和QueryRouter只能传一个会覆盖
- 检索器需要指定向量模型与向量存储
ContentRetriever retriever = EmbeddingStoreContentRetriever.builder() // 向量数据库实例 .embeddingStore(embeddingStore)
// 向量模型(用于查询向量化) .embeddingModel(embeddingModel)
// 返回Top-K结果,默认3 .maxResults(5)
//最小相似度阈值(0.0-1.0),低于此分数的结果会被过滤 .minScore(0.7) .build();EmbeddingStoreContentRetriever用于从向量数据库检索相关内容的核心组件实现了 ContentRetriever 接口
向量存储
默认实现基于内存的
https://github.com/langchain4j/langchain4j/tree/main/docs/docs/integrations/embedding-stores
向量模型
https://github.com/langchain4j/langchain4j/tree/main/docs/docs/integrations/embedding-models
WebSearch
WebSearchContentRetriever 是 LangChain4j 框架中用于从互联网搜索引擎检索实时信息的 RAG 组件
路由
Query 应该交给哪些检索器。
默认实现
QueryRouter router = new DefaultQueryRouter(vectorRetriever, webRetriever);返回值是集合
QueryRouter queryRouter = query -> { String text = query.text();
if (text.contains("最新") || text.contains("今天") || text.contains("现在")) { return List.of(webRetriever); }
return List.of(vectorRetriever);};智能路由
LanguageModelQueryRouter router = LanguageModelQueryRouter.builder() .chatModel(chatModel) .retriever(vectorRetriever, "适合查询本地知识库、产品文档、历史资料") .retriever(webRetriever, "适合查询实时新闻、今天、最新信息") .build();融合
ContentAggregator 负责把多路检索结果合成最终的一组内容
两段rrf融合
- 第一阶段先融合同一个 Query 下多个 Retriever 的结果
- 第二阶段再融合多个 Query 的结果
ReRankingContentAggregator在RRF融合之后的ReRank
ScoringModel scoringModel = JinaScoringModel.builder() .apiKey(System.getenv("JINA_API_KEY")) .modelName("jina-reranker-v2-base-multilingual") .build();
ContentAggregator aggregator = ReRankingContentAggregator.builder() .scoringModel(scoringModel) .minScore(0.6) .maxResults(5) .build();插入
- 把检索到的内容注入用户消息
- Spring AI 是生成一个增强后的 Query,LangChain4j 是增强 UserMessage
ContentInjector contentInjector = DefaultContentInjector.builder() .promptTemplate(PromptTemplate.from(""" {{userMessage}}
请只根据以下参考资料回答。如果资料不足,请说明不知道。
{{contents}} """)) .metadataKeysToInclude(List.of("source", "file_name")) .build();DefaultRetrievalAugmentor 的核心源码在 augment()
先把用户消息封装成 Query
process()方法
当只有一个 Query 和一个 Retriever 时,它直接同步执行;当出现多 Query 或多 Retriever 时,自动用线程池并行检索
加载文档loadDocument(filePath, new ApacheTikaDocumentParser())
QueryTransformer做压缩或扩展- 通过
QueryRouter决定走哪些检索器; - 每个
ContentRetriever从向量库、Web、SQL、图数据库等数据源取回内容;ContentAggregator对多路结果做 RRF 融合或 rerank;最后ContentInjector把内容拼回用户消息,再交给大模型生成回答。
@RequestMapping("/retrieve1") public String retrieve1(HttpServletResponse response, String query, String filePath) { response.setCharacterEncoding("UTF-8");
// 1. 配置 Embedding 模型 OpenAiEmbeddingModel embeddingModel = OpenAiEmbeddingModel.builder() .modelName("text-embedding-v3") .dimensions(768) .baseUrl("https://dashscope.aliyuncs.com/compatible-mode/v1") .maxSegmentsPerBatch(9) .apiKey("sk-0227f9a97bef4f2c8fc899d82831aa25") .build();
// 2. 加载文档并生成 Embeddings InMemoryEmbeddingStore<TextSegment> embeddingStore = new InMemoryEmbeddingStore<>(); EmbeddingStoreIngestor.builder() .documentSplitter(DocumentSplitters.recursive(300, 50)) .embeddingModel(embeddingModel) .embeddingStore(embeddingStore) .build() .ingest(loadDocument(filePath, new ApacheTikaDocumentParser()));
// 3. 构建 RAG 增强器(使用链式调用) DefaultRetrievalAugmentor retrievalAugmentor = DefaultRetrievalAugmentor.builder() .contentRetriever(EmbeddingStoreContentRetriever.builder() .embeddingStore(embeddingStore) .embeddingModel(embeddingModel) .maxResults(5) .minScore(0.7) .build())
.contentInjector(new DefaultContentInjector(new PromptTemplate(""" ## 角色定位 你是一位专业的RAG问答助手。请根据提供的上下文信息,详细、准确地回答用户的问题。如果参考文档没有内容,请务必不要胡编乱造,请直接说明"没有找到相关信息"。
## 任务要求: 1. 请基于以下提供的参考文档内容,回答用户的问题。 2. 如果参考文档中没有相关信息,请直接说明"没有找到相关信息",不要编造内容。 3. 如果有了参考文档内容,请务必尽量回答问题。有可能用户的输入比较随意,你可以先尝试回答用户的问题,猜测他的实际需求,先给出回复,你需要尽量去贴合用户的问题需求。
## 格式要求: 1. 你的所有回答必须使用Markdown格式进行排版。 2. 上下文信息中包含了图片描述标签,格式为:`<image src="URL" description="多模态描述"></image>`。 3. 如果图片与用户提问高度相关,请将此标签转换为标准的Markdown图片格式 ``。 4. 仅在必要时包含图片,请注意千万不要输出重复的内容和图片,图片确保最终生成的URL不要重复。
## 参考文档: {{contents}}
## 用户问题: {{userMessage}}
注意:如果参考文档下面的内容为空,请直接回答“没有找到相关信息”。 """))) .build();
// 4. 构建 AI 服务并返回结果 return AiServices.builder(LangChainAiService.class) .chatModel(chatModel) .retrievalAugmentor(retrievalAugmentor) .chatMemory(MessageWindowChatMemory.withMaxMessages(10)) .build() .chat(query); }多模态RAG
调用
图片 + 问题 -> 多模态大模型 -> 图片描述文本
@RequestMapping("/callWithOpenAI") public String callWithOpenAI() throws URISyntaxException, MalformedURLException {
OpenAiChatOptions options = OpenAiChatOptions.builder().temperature(0.2d).model("qwen3-vl-plus").build(); OpenAiChatModel multimodalChatModel = OpenAiChatModel.builder().openAiApi(OpenAiApi.builder().baseUrl("https://dashscope.aliyuncs.com/compatible-mode/").apiKey(new SimpleApiKey("sk-8ef405c4686e456e91f6698272253126")).build()).defaultOptions(options).build();
List<Media> mediaList = List.of(new Media(MimeTypeUtils.IMAGE_PNG, new URI("https://cdn.nlark.com/yuque/0/2025/png/5378072/1762350625634-664f1db7-e1c9-4daa-ab8e-81b6b7da5a68.png").toURL().toURI()));
var userMessage = UserMessage.builder().text("请非常简要的描述一下你看到的这个图片?").media(mediaList).build(); var response = multimodalChatModel.call(new Prompt(List.of(userMessage)));
return response.getResult().getOutput().getText(); }- 设置模型,tempreture参数控制回答随机性,越低越稳定
- UserMessage需要填写两个参数,一个是提示词,就是你需要对这个图片怎么样去分析
- media表示你真正的图片资源。
Spring Ai Alibaba提供的DashScopeChatMode
@Autowiredprivate ChatModel chatModel;
@RequestMapping("/callWithSpringAiAlibaba")public String callWithSpringAiAlibaba() throws URISyntaxException, MalformedURLException { List<Media> mediaList = List.of(new Media(MimeTypeUtils.IMAGE_PNG, new URI("https://cdn.nlark.com/yuque/0/2025/png/5378072/1762350625634-664f1db7-e1c9-4daa-ab8e-81b6b7da5a68.png").toURL().toURI()));
var userMessage = UserMessage.builder().text("请详细的描述一下你看到的这个图片?").media(mediaList).build();
return chatModel.call(new Prompt(userMessage, DashScopeChatOptions.builder().withModel("qwen3-vl-plus").withMultiModel(true).build())).getResult().getOutput().getText();}使用chatModel时,必须要增加参数withMultiModel(true)
Mimo部署
MinIO 是一个高性能、开源的对象存储系统,兼容 Amazon S3 云存储服务接口
sudo docker run -d \ -p 9000:9000 \ -p 9001:9001 \ --name minio-server \ -e "MINIO_ROOT_USER=minioadmin" \ -e "MINIO_ROOT_PASSWORD=minioadmin" \ -v /mnt/data/minio:/data \ minio/minio server /data --console-address ":9001"接入Mimo
<dependency> <groupId>io.minio</groupId> <artifactId>minio</artifactId> <version>8.5.1</version></dependency>minio: url: http://localhost:9001 accessKey: minioadmin secretKey: minioadmin bucketName: a-bucket endpoint: http://localhost:9001定义配置类
@Configurationpublic class MinioConfiguration {
private static final Logger logger = LoggerFactory.getLogger(MinioConfiguration.class);
@Value("${minio.endpoint}") private String endpoint;
@Value("${minio.access-key}") private String accessKey;
@Value("${minio.secret-key}") private String secretKey;
@Bean @Lazy public MinioClient minioClient() { try { return MinioClient.builder() .endpoint(endpoint) .credentials(accessKey, secretKey) .build(); } catch (Exception e) { logger.warn("Failed to create MinIO client: {}. MinIO functionality will be unavailable.", e.getMessage()); return null; } }}定义minIO工具类
@Servicepublic class MinioService {
private final MinioClient minioClient;
@Value("${minio.bucket}") private String bucketName;
@Value("${minio.endpoint}") private String endpoint;
public MinioService(MinioClient minioClient) { this.minioClient = minioClient; }
// 确保 bucket 存在 private void createBucketIfNotExists() throws Exception { if (!minioClient.bucketExists(BucketExistsArgs.builder().bucket(bucketName).build())) { minioClient.makeBucket(MakeBucketArgs.builder().bucket(bucketName).build()); } }
// 上传文件 public String uploadFile(MultipartFile file, String objectName) throws Exception { createBucketIfNotExists(); minioClient.putObject(PutObjectArgs.builder() .bucket(bucketName) .object(objectName) .stream(file.getInputStream(), file.getSize(), -1) .contentType(file.getContentType()) .build()); return String.format("%s/%s/%s", endpoint, bucketName, objectName);
}
/** * 上传文件 */ public String uploadFile(String objectName, byte[] content, String contentType) throws Exception { createBucketIfNotExists(); try (InputStream stream = new ByteArrayInputStream(content)) { minioClient.putObject( PutObjectArgs.builder() .bucket(bucketName) .object(objectName) .stream(stream, content.length, -1) .contentType(contentType) .build() );
return String.format("%s/%s/%s", endpoint, bucketName, objectName); } }
// 下载文件(返回 InputStream) public InputStream downloadFile(String objectName) throws Exception { GetObjectResponse response = minioClient.getObject( GetObjectArgs.builder() .bucket(bucketName) .object(objectName) .build()); return response; }
// 删除文件 public void deleteFile(String objectName) throws Exception { minioClient.removeObject(RemoveObjectArgs.builder() .bucket(bucketName) .object(objectName) .build()); }
// 生成临时下载链接(带签名,有效期 7 天) public String getPresignedUrl(String objectName) throws Exception { return minioClient.getPresignedObjectUrl( GetPresignedObjectUrlArgs.builder() .method(Method.GET) .bucket(bucketName) .object(objectName) .expiry(7, TimeUnit.DAYS) .build()); }}Controller
@RestController@RequestMapping("/files")public class FileController {
@Autowired private MinioService minioService;
@PostMapping("/upload") public ResponseEntity<String> uploadFile(@RequestParam("file") MultipartFile file) { try { String objectName = System.currentTimeMillis() + "_" + file.getOriginalFilename(); minioService.uploadFile(file, objectName); return ResponseEntity.ok("上传成功: " + objectName); } catch (Exception e) { e.printStackTrace(); return ResponseEntity.status(500).body("上传失败: " + e.getMessage()); } }
@GetMapping("/download-url/{objectName}") public ResponseEntity<String> getDownloadUrl(@PathVariable String objectName) { try { String url = minioService.getPresignedUrl(objectName); return ResponseEntity.ok(url); } catch (Exception e) { return ResponseEntity.status(500).body("生成下载链接失败"); } }}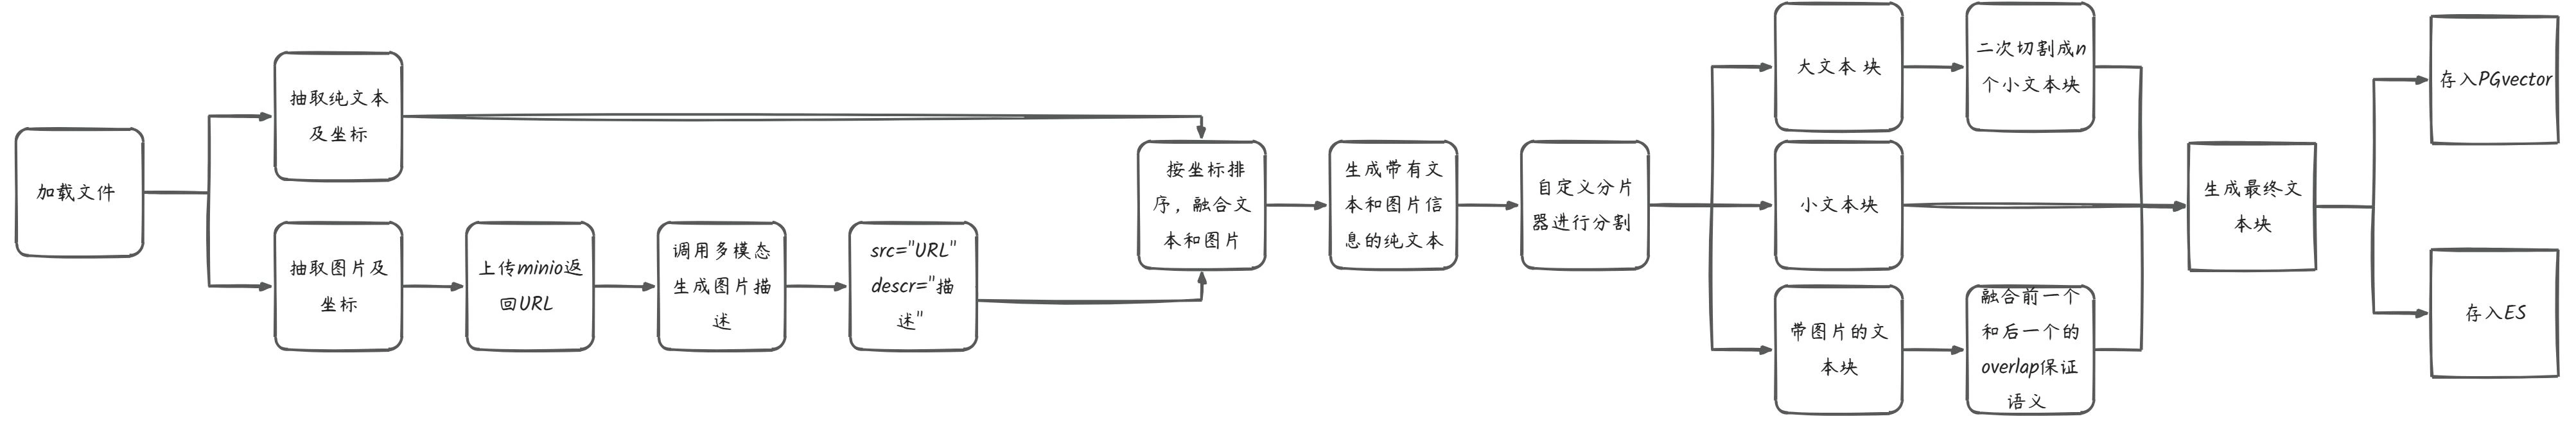
Agentic RAG
Agent
初识
一个Agent =
- 大脑(LLM)
- 手脚(Tools / MCP)
- 记忆(Memory)
- 规划(Planning / Workflow)
ReAct
初识
Thought → Action → Observation → Thought → … → 完成
- Thought(思考):分析当前状态,决定下一步
- Action(行动):调用工具/API
- Observation(观察):拿到返回结果,进入下一轮思考
特点
- ✅ 动态自适应:每一步都根据最新结果调整策略
- ✅ 适合不确定/探索性任务:实时信息、多跳问答、环境多变
- ❌ 效率低、调用多:走一步看一步,容易绕圈、目标漂移
SpringAi
- 要让LLM按照ReAct的方式运行
- 通过while让Agent的”思考结果”、“行动”等串起来
- 默认情况下spring ai会自动调用工具,所以我们需要把他设置为不自动调用
@GetMapping("/chat")public String chat(String conversationId) { //定义ChatOptions ChatOptions chatOptions = ToolCallingChatOptions.builder() //指定工具 .toolCallbacks(ToolCallbacks.from(new StockTools())) //指定不自动执行工具 .internalToolExecutionEnabled(false) .build();
//定义提示词,要求按照React架构运行 Prompt prompt = new Prompt( List.of(new SystemMessage("你是一个基于React架构(Reasoning-Act-Observation)的智能助手,你擅长使用工具帮我解决问题。" + "你的工作流程是:" + "1、思考:先根据用户的提问进行思考,推理出下一步需要进行的具体系统" + "2、行动:做具体的行动,这一步可以使用工具" + "3、观察:记录前一步行动的结果。你可以进行多轮思考和行动。如果要使用工具,请务必调用工具,不要自己随便捏造结果。"), new UserMessage("帮我分析最近三个月特斯拉(TSLA)的股价走势,并结合新闻事件解释可能的影响因素。")), chatOptions);
//添加提示词到记忆 chatMemory.add(conversationId, prompt.getInstructions());
Prompt promptWithMemory = new Prompt(chatMemory.get(conversationId), chatOptions);
//调用模型 ChatResponse chatResponse = chatModel.call(promptWithMemory);
//添加模型返回结果到记忆 chatMemory.add(conversationId, chatResponse.getResult().getOutput());
//循环处理工具调用 while (chatResponse.hasToolCalls()) { //执行工具调用 ToolExecutionResult toolExecutionResult = toolCallingManager.executeToolCalls(promptWithMemory, chatResponse);
//添加工具调用结果到记忆 chatMemory.add(conversationId, toolExecutionResult.conversationHistory() .get(toolExecutionResult.conversationHistory().size() - 1));
//创建新的提示词 promptWithMemory = new Prompt(chatMemory.get(conversationId), chatOptions);
//调用模型 chatResponse = chatModel.call(promptWithMemory);
//添加模型返回结果到记忆 chatMemory.add(conversationId, chatResponse.getResult().getOutput()); }
for (Message message11 : chatMemory.get(conversationId)) { System.out.println(message11); }
return chatResponse.getResult().getOutput().getText();}Alibaba
初识
ReactAgent 是基于 Graph 运行
持续的推理和工具调用的循环
- Model Node (模型节点)<上下文>(包括历史对话、工具描述和最近的观察结果)进行推理和决策,决定下一步是使用哪个工具、使用什么参数
- Tool Node (工具节点)<会执行实际的工具函数调用>,并捕获执行结果
- Hook Nodes (钩子节点)<关键位置>(如模型调用前、工具调用后)插入自定义的逻辑类似advisor
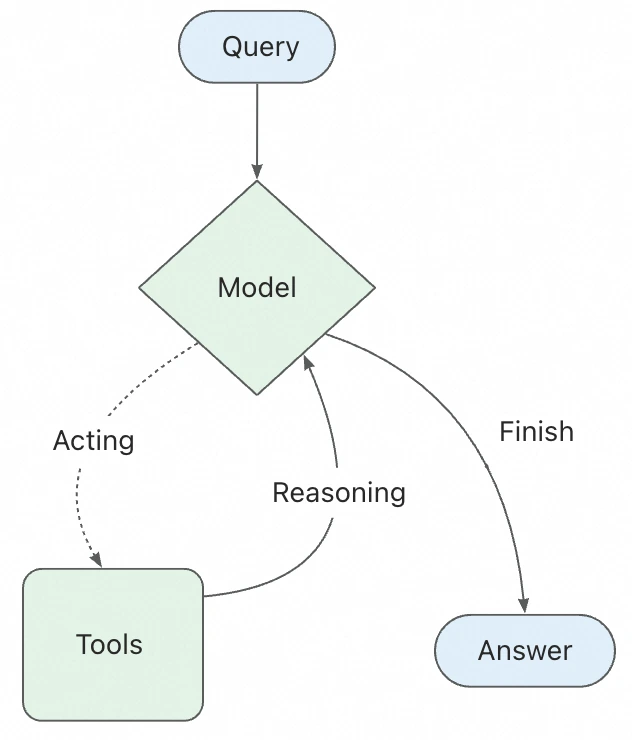
<dependency> <groupId>com.alibaba.cloud.ai</groupId> <artifactId>spring-ai-alibaba-agent-framework</artifactId> <version>1.1.0.0</version></dependency> <dependency> <groupId>com.alibaba.cloud.ai</groupId> <artifactId>spring-ai-alibaba-starter-dashscope</artifactId> <version>1.1.0.0</version></dependency>非流式
@GetMapping("/chat")public String chat(String conversationId) throws GraphRunnerException {
String systemPrompt = String.format("你是一个基于React架构(Reasoning-Act-Observation)的智能助手,你擅长使用工具帮我解决问题。" + "你的工作流程是:" + "1、思考:先根据用户的提问进行思考,推理出下一步需要进行的具体系统" + "2、行动:做具体的行动,这一步可以使用工具" + "3、观察:记录前一步行动的结果。你可以进行多轮思考和行动。如果要使用工具,请务必调用工具,不要自己随便捏造结果。");
//创建Agent客户端 ReactAgent agent = ReactAgent.builder() .name("executor") .model(chatModel)
//可以传多个工具 //StockTools类里有多个@Tool注解 .tools(ToolCallbacks.from(new StockTools())) .systemPrompt(systemPrompt) .saver(new MemorySaver()) .build();
//给这次执行绑定会话 ID记忆 RunnableConfig config = RunnableConfig.builder() .threadId(conversationId) .build();
AssistantMessage chatResponse = agent.call("帮我分析最近三个月特斯拉(TSLA)的股价走势,并结合新闻事件解释可能的影响因素。", config); return chatResponse.getText();}流式
- 返回结构是:Flux
,因为他是图结构,需要将每个节点的输出都合并成一个流 - 需要判断当前流是否是StreamingOutput 还是普通的节点输出才可以。
return agent.stream("帮我分析最近三个月特斯拉(TSLA)的股价走势,并结合新闻事件解释可能的影响因素。", config) .map(output -> { if (output instanceof StreamingOutput) { //StreamingOutput类型直接返回 Message message = ((StreamingOutput<?>) output).message(); return message != null ? message.getText() : ""; } else { String nodeId = output.node(); Map<String, Object> state = output.state().data(); return "节点 '" + nodeId + "' 执行完成\n"; } }) .filter(text -> !text.isEmpty());agent.stream(...)→ Graph Runtime 开始运行→ Model Node 开始流式输出思考/回答→ 如果模型决定调用工具→ Tool Node 执行工具→ 返回一个普通 NodeOutput→ 工具结果进入 state→ Model Node 继续生成内容→ 所有节点输出合并成 Flux<NodeOutput>→ Controller 转成 Flux<String> 返回前端接入McP
创建一个连接 MCP Server 的通信通道
HttpClientStreamableHttpTransport streamableTransport = HttpClientStreamableHttpTransport .builder("http://127.0.0.1:8004/stream/test/") .endpoint("api/mcp") .clientBuilder(HttpClient.newBuilder() .connectTimeout(Duration.ofSeconds(60)) // 连接超时60秒 .version(HttpClient.Version.HTTP_1_1)) // 使用 HTTP/1.1 更稳定 .build();同步McPClient
McpSyncClient streamableClient = McpClient.sync(streamableTransport) .clientInfo(new io.modelcontextprotocol.spec.McpSchema.Implementation("streamable-client", "1.0")) .requestTimeout(Duration.ofSeconds(60)) // 增加请求超时到60秒 .build();暴露工具能力
McpSyncClient客户端 //把远程 MCP 服务暴露的工具转换成 Spring AI 能识别的 ToolCallback[] List<McpSyncClient> clients = List.of(streamableClient) SyncMcpToolCallbackProvider provider = SyncMcpToolCallbackProvider.builder() .mcpClients(clients) .build();
ToolCallback[] callbacks = provider.getToolCallbacks();组件
Model仅需ChatModel
DashScopeApi dashScopeApi = DashScopeApi.builder() .apiKey("sk-XXXXXXXXXXXXXXXXXXXX") .build();// 创建 ChatModelChatModel chatModel = DashScopeChatModel.builder() .dashScopeApi(dashScopeApi) .defaultOptions(DashScopeChatOptions.builder() .withModel("qwen-plus") .withTemperature(0.7) // 控制随机性 .withMaxToken(2000) // 最大输出长度 .withTopP(0.9) // 核采样参数 .build()) .build();Tools可以利用带多个@Tool的类.tools(ToolCallbacks.from(new StockTools()))
ToolContext统一管理参数、状态、memory、config 并封装返回值
System Prompt
- systemPrompt(”…”):简单字符串提示词。
- instruction(”…多行指令…”):适合更复杂或结构化的提示
ReactAgent agent = ReactAgent.builder() .name("architect_agent") .model(chatModel) // .systemPrompt("你是一个智能助手。") .instruction(instruction) .build();
AssistantMessage resp = agent.call("我想搭一个微服务系统,用 Java + Spring,怎么设计?");System.out.println(resp.getText());结构化输出
- .outputType(BookListResult.class)在类的返回值设置为record
- SpringAI是entity(类名.class)
Memory
// 短期记忆ReactAgent agent = ReactAgent.builder() .name("chat_agent") .model(chatModel) .saver(new MemorySaver()) .build();//对话id RunnableConfig config = RunnableConfig.builder() .threadId("user_123") .build();
agent.call("你好!我叫 bigchui。", config);
AssistantMessage resp = agent.call("我叫什么名字?", config); System.out.println(resp.getText());长期记忆
@Autuwridprivate DataSource dataSource.saver(new MysqlSaver.Builder() .dataSource(dataSource).build()).build();Hooks
执行过程中的“生命周期钩子相当于advisor
- BEFORE_AGENT
/AFTER_AGENT:Agent 整体执行前后 - BEFORE_MODEL / AFTER_MODEL:Agent Loop 循环过程中,每次模型调用前后
- 继承于AgentHook
@Override public CompletableFuture<Map<String, Object>> beforeAgent(OverAllState state, RunnableConfig config) { System.out.println("Agent 开始执行"); return CompletableFuture.completedFuture(Map.of()); }
@Override public CompletableFuture<Map<String, Object>> afterAgent(OverAllState state, RunnableConfig config) { System.out.println("Agent 执行完成"); return CompletableFuture.completedFuture(Map.of()); }Interceptor拦截器
-
继承于ModelInterceptor
-
Hooks 控制 Agent 的执行节奏和流程,Interceptors 控制具体的调用行为;
-
Hooks 在生命周期节点插入,Interceptors 在调用边界拦截
原理
Alibaba 的 ReactAgent 把 ReAct 的“模型推理 -> 工具调用 -> 工具结果再推理”编译成了一张 Graph
参数
- overAllState 全局状态,存储运行的各个环节。
- 状态靠 OverAllState.messages持续累积。
画图
- 调用 compiledGraph.invoke(…)
- 最终会走 `GraphRunner.run(…)运行构建的流程图
节点
节点的运行逻辑
- mainGraphExecutor.execute---->>nodeExecutor.execute,就是节点执行器。
- 从GraphRunnerContext 中取出当前要执行的节点和对应的 Action
- 如果是可中断节点则优先处理外部反馈并判断是否需要直接中断流程;
- 真正的执行逻辑就是 action.apply,执行完成后,会将结果统一转换成GraphResponse。
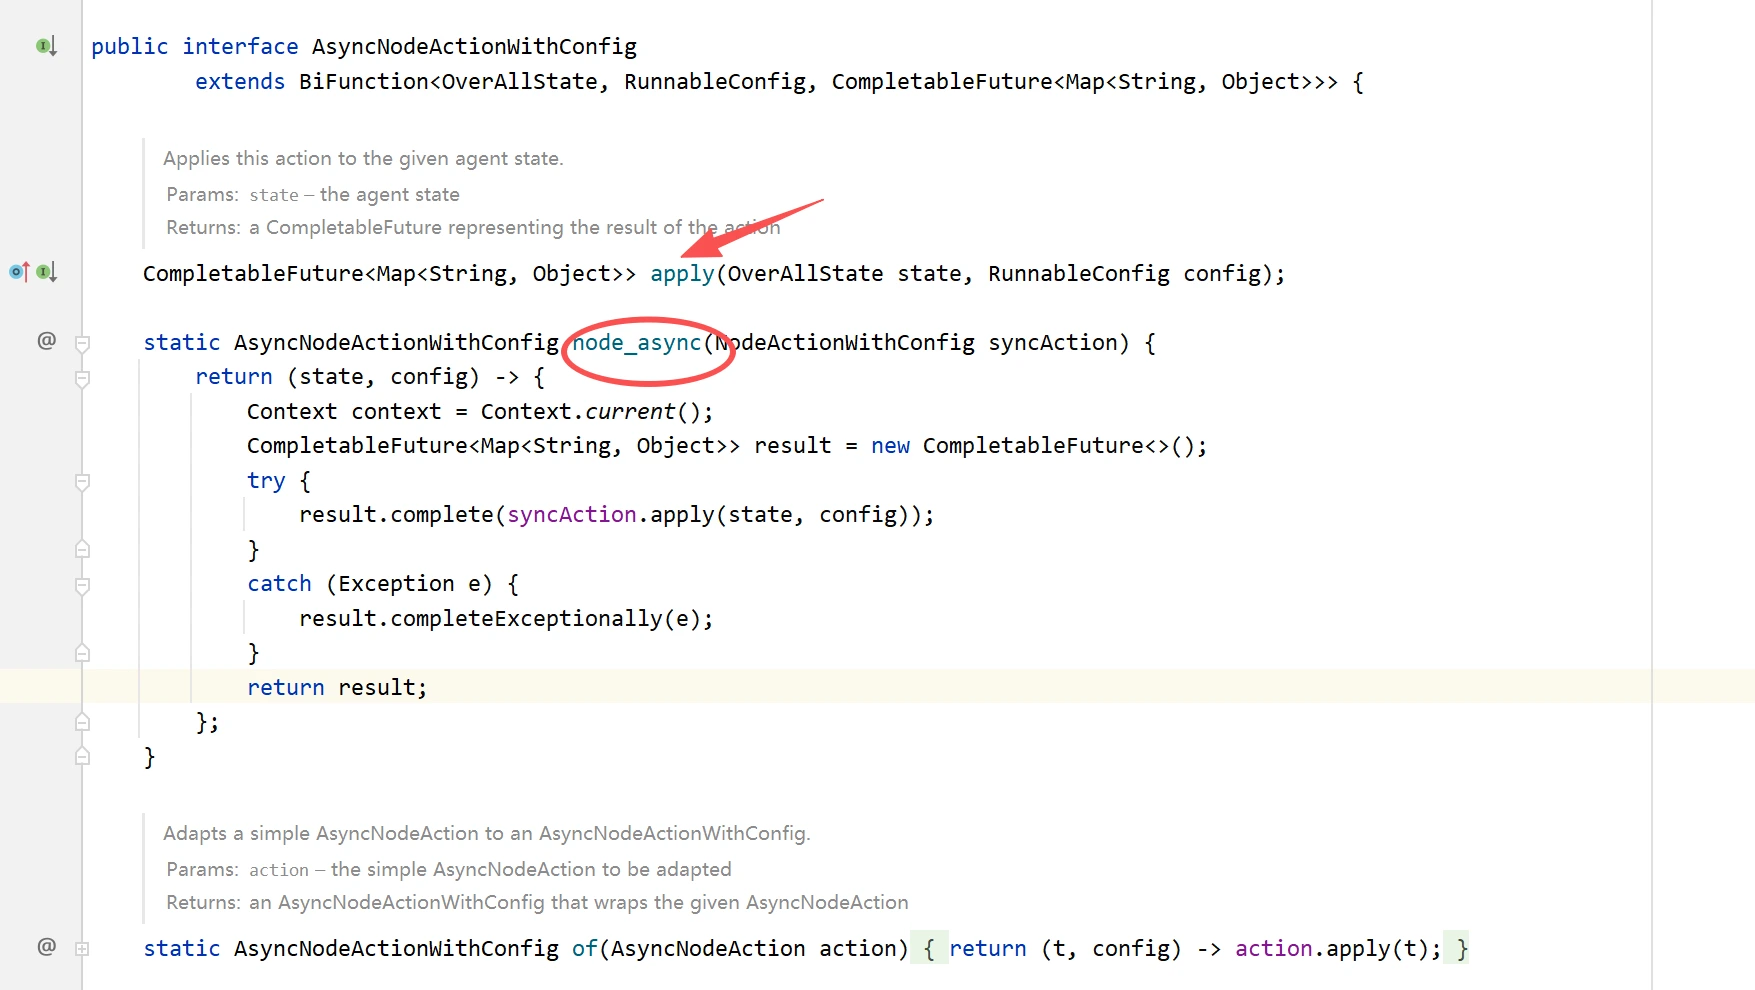
不好debug因为这是函数式接口
- 只是把同步的 NodeActionWithConfig包装成返回CompletableFuture的异步节点
- 真正逻辑取决于建图时注册进去的是谁。源码里 node_async(syncAction) 内部实际调用的是 syncAction.apply(state, config)
ReactAgent.initGraph() 里注册了两个主节点:
model和tool 是两个核心节点,循环靠条件边完成
执行节点
node_async 封装节点逻辑
llm节点
- AgentLlmNode.apply(…) 负责组装
ModelRequest - 读取当前 messages,挂载工具名、工具描述、systemPrompt,然后调用模型
Tool节点
- AgentToolNode.apply(…) 则读取最后一条 AssistantMessage,判断里面是否有 toolCalls。
- 如果有,就根据配置选择串行或并行执行工具;执行时会根据工具名解析出 ToolCallback
, - 调用
FunctionToolCallback、MethodToolCallback、AsyncToolCallback等具体工具 - 执行完成后把工具结果封装成 ToolResponseMessage,继续写回 messages
循环是怎么来的
- 循环不是 while 明写在 ReactAgent.call里,而是由 Graph 的条件边实现的。
- 在 setupToolRouting(…)里,ReactAgent`配置了两组条件边
Model -> Tool / Loop / ExitTool -> Model / ExitmakeModelToTools(…) 会看最后一条消息:
- 如果最后是 AssistantMessage且包含 toolCalls,跳到 tool 节点。
- 如果最后是普通回答,没有工具调用,跳到结束节点。
- 如果最后是 ToolResponseMessage,则判断工具是否都执行完;执行完就回到模型节点继续推理,否则继续执行工具节点
makeToolsToModelEdge(…) 的设计意图是:工具执行完成后默认回到模型节点,让模型基于工具结果再思考一轮;如果所有工具都配置了 return_direct=true,则可以直接结束
手搓ReAct
非流式
基于Spring AI实现思考和行动
SimpleReactAgent的核心组成
系统提示词
大模型在输出的时候,如果是需要调工具则需要输出 tool_call 字段,然后工具的执行结果,由我们程序自己会注入到上下文之中,当没有 tool_call 的时候说明不需要再调用工具了,输出即结论。
初始化
private void initChatClient() { try { ToolCallingChatOptions toolOptions = ToolCallingChatOptions.builder() .toolCallbacks(tools) .internalToolExecutionEnabled(false) .build();
this.chatClient = ChatClient.builder(chatModel) .defaultOptions(toolOptions) .defaultToolCallbacks(tools) .build(); } catch (Exception e) { throw new RuntimeException("ChatClient 初始化失败:" + e.getMessage(), e); }}internalToolExecutionEnabled(false)
ChatClient 内部是具备自动工具调用能力的:当模型输出 ToolCall 后,框架会自动完成工具匹配、执行以及结果注入
- 默认 true(框架代执行):模型输出 ToolCall → 框架自动匹配、执行、注入结果。适合单轮问答,
- false(Agent 代执行):模型只表达“我想调什么”,何时调、调几次、结果如何处理全部由你的代码显式控制
模型只负责表达“我想调用什么工具”,而不再负责调用工具本身
把工具执行权从 ChatClient交给 SimpleReactAgent
上下文
第一次包含ToolCall执行第二次
第二次SystemMessage ↓UserMessage ↓AssistantMessage1(ToolCall) ↓ToolResponseMessage1 第三次AssistantMessage2(ToolCall) ↓ToolResponseMessage2 ↓AssistantMessage3(最终文本)第三次调用开始 ↓当前 messages: SystemMessage UserMessage AssistantMessage1(ToolCall) ToolResponseMessage1 AssistantMessage2(ToolCall) ToolResponseMessage2 ↓调用模型 callModel(messages) ↓得到 AssistantMessage3 ↓messages.add(AssistantMessage3)- 每次模型返回 AssistantMessage后,先添加到 messages;
- 如果其中有 ToolCall,执行工具并添加 ToolResponseMessage,才进入下一次模型调用
- messages不仅仅是聊天记录,也是 Agent 的状态容器。
- 保存历史会话记忆、React 模式提示词、系统提示词、用户问题、工具决策tool_calls、工具执行结果
- messages会在整个 ReAct 循环中不断地被扩展
进入循环
- AssistantMessage 是消息外壳
- AssistantToolCall 是消息内部的工具调用内容
AssistantMessage的由来
- 模型第一次返回的不是最终答案,而是一个 Assistant Tool Call工具的调用请求**
- 并由SpringAi映射成AssistantMessage对象
AssistantMessage ├── text └── toolCalls └── ToolCall ├── id ├── name └── argumentsAssistantMessage assistantMessage = chatResponse .getResult() .getOutput();
String text = assistantMessage.getText();
List<AssistantMessage.ToolCall> toolCalls = assistantMessage.getToolCalls();模型返回决策
无toolcallAssistantMessage 中没有 tool_call ↓说明模型认为信息已经足够 ↓直接返回 AssistantMessage.content
有toolcallAssistantMessage 中存在 AssistantToolCall ↓检查是否达到最大轮次 ├── 已达到:停止循环,返回兜底结果 └── 未达到:执行工具 ↓ 得到工具结果 ↓ 封装为 ToolResponseMessage ↓ 拼接回上下文 ↓ 再次调用模型进入循环根据maxRounds的判断
- 小于等于0的则表示无限制循环
- 每一轮开始,轮次是否已经超过
maxRounds了,达到,强制输出答案
ensureToolCallsClosed需要注意,必须带有tool_call的AssistantMessage后面要有ToolResponseMessage,否则就会报错400,给最后一个tool_call拼上一个空的结果
调用工具
- 在模型返回 ToolCall 之后,Agent 并不会立刻执行工具,而是先将包含 ToolCall 的 AssistantMessage 追加到messages中
- 把模型本轮的“行动决策”补充为上下文的一部,完整感知自己已经做过哪些尝试。,
- ToolCall 在这里并不代表执行结果而仅仅是模型表达出来的行动意图,整个 ReAct 的状态才是连续且可回溯的
- Agent 遍历所有 ToolCall,显式查找并调用对应的工具实现,工具执行过程中出现的异常也由 Agent 统一兜底处理。
- 每一次工具调用的真实结果,都会被封装为 ToolResponseMessage并再次写入 messages,作为下一轮推理的 Observation 输入给模型。
流式
状态管理
- 非流式模式中,模型一次性返回完整结果:要么是最终答案,要么是完整的 ToolCall;
- 流式模式下,模型的输出被拆成了多个 chunk,文本和 ToolCall 都是分段到达的,如果没有额外的状态管理能力,Agent无法判断当前轮次的模式的
每一轮都有一个独立的执行状态
RoundState state = new RoundState();
//当前一轮模型流式输出的处理状态。private static class RoundState { private RoundMode mode = RoundMode.UNKNOWN;
/** * 缓存当前轮已经接收到的文本。 * * 作用: * 1. 最终答案模式下保存完整答案 * 2. 最后写入 ChatMemory * 3. 如果不采用实时输出,可以在本轮结束后统一发送 */ private final StringBuilder textBuffer = new StringBuilder();
//当前轮接收到的所有 ToolCall。 * 一个模型响应中可能包含多个工具调用, * 例如同时调用 weather 和 search。 */ private final List<AssistantMessage.ToolCall> toolCalls = new ArrayList<>();}
//当前轮的运行模式private enum RoundMode {
//尚未判断当前轮的模式 UNKNOWN, //当前轮暂时按照最终答案处理。 FINAL_ANSWER,//当前轮已经发现工具调用。 TOOL_CALL}public Flux<String> stream(String question) { return streamInternal(null, question);}
// 带会话记忆public Flux<String> stream(String conversationId, String question) { return streamInternal(conversationId, question);}
public Flux<String> streamInternal(String conversationId, String question) { List<Message> messages = Collections.synchronizedList(new ArrayList<>()); boolean useMemory = conversationId != null && chatMemory != null;
// ===== 加载历史记忆 ===== if (useMemory) { List<Message> history = chatMemory.get(conversationId); if (history != null && !history.isEmpty()) { messages.addAll(history); } }
// ===== 加载 System Prompt(仅新会话,防止重复)===== if (messages.isEmpty()) { messages.add(new SystemMessage(REACT_AGENT_SYSTEM_PROMPT)); messages.add(new SystemMessage(systemPrompt)); }
messages.add(new UserMessage("<question>" + question + "</question>"));
// 添加记忆 if (useMemory) { chatMemory.add(conversationId, new UserMessage(question)); }Sink
第一次流式调用
Sinks.Many<String> sink = Sinks.many() .unicast() .onBackpressureBuffer();Sink 用来把 Agent 处理好的文本推给外部订阅者
ScheduleRound
private void scheduleRound(List<Message> messages, Sinks.Many<String> sink, AtomicLong roundCounter, AtomicBoolean hasSentFinalResult, StringBuilder finalAnswerBuffer, boolean useMemory, String conversationId) { // 轮次+1 roundCounter.incrementAndGet(); //设置每轮对话的状态 RoundState state = new RoundState(); //依据chatClient进行流式输出并 chatClient.prompt() .messages(messages) .stream() .chatResponse() //设置缓冲区,开其他线程处理状态判断如processChunk //将后续的 processChunk、finishRound 等处理逻辑切换到 boundedElastic 调度器执行 .publishOn(Schedulers.boundedElastic())
//决定执行什么模式根据每个chunk .doOnNext(chunk -> processChunk(chunk, sink, state))
//结束状态,有工具进入第二轮,没有直接输出结果 .doOnComplete(() -> finishRound(messages, sink, state, roundCounter, hasSentFinalResult, finalAnswerBuffer, useMemory, conversationId))
.doOnError(err -> { if (!hasSentFinalResult.get()) { hasSentFinalResult.set(true); sink.tryEmitError(err); } }) .subscribe();publishOn(Schedulers.boundedElastic())
- 在模型流式输出和 Agent 处理逻辑之间加了一层缓冲区:模型可以持续、快速地把流式结果推送出来,
- 状态判断、参数拼接、工具调度等处理逻辑交由一个专门用于执行可能较慢任务的线程池来消费,避免阻塞输出
流程
- 轮次加一,每一轮都会创建一个新的 RoundState,并通过chatClient.stream()订阅模型的流式输出。
- 每当新的 chunk 到来时,统一交由 processChunk处理,而当这一轮流式输出结束时,再由
finishRound决定是否进入下一轮。
processChunk
在流式输出尚未完整到达时,判断模型这一轮到底想干什么
- 第一块chunk 检查是否已经出现 ToolCall,立即判定当前轮次进入工具模式,后续所有数据只需要围绕工具参数的补全与收集即可;
- 如果首块 chunk 中没有 ToolCall,则认为模型正在直接生成最终答案
- ToolCall 不一定在第一个 chunk 出现
- ToolCall 的参数必须累积完成,不一定一次性返回
收到 chunk ↓chunk 是否包含 ToolCall? ├── 是 │ ↓ │ 切换 TOOL_CALL 模式 │ 合并 ToolCall │ 不向用户输出 │ └── 否 ↓ 之前是否已经进入 TOOL_CALL 模式? ├── 是 │ ↓ │ 继续等待工具参数 │ 不输出 │ └── 否 ↓ 按普通文本处理 缓存文本 实时输出文本- 某些模型会先输出思考文本,后输出 ToolCall,不能只以第一个chunk作为评判标准,应遍历每一个chunk
- 只要当前轮的任意一个 chunk 出现 ToolCall,就必须把整轮认定为工具调用模式
private void processChunk( ChatResponse chunk, Sinks.Many<String> sink, RoundState state) { //第一步:校验 chunk 是否有效某些模型在流式结束时可能返回空 chunk, if (chunk == null || chunk.getResult() == null || chunk.getResult().getOutput() == null) { return; }
// 第二步:读取当前 chunk 中的 AssistantMessag 这里拿到的 AssistantMessage 只是当前 chunk 的增量内容, 并不一定是完整的 AssistantMessage。 AssistantMessage output = chunk.getResult().getOutput();
//读取chunk中的普通文字 String text = output.getText();
//chunk参数积累 List<AssistantMessage.ToolCall> incomingToolCalls = output.getToolCalls();
//遍历每一个chunk if (incomingToolCalls != null && !incomingToolCalls.isEmpty()) {
//工具调用模式 state.mode = RoundMode.TOOL_CALL;
//需要根据 ToolCall ID 找到已有调用然后拼接 arguments for (AssistantMessage.ToolCall incoming : incomingToolCalls) { mergeToolCall(state, incoming); } return; }//一旦当前轮已经发现过 ToolCall,这一轮就已经确定是“工具调用轮”,后续 chunk 不能再被当成最终答案文本处理。 if (state.mode == RoundMode.TOOL_CALL) { return; }
//乐观输出在这里直接发送文字 if (text != null && !text.isEmpty()) { 这个模式不是绝对确定的 state.mode = RoundMode.FINAL_ANSWER; //缓存文本 state.textBuffer.append(text);
//将当前文本片段实时发送给外部订 sink.tryEmitNext(text); }}此方案会立即输出文字
- chunk 1:我先分析一下……代码已经把这段文字发给用户
- chunk 2:ToolCall(getWeather)发现这是工具调用模式,但前面的内容已经无法撤回
先缓存文本,只有整轮结束且没有 ToolCall,才输出给用户
if (text != null && !text.isEmpty()) { state.mode = RoundMode.FINAL_ANSWER; state.textBuffer.append(text); // 不在这里 sink.tryEmitNext(text)}在 finishRound 中确认整轮没有出现 ToolCall 后,再发送
if (state.mode != RoundMode.TOOL_CALL) { sink.tryEmitNext(state.textBuffer.toString()); sink.tryEmitComplete();}ToolCall 为什么需要合并
-
每个chunk都去调用工具,参数都是不完整的 JSON
-
mergeToolCall 也要在每个 chunk 调用
private void mergeToolCall( RoundState state, AssistantMessage.ToolCall incoming) { if (incoming == null) { return; }
String incomingId = incoming.id();
for (int i = 0; i < state.toolCalls.size(); i++) { AssistantMessage.ToolCall existing = state.toolCalls.get(i);
boolean sameCall = incomingId != null && incomingId.equals(existing.id());
if (sameCall) { String oldArguments = Objects.toString( existing.arguments(), "" );
String newArguments = Objects.toString( incoming.arguments(), "" );
String mergedArguments = oldArguments + newArguments;
String toolName = incoming.name() == null || incoming.name().isBlank() ? existing.name() : incoming.name();
state.toolCalls.set( i, new AssistantMessage.ToolCall( existing.id(), "function", toolName, mergedArguments ) );
return; } }
// 没有找到相同 ID,说明是一个新的 ToolCall state.toolCalls.add(incoming);}- 如果是最终答案模式,就持续将文本向外流式输出
- 如果是工具模式,则不对外输出内容,而是不断累积文本和 ToolCall 片段,直到本轮结束再统一处理
finishRound
每个chunk结束执行时
doOnComplete(() -> finishRound(…))
-
FINAL_ANSWER:整轮没有出现 ToolCall,说明当前文本就是最终答案。
-
TOOL_CALL:当前轮出现过 ToolCall,需要先保存 AssistantMessage,再执行工具,最后进入下一轮模型调用。
-
工具模式Agent 则会把本轮流式过程中收集到的 ToolCall 和文本内容封装成一个完整的 AssistantMessag
-
写回到上下文中,补充模型的行动决策信息。执行这些工具调用,并在工具全部完成后
-
*基于最新的上下文递归调度下一轮推理,也就是递归调用scheduleRound,就是相当于 call 非流式中的 while(true)**`
private void finishRound( List<Message> messages, Sinks.Many<String> sink, RoundState state, AtomicLong roundCounter, AtomicBoolean hasSentFinalResult, StringBuilder finalAnswerBuffer, boolean useMemory, String conversationId) { 情况一:整轮没有出现 ToolCall 当前 processChunk 使用的是“乐观流式输出”策略, 普通文本已经在 processChunk 中通过:sink.tryEmitNext(text)发送给用户,因此这里不能再次发送 finalText,否则会导致最终答案重复。
if (state.mode != RoundMode.TOOL_CALL) { String finalText = state.textBuffer.toString();// 先设置结束标记,避免异步回调重复结束。 if (!hasSentFinalResult.compareAndSet(false, true)) { return; }//保存最终答案。 if (useMemory) { chatMemory.add( conversationId, new AssistantMessage(finalText) ); }//当前轮是最终答案,不再执行工具 也不再进入下一轮。 sink.tryEmitComplete(); return; }
//情况二:当前轮出现过 ToolCall AssistantMessage assistantMessage = AssistantMessage.builder() /* * 如果工具调用前产生了文本, * 这里可以选择不放入 content, * 避免把 think 内容作为助手正式回复保存。 */ .toolCalls(state.toolCalls) .build();
//将模型的工具调用消息加入上下文。 messages.add(assistantMessage);
//1. 先执行当前轮工具 2. 添加 ToolResponseMessage 3. 如果达到最大轮次,再强制生成最终答案
boolean lastRound = maxRounds > 0 && roundCounter.get() >= maxRounds;// 执行当前轮的全部工具调用。只有全部工具执行完成后,才能进入 onComplete executeToolCalls( state.toolCalls, messages, hasSentFinalResult, () -> { if (hasSentFinalResult.get()) { return; } if (lastRound) { // 现在基于工具结果强制生成最终答案。 forceFinalStream( messages, sink, hasSentFinalResult ); } else { // 工具结果已经准备好,进入下一轮流式模型调用 scheduleRound( messages, sink, roundCounter, hasSentFinalResult, finalAnswerBuffer, useMemory, conversationId ); } } );}SimpleReactAgent 创建 RoundState ↓processChunk 不断修改 RoundState ↓finishRound 读取 RoundState ↓构造 AssistantMessage(ToolCall) ↓加入 messages ↓执行 ToolCallback ↓加入 ToolResponseMessage ↓SimpleReactAgent 创建下一轮 RoundStateexecuteToolCalls
- 将当前轮次中给出的所有 ToolCall 落地执行
- 没有按顺序串行调用工具,每个工具调用都会被提交到
boundedElastic线程池中并发执行 - 每一次工具执行的结果都会被统一封装为
ToolResponseMessage并写回messages, - 作为下一轮推理所需的 Observation 输入。
- 为了在并发执行的情况下仍然保持 ReAct 轮次边界的清晰性,这里通过一个计数器来判断本轮工具是否已经全部执行完成。
- 只有当所有 ToolCall 都结束后,才会触发
onComplete回调,进而调度下一轮推理。这样一来,模型始终是基于完整的工具执行结果进入下一轮决策。
private void executeToolCalls(List<AssistantMessage.ToolCall> toolCalls, List<Message> messages, AtomicBoolean hasSentFinalResult, Runnable onComplete) { AtomicInteger completedCount = new AtomicInteger(0); int totalToolCalls = toolCalls.size(); //toolcall交给线程 for (AssistantMessage.ToolCall tc : toolCalls) { Schedulers.boundedElastic().schedule(() -> { if (hasSentFinalResult.get()) { completeToolCall(completedCount, totalToolCalls, onComplete); return; }
String toolName = tc.name(); String argsJson = tc.arguments();
ToolCallback callback = findTool(toolName); if (callback == null) { addErrorToolResponse(messages, tc, "工具未找到:" + toolName); completeToolCall(completedCount, totalToolCalls, onComplete); return; } //将工具调用结果转成ToolResponseMessage并封装到messages try { Object result = callback.call(argsJson); String resultStr = Objects.toString(result, ""); ToolResponseMessage.ToolResponse tr = new ToolResponseMessage.ToolResponse( tc.id(), toolName, resultStr); messages.add(ToolResponseMessage.builder() .responses(List.of(tr)) .build()); } catch (Exception ex) { addErrorToolResponse(messages, tc, "工具执行失败:" + ex.getMessage()); } finally { completeToolCall(completedCount, totalToolCalls, onComplete); } }); }}//判断本轮工具是否全部执行完private void completeToolCall(AtomicInteger completedCount, int total, Runnable onComplete) { int current = completedCount.incrementAndGet(); if (current >= total) { onComplete.run(); }}
private ToolCallback findTool(String name) { return tools.stream() .filter(t -> t.getToolDefinition().name().equals(name)) .findFirst() .orElse(null);}messages
AssistantMessage 不再一次性得到,先由多个 chunk 暂存到 RoundState,等本轮结束后再组装并添加到 messages。
chunk 1chunk 2chunk 3chunk 4 ↓都暂存在 RoundStateRoundState.textBufferRoundState.toolCallsRoundState├── mode: TOOL_CALL└── toolCalls ├── weather(...) └── search(...)最终答案模式
sink.tryEmitComplete();把文本推给用户,结束 Flux保存,最终答案到 Memory
工具调用模式
- 本轮结束时才构造完整的
AssistantMessage - 流式 chunk 中的多个 ToolCall 片段,最终会被合并成一个完整的 AssistantMessage
AssistantMessage assistantMsg = AssistantMessage.builder() .content(state.textBuffer.toString()) .toolCalls(state.toolCalls) .build();
messages.add(assistantMsg);stream(question) ↓加载历史消息 ↓messages.add(SystemMessage) ↓messages.add(UserMessage) ↓scheduleRound ↓创建 RoundState ↓chatClient.stream() ↓接收多个 chunk ↓processChunk 判断本轮模式 ├── FINAL_ANSWER │ ↓ │ 文本实时发送给 Sink │ ↓ │ 流结束 │ ↓ │ 保存最终答案 │ ↓ │ 完成 │ └── TOOL_CALL ↓ 累积 ToolCall ↓ 本轮流结束 ↓ messages.add(AssistantMessage) ↓ 执行所有工具 ↓ messages.add(ToolResponseMessage) ↓ 所有工具完成 ↓ scheduleRound 下一轮 ↓ 再次调用模型Reflection
初识
让大语言模型(LLM)在完成任务后,对其自身的行为或输出进行批判性反思,并基于反思结果进行改进。
ReflectionAgent 本质上是对 SimpleReactAgent 的封装
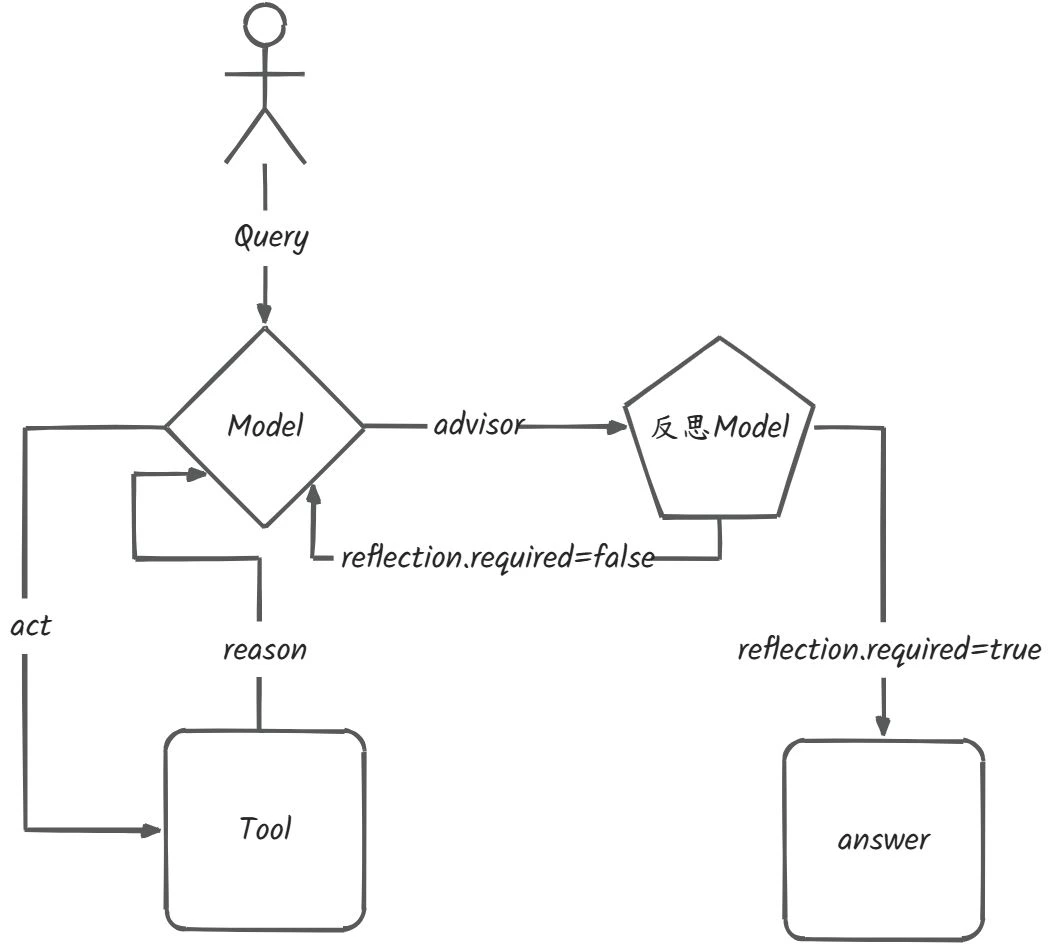
封装属性
public class ReflectionAgent { //这叫委托或组合模式 private final SimpleReactAgent delegate; private ReflectionAgent(SimpleReactAgent delegate) { this.delegate = delegate; }
public String call(String question) { return delegate.call(question); }
public String call(String conversationId, String question) { return delegate.call(conversationId, question); }
public static Builder builder() { return new Builder(); }
public static class Builder {
private String name = "reflection-react-agent"; private ChatModel chatModel; private List<ToolCallback> tools = new ArrayList<>(); private int maxRounds; private String systemPrompt = ""; private List<Advisor> advisors = new ArrayList<>(); private int maxReflectionRounds = 1;
public Builder name(String name) { this.name = name; return this; }
public Builder chatModel(ChatModel chatModel) { this.chatModel = chatModel; return this; }
public Builder tools(ToolCallback... tools) { this.tools = Arrays.asList(tools); return this; }
public Builder tools(List<ToolCallback> tools) { this.tools = tools; return this; }
public Builder advisors(Advisor... advisors) { this.advisors.addAll(Arrays.asList(advisors)); return this; }
public Builder systemPrompt(String systemPrompt) { this.systemPrompt = systemPrompt; return this; }
public Builder maxReflectionRounds(int maxReflectionRounds) { this.maxReflectionRounds = maxReflectionRounds; return this; }
public Builder maxRounds(int maxRounds) { this.maxRounds = maxRounds; return this; }封装Advisor
public ReflectionAgent build() {
if (chatModel == null) { throw new IllegalArgumentException("chatModel 不能为空"); }
//引入advisorsReflectionAdvisor reflectionAdvisor = new ReflectionAdvisor(chatModel); //合并用户传入的advisors List<Advisor> finalAdvisors = new ArrayList<>(advisors);
finalAdvisors.add(reflectionAdvisor);
ChatMemory chatMemory = MessageWindowChatMemory.builder().maxMessages(20).build();
//创建带反思能力的 SimpleReactAgent SimpleReactAgent reactAgent = SimpleReactAgent.builder() .name(name) .chatModel(chatModel) .tools(tools) .maxRounds(maxRounds) .systemPrompt(systemPrompt) .chatMemory(chatMemory) .maxReflectionRounds(maxReflectionRounds) .advisors(finalAdvisors) .build(); //外层被封装成ReflectionAgent return new ReflectionAgent(reactAgent); } }返回Agent
//ReflctionAgent封装上方的带有advisor的SimpleAgentpublic static void main(String[] args) { ChatModel chatModel = ChatModelConfig.getChatModel();
//封装两个工具 ToolCallback[] toolCallbacks = ToolCallbacks.from(new WeatherService(), new SearchService());
ReflectionAgent agent = ReflectionAgent.builder() .name("ReflectionAgent") .chatModel(chatModel) .maxReflectionRounds(2) .maxRounds(-1) .tools(toolCallbacks) .systemPrompt("你是专业的研究分析助手!") .build();
String question = """ 请你根据北京今天的天气、未来七天的天气趋势、以及上海今天的天气,并搜索北京天气的预警情况,生成一份不少于 200 字的综合分析报告。 """;
System.out.println(agent.call(question)); }}- SimpleReactAgent负责工具调用、ReAct 循环、记忆和轮次
- ReflectionAgent:负责组装一个带 ReflectionAdvisor 的 SimpleReactAgent
Advisor
ReflectionAdvisor的核心组件
//callController非流式调用public class ReflectionAdvisor implements CallAdvisor { //定义反思模型 private final ChatModel reflectionModel; //进行结构化输出 private final BeanOutputConverter<ReflectionJudgement> outputConverter = new BeanOutputConverter<>( ReflectionJudgement.class );
@Override public ChatClientResponse adviseCall( ChatClientRequest request,CallAdvisorChain chain) {
//第一步:先让后续责任链执行,最终调用主模型。 ChatClientResponse response = chain.nextCall(request);
//第二步:如果模型返回的是 ToolCall,不进行最终答案反思。 因为此时模型还没有给出最终答案,当前只是请求程序执行工模型返回 ToolCall ↓Agent 执行工具 ↓生成 ToolResponseMessage ↓再次调用主模型 ↓模型生成最终文本 ↓ReflectionAdvisor 评估最终文本
if (response.chatResponse() != null && response.chatResponse().hasToolCalls()) { return response; }
//第三步:检查响应是否有效。 if (response.chatResponse() == null || response.chatResponse().getResult() == null || response.chatResponse() .getResult() .getOutput() == null) { return response; }
//第四步:提取模型当前回答。 String answer = response .chatResponse() .getResult() .getOutput() .getText();
//第五步:从原始请求中提取用户问题。 String question =extractQuestion(request.prompt());
//第六步:调用反思模型评估回答。//结构化输出 ReflectionJudgement judgement = reflect(question, answer);
//第七步:反思通过,直接返回原响应。 if (judgement.passed()) { return response; }
第八步:反思不通过,将状态和反馈写入响应上下文,这里不会马上再次调用主模型。只是给 SimpleReactAgent 标记:下一轮规划
return response.mutate() .context("reflection.required", true) .context( "reflection.feedback", judgement.feedback() ) .build(); }
@Override public String getName() { return "ReflectionAdvisor"; }
@Override public int getOrder() { return 50; }}进入 Advisor ↓chain.nextCall(request) ↓主模型生成最终答案 ↓ReflectionAdvisor 评估 ↓是否通过? ├── 是:直接返回答案 │ └── 否:写入 reflection.required 写入 reflection.feedback ↓ SimpleReactAgent 读取 ↓ 反馈加入 messages ↓ 重新调用主模型PlanAct
核心流程
阶段1:Plan(规划)→ 阶段2:Execute(执行)
- Planner:LLM 全局思考,输出完整步骤清单(Task List)
- Executor:按顺序逐条执行,中间一般不做大改
- (可选)Replan:失败时局部调整计划
特点
-
✅ 稳定、高效、可控:全局最优,步骤清晰,不易跑偏
-
✅ 适合结构化/长任务:报告生成、数据分析、固定流程SOP
-
❌ 灵活性差:前期规划错了,后面容易一路错到底
区别
-
不确定、要实时反馈、探索型 → ReAct
-
确定流程、长任务、要稳定高效 → PlanAct
-
工程常用混合:外层 Plan,内层 ReAct(大任务拆解,子任务动态处理)
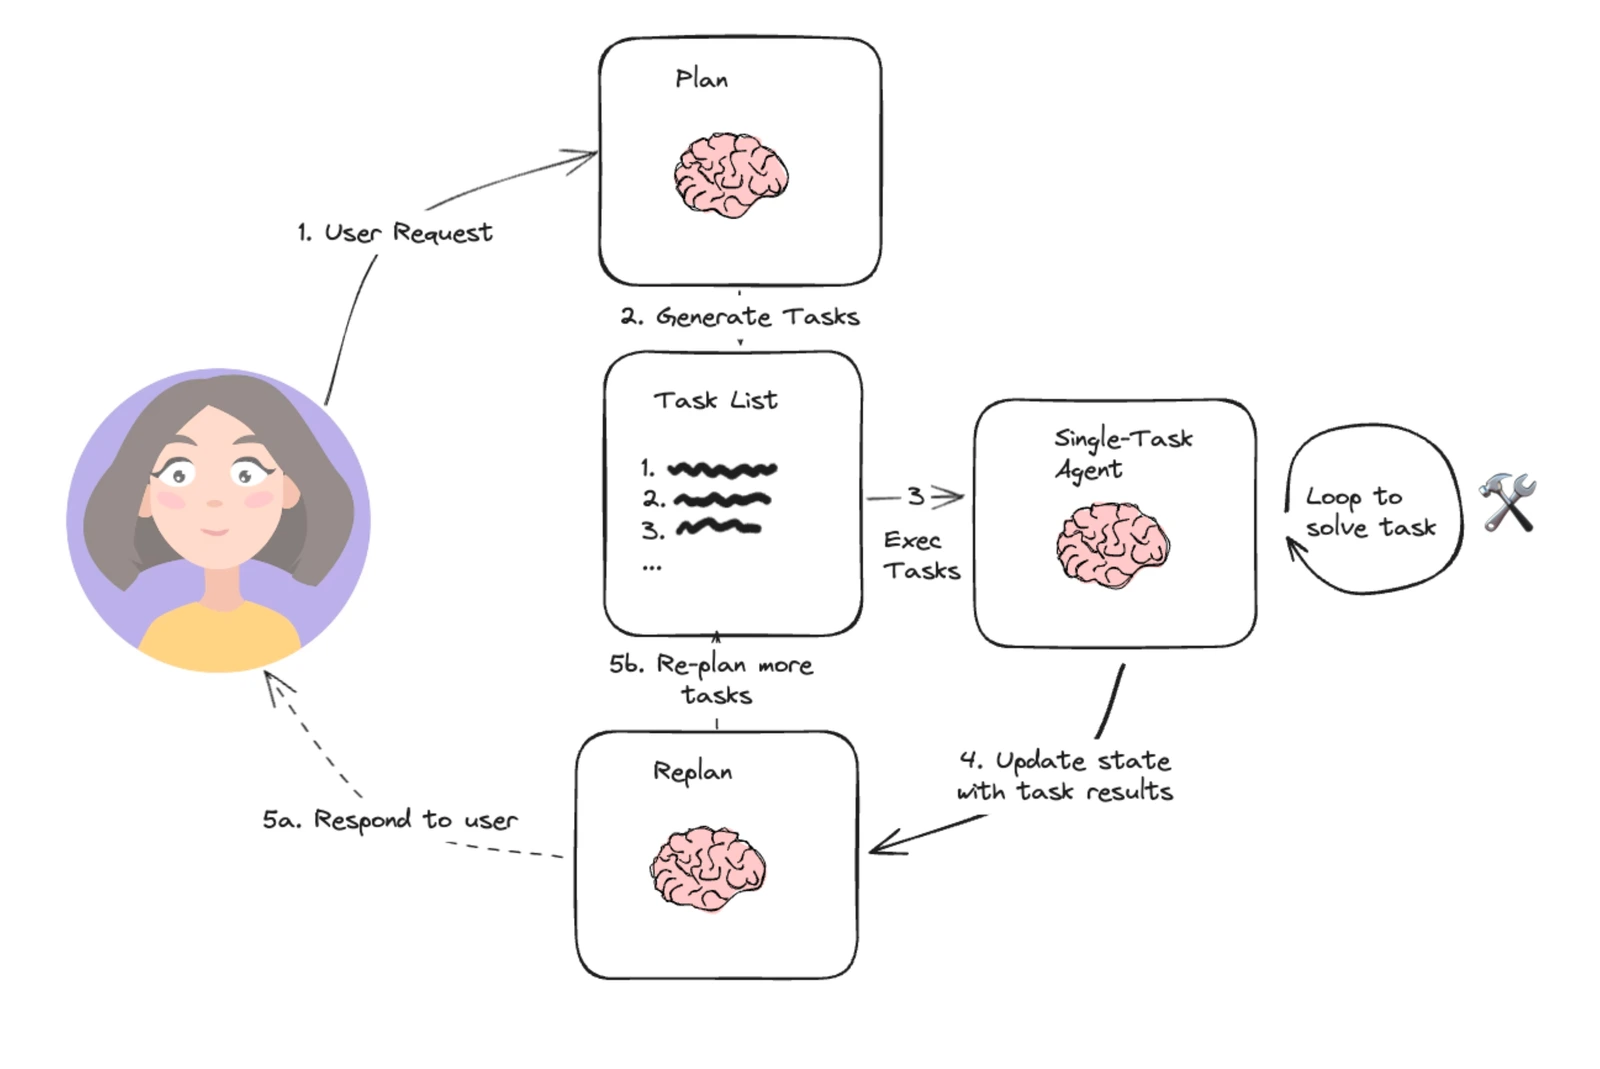
在复杂、多步骤任务中,保证每一步的决策、执行和结果都可控、可追踪、可修正
规划、执行、批判、压缩、迭代与总结6个过程
Plan:生成工具执行计划 ↓Execute:执行计划中的工具任务 ↓Critique:检查当前结果是否满足用户目标 ↓继续下一轮,或总结答案状态实体
OverAllState
用于描述 Agent 的全局执行状态;
public static class OverAllState {
// 会话 ID private final String conversationId;
// 用户最初的问题 private final String question;
// 当前完整上下文 private final List<Message> messages = new ArrayList<>();
// 每一轮 Plan、Execute、Critique 的结果 private final List<PlanRoundState> rounds = new ArrayList<>();
// 当前执行轮次 private int round = 0;}PlanRoundState
PlanRoundState 用于记录某一轮 Plan & Execute 的完整结果
public record PlanRoundState( int round, List<PlanTask> plan, Map<String, TaskResult> results, CritiqueResult critique) {}。第几轮,本轮计划+本轮任务结果+本轮批判结果PlanTask
PlanTask 表示当前轮次下生成的执行计划,会随着迭代动态调整
public record PlanTask(//任务id String id,//任务指令 String instruction,//排序(越小越先执行,相同则表示可以并发) int order) {}CritiqueResult
用于刻画每一轮执行完成后的评估结论。
public record CritiqueResult(//是否批判通过 boolean passed, //不通过的理由和建议 String feedback) {}{ "passed": false, "feedback": "缺少未来七天天气趋势,请继续查询。"}规划
- 规划阶段不执行任务,不得出结论,仅是对全局状态进行判断,是否需要工具来推进计划,根据planRoute上次的执行结构来判断
- 生成的是结构化的执行计划,每个任务对应一个具体的工具
- 是否存在依赖关系每个任务并行或串行
private List<PlanTask> generatePlan(OverAllState state) { // 渲染工具描述信息 String toolDesc = renderToolDescriptions();
BeanOutputConverter<List<PlanTask>> converter = new BeanOutputConverter<>(new ParameterizedTypeReference<>() { });
Prompt prompt = new Prompt(List.of( new SystemMessage(""" 你是【执行计划生成器】。
当前是迭代的第 %s 轮次。
你的职责: - 判断是否需要【调用工具】来推进问题解决; - 如果不需要任何工具调用,返回“无需执行计划”; - 如果需要,生成【仅包含工具调用的执行计划】。
## 重要规则(必须严格遵守)
1. 你只能规划【工具调用型任务】; - 每一个 task 都必须明确对应一个具体工具; - instruction 中必须显式包含工具名称。
2. 严禁规划以下内容: - 总结、分析、对比、写报告、生成结论; - 整合信息、输出答案、给出建议; - 任何不直接调用工具的纯文本任务。
3. 如果问题已经具备作答条件,或后续由其他智能体负责总结: - 返回一个对象,且 id = null; - 表示“无需生成工具执行计划”。
4. 支持并行与串行: - order 相同表示可并行执行; - 如果没有明确依赖关系,尽量并行(order 相同); - 如果是有先后关系,order数字小的先执行,并在后续指令中也尽可能的指明依赖前序的工具结果信息。
5. 输出必须是严格的 JSON 数组: - 不要任何额外文字、解释或注释; - 不要输出 tool_call 或函数调用。
6. instruction 只能是自然语言的【工具调用指令】, 用于指导后续执行模块解析并调用工具。
## 可用工具说明(仅用于规划参考) %s
## 输出格式(严格 JSON)
示例1:无需工具执行计划 [ { "id": null, "instruction": "无需调用任何工具", "order": 0 } ]
示例2:需要工具执行计划(并行) [ { "id": "task-1", "instruction": "调用 <工具名> 工具,执行 <明确查询或操作>", "order": 1 }, { "id": "task-2", "instruction": "调用 <工具名> 工具,执行 <明确查询或操作>", "order": 1 } ]
示例3:具有先后关系的执行计划(串行) [ { "id": "task-1", "instruction": "调用 <工具名> 工具,执行 <明确查询或操作>,获取XX结果", "order": 1 }, { "id": "task-2", "instruction": "根据task-1的执行结果,调用 <工具名> 工具,执行 <明确查询或操作>", "order": 2 } ]
示例4:具有先后关系的执行计划(并行+串行) [ {"id":"task-1","instruction":"调用 XXX 工具,执行<明确查询或操作>","order":1}, {"id":"task-2","instruction":"调用 XXX 工具,执行<明确查询或操作>","order":1}, {"id":"task-3","instruction":"根据 task1 和 task-2 的结果,调用 XXX 工具,执行<明确查询或操作>","order":2} ]
## 输出format %s
""".formatted(state.round, toolDesc,converter.getFormat())), new UserMessage(renderMessages(state.getMessages())) ));//模型依据系统提示词回答 String json = chatModel.call(prompt).getResult().getOutput().getText();//将结果利用converter封装成Plantask List<PlanTask> planTasks = converter.convert(json); return planTasks;}- renderToolDescriptions遍历toolcallback获取工具名称和描述
- 结构化输出List
利用BeanOutputConverter封装 - id值为null则表明是个简单任务直接输出
输出格式
[ PlanTask( "task-1", "调用 getWeather 工具,查询北京今天的天气", 1 ), PlanTask( "task-2", "调用 search 工具,搜索北京周末天气预警", 1 )]将PlanTask写进AssistantMessage
messages├── UserMessage(用户问题)└── AssistantMessage(Execution Plan)执行
executePlan(plan, state);public String callInternal(String conversationId, String question) { //判断是否需要记忆 boolean useMemory = conversationId != null && chatMemory != null;//创建全局状态 OverAllState state = new OverAllState(conversationId, question);
// 加载历史记忆到上下文messages中 if (useMemory) { List<Message> history = chatMemory.get(conversationId); if (!CollectionUtils.isEmpty(history)) { history.forEach(state::add); } }
// 当前用户问题 state.add(new UserMessage(question));
// 当前问题存入memory if (useMemory) { chatMemory.add(conversationId, new UserMessage(question)); }
while (maxRounds <= 0 || state.getRound() < maxRounds) { state.nextRound(); log.info("===== Plan-Execute Round {} =====", state.getRound());
// 1.生成计划 List<PlanTask> plan = generatePlan(state); log.info("【Execution Plan】\n\n" + plan); state.add(new AssistantMessage("【Execution Plan】\n" + plan));
if (plan.isEmpty() || plan.stream().allMatch(t -> t.id() == null)) { log.info("===== No execution needed, direct answer ====="); break; }
// 2.执行 Map<String, TaskResult> results = executePlan(plan, state);
// 3.批判 CritiqueResult critique = critique(state);
// state.addRound(new PlanRoundState(// state.getRound(), plan, results, critique// ));
if (critique.passed()) { log.info("===== Goal satisfied, finish ====="); break; } log.info("===== critique Goal not satisfied, continue round =====,\n reason is {} ", critique.feedback); state.add(new AssistantMessage(""" 【Critique Feedback】 %s """.formatted(critique.feedback()))); // 4. 压缩context compressIfNeeded(state); } if (state.round == maxRounds) log.info("===== Max rounds reached, force finish =====");
// 5.总结输出 return summarize(state); }- executePlan(List
, OverAllState) - 利用oder进行分组,无论任务成功还是失败,执行结果都会被统一记录下来
Map<Integer, List<PlanTask>> grouped = plan.stream().collect(Collectors.groupingBy(PlanTask::order));记录每个oder对应工具的执行状态,使得可以回顾
Map<String, String> accumulatedResults = new ConcurrentHashMap<>();保存当前的工具快照
for (Integer order : new TreeSet<>(grouped.keySet())) {
// 保存当前工具执行快照 String dependencySnapshot = renderDependencySnapshot(accumulatedResults);
List<PlanTask> tasks = grouped.get(order);- 开启异步线程,并获取许可
- toolSemphore用于限制并发工具调用的数量。
- 具体的工具执行则交由executeWithRetry实现的SimpleReactAgent 完成
- 并设置maxToolRetries最大重试次数
- 将每个工具状态添加到AssistantMessage
List<CompletableFuture<Void>> futures = tasks.stream() .map(task -> CompletableFuture.runAsync(() -> {try { // 获取执行许可 toolSemaphore.acquire(); if(task == null || StringUtils.isBlank(task.id())){ return; } TaskResult result = executeWithRetry(task, dependencySnapshot); results.put(task.id(), result);
if (result.success() && result.output() != null) { accumulatedResults.put(task.id(), result.output()); }
state.add(new AssistantMessage(""" 【Completed Task Result】 taskId: %s success: %s result: %s error: %s 【End Task Result】 """.formatted( task.id(), result.success(), result.output(), result.error() )));
} catch (InterruptedException e) { Thread.currentThread().interrupt();
results.put(task.id(), new TaskResult( task.id(), false, null, "Task execution interrupted" )); } finally { // 释放许可 toolSemaphore.release(); } })) .toList();PlanExecuteAgent ↓executePlan ↓executeWithRetry ↓SimpleReactAgent.call() ↓模型返回 AssistantMessage(ToolCall) ↓SimpleReactAgent 执行 ToolCallback ↓添加 ToolResponseMessage ↓再次调用模型 ↓返回当前任务结果压缩上下文触发阈值为1000字符
private String summarize(OverAllState state) { Prompt prompt = new Prompt(List.of( new SystemMessage(PlanExecutePromptsFactory.buildPrompts(planExecutePrompts).getSummarizePrompt()), new UserMessage(""" 【用户原始问题】 %s
【执行上下文(含工具结果)】 %s """.formatted( state.getQuestion(), renderMessages(state.getMessages()) )) ));
String answer = chatModel.call(prompt).getResult().getOutput().getText(); // 追加记忆 if (state.conversationId != null && chatMemory != null) { chatMemory.add(state.conversationId, new AssistantMessage(answer)); } return answer; }流程
用户问题 ↓创建全局状态 OverAllState ↓ //进入轮次循环第 1 轮 ├── Plan:生成工具任务 ├── Execute:执行工具任务 ├── Critique:判断目标是否完成 └── Compress:必要时压缩上下文 ↓第 2 轮 ├── 基于上一轮结果和批判反馈重新规划 ├── 执行缺失任务 ├── 再次批判 └── 必要时继续压缩 ↓目标完成 / 无需工具 / 达到最大轮次 ↓Summarize ↓最终答案public static void main(String[] args) { ChatModel chatModel = ChatModelConfig.getChatModel();
ToolCallback[] toolCallbacks = ToolCallbacks.from(new WeatherService(), new SearchService());
ChatMemory chatMemory = MessageWindowChatMemory.builder().maxMessages(20).build();
PlanExecuteAgent agent = PlanExecuteAgent.builder() .chatModel(chatModel) .tools(toolCallbacks) .maxRounds(3) .maxToolRetries(2) .chatMemory(chatMemory) .contextCharLimit(1000).build();
String result = agent.call(""" 请你先查询北京今天的天气,再搜索本周末北京天气的预警情况,并基于本周末北京的天气预警情况,搜索北京本周末适合旅游打卡的景点有哪些,最终生成一份不少于 500 字的综合天气分析报告。 """);人工确认
配置中断
在用户允许的边界内,让 Agent 自动运行;一旦即将执行高风险或高不确定性的动作,必须经过人工确认。
Spring AI Alibaba对 Agent HITL 的支持,通过HumanInTheLoopHook实现,这是Hook机制
Hook本质上就是一种拦截器,它拦截的并不是用户输入,而是模型推理完成之后产生的 Tool Call,并在工具真正执行之前,判断这些调用是否需要经过人类审批
- 在创建 Agent 时,利用approvalOn方法配置哪些工具需要人工审批;
- 并配置MemorySaver记忆中断
// 配置检查点保存器(人工介入需要检查点来处理中断)MemorySaver memorySaver = new MemorySaver();
// 创建人工介入HookHumanInTheLoopHook humanInTheLoopHook = HumanInTheLoopHook.builder() .approvalOn("write_file", ToolConfig.builder() .description("文件写入操作需要审批") .build()) .approvalOn("execute_sql", ToolConfig.builder() .description("SQL执行操作需要审批") .build()) .build();
// 创建AgentReactAgent agent = ReactAgent.builder() .name("approval_agent") .model(chatModel) .tools(writeFileTool, executeSqlTool, readDataTool) .hooks(List.of(humanInTheLoopHook)) .saver(memorySaver) .build();响应中断
调用 Agent 运行逻辑,若触发人工中断,返回中断元数据;
工具列表
- 要执行工具时interrupt 在真正执行前拦住它,返回 InterruptionMetadata,把工具名、参数、说明都暴露出来。
- interrupt 的实际调用是在NodeExecutor类中执行的。
上下文
有没有人工反馈
- 检查 RunnableConfig 中是否已携带人工反馈(HUMAN_FEEDBACK_METADATA_KEY),
- 如果存在,说明当前不是第一次执行,而是在“人工审批之后的恢复阶段”
有反馈验收
- 校验反馈是否合法,若反馈不完整或不符合审批规则,则继续返回该 InterruptionMetadata,强制 Graph 再次中断;
- 若反馈合法,则返回 Optional.empty(),明确放行当前节点,允许执行继续向下推进
没有反馈
- 若不存在人工反馈,则进入首次执行路径:从当前状态中取出最后一条消息,确认其为包含 Tool Call 的 AssistantMessage,并逐一检查这些 Tool Call 是否命中
approvalOn中声明的受控工具。 - 一旦发现任意一个受控工具调用,就构造对应的
InterruptionMetadata,将工具名称、参数和用于人工审批的描述信息封装为ToolFeedback,并返回该中断结果。 - Graph 执行引擎在收到这个返回值后会立即暂停执行,将控制权交还给调用方,从而完成 HITL 中断。
apply = 真正执行这个节点
MemorySaver + RunnableConfig(threadId )负责“记住上一次跑到哪了
/ 人工介入利用检查点机制。// 你必须提供线程ID以将执行与会话线程关联,// 以便可以暂停和恢复对话(人工审查所需)。String threadId = "user-session-123";RunnableConfig config = RunnableConfig.builder() .threadId(threadId) .build();
// 运行图直到触发中断Optional<NodeOutput> result = agent.invokeAndGetOutput( "删除数据库中的旧记录", config);
// 检查是否返回了中断if (result.isPresent() && result.get() instanceof InterruptionMetadata) { InterruptionMetadata interruptionMetadata = (InterruptionMetadata) result.get();
// 中断包含需要审查的工具反馈 List<InterruptionMetadata.ToolFeedback> toolFeedbacks = interruptionMetadata.toolFeedbacks();
for (InterruptionMetadata.ToolFeedback feedback : toolFeedbacks) { System.out.println("工具: " + feedback.getName()); System.out.println("参数: " + feedback.getArguments()); System.out.println("描述: " + feedback.getDescription()); }
// 示例输出: // 工具: execute_sql // 参数: {"query": "DELETE FROM records WHERE created_at < NOW() - INTERVAL '30 days';"} // 描述: SQL执行操作需要审批}恢复执行
- 将人工决策反馈传回给 Agent,并继续执行 React 逻辑。
- 人工反馈通过 RunnableConfig回传,Agent 读取后继续跑
List<InterruptionMetadata.ToolFeedback> toolFeedbacks = interruptionMetadata.toolFeedbacks();
InterruptionMetadata.Builder feedbackBuilder = InterruptionMetadata.builder() .nodeId(interruptionMetadata.node()) .state(interruptionMetadata.state());
toolFeedbacks.forEach(toolFeedback -> { InterruptionMetadata.ToolFeedback approvedFeedback = InterruptionMetadata.ToolFeedback.builder(toolFeedback) .result(InterruptionMetadata.ToolFeedback.FeedbackResult.APPROVED) .build(); feedbackBuilder.addToolFeedback(approvedFeedback); });
InterruptionMetadata approvalMetadata = feedbackBuilder.build();
RunnableConfig resumeConfig = RunnableConfig.builder() .threadId(threadId) .addMetadata(RunnableConfig.HUMAN_FEEDBACK_METADATA_KEY, approvalMetadata) .build();
Optional<NodeOutput> finalResult = agent.invokeAndGetOutput("", resumeConfig);
if (finalResult.isPresent()) { System.out.println("执行完成"); System.out.println("最终结果: " + finalResult.get());}SpringAI
会话状态
List<Message> messages = new ArrayList<>();
messages.add(new SystemMessage(REACT_AGENT_SYSTEM_PROMPT));messages.add(new UserMessage(question));//创建会话级别状态Map<String, Object> context = new ConcurrentHashMap<>();context.put( HITLAdvisor.HITL_STATE_KEY, new HITLState());context└── hitl.state ├── consumedToolCallIds └── approvedToolNames模型返回toolcall
ChatClientResponse response = chatClient .prompt() .messages(messages) .advisors(a -> context.forEach(a::param)) ///把 context 传入本次 ChatClient 请求
.call() .chatClientResponse();HITLState hitlState = (HITLState) chatClientRequest .context() .get(HITLAdvisor.HITL_STATE_KEY);HITLAdvisor 才能获取到会话状态
ChatResponse└── AssistantMessage └── ToolCall ├── id = call-001 ├── name = getWeather └── arguments = {"city":"北京"} //AssistantMessage.ToolCallHITLAdvisor
工具列表<首先放行工具调用>,此步不执行,仅获取toolcall存在状态
ChatClientResponse response = callAdvisorChain.nextCall(chatClientRequest);//是否存在工具调用//无工具调用直接返回if (!response.chatResponse().hasToolCalls()) { return response;}//有工具调用逐个判断if (!interceptToolNames.contains(tc.name())) { nonInterceptTools.add(tc); continue;}是否已经审批,//审批过自动放行 if (hitlState != null && hitlState.isToolNameApproved(tc.name())) { nonInterceptTools.add(tc); continue;}//未审批封装成pendingToolcallpending.add(new PendingToolCall( tc.id(), tc.name(), tc.arguments(), null, "该工具需要用户手动确认"))添加到上下文
response.context().put( HITLAdvisor.HITL_REQUIRED, true);
response.context().put( HITLAdvisor.HITL_PENDING_TOOLS, pending);中断调用
AgentResult 的实现
AgentFinished:表示任务已经完成,包含最终结果;
AgentInterrupted:表示 HITL 中断,包含以下信息:
- 待确认的工具列表(List);
- 快照上下文 messages;
- context 上下文状态。
run方法的迭代循环中增加HITL_REQUIRED判断,
- 先执行不需要HITL的工具调用
- 满足则直接返回
AgentInterrupted中断元数据 - AgentInterrupted = 一张可恢复的执行快照
if (Boolean.TRUE.equals( response.context() .get(HITLAdvisor.HITL_REQUIRED))) {// 限定只有2个实现类public sealed interface AgentResult permits AgentFinished, AgentInterrupted {}
public record AgentFinished(String content) implements AgentResult {}public record AgentInterrupted(List<PendingToolCall> pendingToolCalls, List<Message> checkpointMessages, Map<String, Object> context) implements AgentResult {}public AgentResult call(String question) {
List<Message> messages = new ArrayList<>(); messages.add(new SystemMessage(REACT_AGENT_SYSTEM_PROMPT)); messages.add(new UserMessage(question));
Map<String, Object> context = new ConcurrentHashMap<>(); context.put(HITLAdvisor.HITL_STATE_KEY, new HITLState());
return run(messages, context);}
private AgentResult run(List<Message> messages, Map<String, Object> context) {
int round = 0;//进行最大轮次数 while (true) { round++; if (maxRounds > 0 && round > maxRounds) { return new AgentFinished(chatClient.prompt() .messages(messages) .advisors(a -> context.forEach(a::param)) .call() .content()); }//调用模型 ChatClientResponse response = chatClient.prompt() .messages(messages) .advisors(a -> context.forEach(a::param)) .call() .chatClientResponse();
// 增加判断HITL_REQUIRED,说明需要人工介入,返回中断元数据 if (Boolean.TRUE.equals(response.context().get(HITLAdvisor.HITL_REQUIRED))) {
// 先执行不需要 HITL 的工具调用,避免它们等待人工审批 //利用Assistant获取工具参数
List<AssistantMessage.ToolCall> nonInterceptTools = (List<AssistantMessage.ToolCall>) response.context().get(HITLAdvisor.HITL_NON_INTERCEPT_TOOLS); //添加到上下文中 if (nonInterceptTools != null && !nonInterceptTools.isEmpty()) { messages.add(AssistantMessage.builder() .toolCalls(response.chatResponse().getResult().getOutput().getToolCalls()) .build()); // 执行非拦截工具,把结果加入 messages for (AssistantMessage.ToolCall tc : nonInterceptTools) { ToolCallback tool = findTool(tc.name()); String result = tool.call(tc.arguments()); messages.add(ToolResponseMessage.builder().responses( List.of(new ToolResponseMessage.ToolResponse(tc.id(), tc.name(), result))).build()); } }
//直接返回中断拦截参数集合 return new AgentInterrupted( (List<PendingToolCall>) response.context().get(HITLAdvisor.HITL_PENDING_TOOLS), List.copyOf(messages), context ); }
if (!response.chatResponse().hasToolCalls()) { return new AgentFinished(response.chatResponse().getResult().getOutput().getText()); }
AssistantMessage assistant = AssistantMessage.builder() .toolCalls(response.chatResponse() .getResult() .getOutput() .getToolCalls()).build();
messages.add(assistant);
for (AssistantMessage.ToolCall tc : assistant.getToolCalls()) {
ToolCallback tool = findTool(tc.name()); String result = tool.call(tc.arguments());
messages.add(ToolResponseMessage.builder().responses( List.of(new ToolResponseMessage.ToolResponse(tc.id(), tc.name(), result))).build()); } }}messages├── SystemMessage├── UserMessage├── AssistantMessage│ ├── ToolCall(getWeather)│ └── ToolCall(search)└── ToolResponseMessage └── response(search)AssistantMessage 中包含两个 ToolCall,但当前只为 search 添加了 ToolResponseMessage
恢复中断
恢复流程由 resume 方法负责
取出快照,恢复HITL状态hitlState
非拦截工具通过最后一个消息是否有ToolResponseMessage
过滤已处理的工具调用hitlState.markConsumed(fb.id())
hitlState.markToolNameApproved() 将该工具名称记录下来,这样同一会话中后续再次调用同名工具时,`HITLAdvisor 会自动放行
构建AssistantMessage(Toolcall)生成ToolResponseMessage
由用户决策ToolResponseMessage是否添加到上下文
public AgentResult resume(AgentInterrupted interrupted, List<PendingToolCall> feedbacks) {//引入工具快照和待审核工具反馈//首先取回快照 List<Message> messages = new ArrayList<>(interrupted.checkpointMessages()); Map<String, Object> context = interrupted.context();//恢复HITL状态 HITLState hitlState = (HITLState) context.get(HITLAdvisor.HITL_STATE_KEY);
// 检查是否有非拦截工具已执行(通过判断最后一个消息是否是 ToolResponseMessage) boolean hasNonInterceptExecuted = !messages.isEmpty() && messages.get(messages.size() - 1) instanceof ToolResponseMessage;
List<AssistantMessage.ToolCall> toolCalls = new ArrayList<>();
// 过滤已处理的工具调用,避免重复 HITL for (PendingToolCall fb : feedbacks) { if (hitlState.isConsumed(fb.id())) { continue; } // 标记为已处理 hitlState.markConsumed(fb.id());
//标记该工具名称为已审批,后续同名工具调用自动通过 if (fb.result() == PendingToolCall.FeedbackResult.APPROVED) { hitlState.markToolNameApproved(fb.name()); }
//构建AssistantMessage(Toolcall)方便以后调用生成ToolCallResponseMessagetoolCalls.add(new AssistantMessage.ToolCall(fb.id(), "function", fb.name(), fb.arguments())); }// 只有在没有非拦截工具执行的情况下,才需要补全 tool_call 消息 if (!toolCalls.isEmpty() && !hasNonInterceptExecuted) { messages.add(AssistantMessage.builder().toolCalls(toolCalls).build()); }
// 将消费过的工具调用结果添加到消息中(用户进行决策) for (PendingToolCall fb : feedbacks) { if (hitlState.isConsumed(fb.id())) { String result; if (fb.result() == PendingToolCall.FeedbackResult.REJECTED) { result = "用户不同意执行此工具,工具名称:" + fb.name() + ",工具描述:" + fb.description(); } else { // 这边同意和编辑简单处理,实际可以让用户重新编辑arguments ToolCallback tool = findTool(fb.name()); result = tool.call(fb.arguments()); }
//工具执行结果添加到 messages.add(ToolResponseMessage.builder().responses(List.of(new ToolResponseMessage.ToolResponse(fb.id(), fb.name(), result))).build()); } }
// 继续执行主循环 return run(messages, context);}RUNNING ↓模型生成 ToolCall ↓HITLAdvisor 判断 ├── 工具无需审批 ──→ EXECUTING │ ↓ │ ToolResponseMessage │ ↓ │ RUNNING │ └── 工具需要审批 ──→ INTERRUPTED ↓ 用户 APPROVED ↓ EXECUTING ↓ ToolResponseMessage ↓ RUNNING
INTERRUPTED ↓用户 REJECTED ↓构造拒绝 ToolResponseMessage ↓RUNNING ↓模型决定替代方案或最终回答
RUNNING ↓没有 ToolCall ↓FINISHED
模型返回 ToolCall ↓HITLAdvisor 拦截 ↓判断工具是否需要人工审批 ├── 不需要:Agent 直接执行 └── 需要:返回 AgentInterrupted ↓ 用户审批 ↓ resume 恢复执行 ↓ 添加 ToolResponseMessage ↓ 再次调用模型关闭chatClient自动执行
.internalToolExecutionEnabled(false)pendingToolCalls 数量==feedbacks 数量Multi
SubAgent
单智能体能做很多事,但任务一复杂就容易遇到几个问题
- 上下文窗口不够,注意力发散
- 不同子任务需要不同模型或专长
- 任务太大,单体效率慢
- 任务不够聚焦,效果不稳定
- 工具太多,容易选错
子智能体模式 主 Agent 把别的 Agent 当成工具调用。 适合:一个主控,多个专才。
- 主Agent负责决定调用哪个子Agent,提供什么输入,以及如何组合结果。
- 子Agent是无状态的——它们直接和用户交互,所有的对话和记忆都由主代理维护
- 提供了上下文隔离:每个子代理的调用都在一个干净的上下文窗口中工作,防止主对话中的上下文膨胀
// 创建子AgentReactAgent writerAgent = ReactAgent.builder().name("writer_agent").model(chatModel).description("可以写文章").tolls(...).instruction("你是一个知名的作家,擅长写作和创作。请根据用户的提问进行回答。").build();
// 创建主Agent,将子Agent作为工具ReactAgent blogAgent = ReactAgent.builder().name("blog_agent").model(chatModel).instruction("根据用户给定的主题写一篇文章。使用写作工具来完成任务。")//将子agent当作工具.tools(AgentTool.getFunctionToolCallback(writerAgent)).build();
// 使用Optional<OverAllState> result = blogAgent.invoke("帮我写一个100字左右的散文");- MethodToolCallback构造一个ToolBack方法将agent的名字和描述作为工具的描述
- 将AgentToolExecutor这个内部类的executeAgent作为方法的工具的实际调用方法。直接调用Graph底层的invoke方法做执行
Agent Tool 解决“怎么调用别的 Agent,Handoffs 解决“谁来继续对话”,Graph 解决“这些步骤怎么编排起来
Handoff
接管交接模式 当前 Agent 发现自己不适合继续,就把任务转交给更合适的 Agent。 适合:按阶段接力完成任务。
AutoGen: 使用事件驱动和发布-订阅(Pub/Sub)模型。每个智能体订阅一个特定的“主题”(Topic)。当一个智能体调用“交接工具”时,它会向目标智能体的主题发布一个包含完整上下文的新消息(UserTask),从而激活目标智能体
LangChain/LangGraph: 将交接视为图(Graph)。交接工具会返回一个 Command 对象,该对象可以:
-
更新状态(
update):改变current_step变量,让同一个智能体在下一轮使用不同的提示词和工具(单智能体动态配置)。 -
跳转节点(
goto):直接指定下一个要执行的智能体节点(多智能体子图)。
**Spring AI Alibaba:**底层是参考了LangGraph的。
SequentialAgent:按顺序执行,前一个输出喂给后一个
SequentialAgent blogAgent = SequentialAgent.builder() .name("blog_agent") .description("根据用户给定的主题写一篇文章,然后将文章交给评论员进行评论") .subAgents(List.of(writerAgent, reviewerAgent)) .build();- ParallelAgent:多个 Agent 并行处理同一输入,最后合并结果。
ParallelAgent parallelAgent = ParallelAgent.builder() .mergeOutputKey("merged_results") .subAgents(List.of(proseWriterAgent, poemWriterAgent, summaryAgent)) .mergeStrategy(new ParallelAgent.DefaultMergeStrategy()) .build();- LlmRoutingAgent:LLM 只路由一次,选一个最合适的子 Agent
LlmRoutingAgent routingAgent = LlmRoutingAgent.builder() .subAgents(List.of(writerAgent, reviewerAgent, translatorAgent)) .build();SupervisorAgent:监督者多轮调度,子 Agent 做完还能回来继续决策,适合“写完再翻译
SupervisorAgent supervisorAgent = SupervisorAgent.builder() .subAgents(List.of(writerAgent, translatorAgent)) .build();**LlamaIndex:**LlamaIndex内置了一个AgentWorkflow,它本质上是一个预设了理解智能体、状态和工具调用的工作流。实现了自动化的智能体 Handoff。开发者只需定义多个专业化智能体并指定入口,框架即可在它们之间动态转移控制权,形成端到端的多智能体协作流水线。
Chat Group
群聊模式 多个 Agent 在同一个“群”里轮流发言,由管理器决定谁下一步发言。 适合:需要动态讨论、逐步推进的复杂任务。
AutoGen
AutoGen 由微软开发的一个开源框架,用来简化构建多智能体(Multi-Agent)系统和复杂 LLM(大语言模型)工作流的过程
- AssistantAgent:扮演助手角色,通常基于大语言模型(如 GPT-4、Claude、Llama 等)生成内容。
- UserProxyAgent:代表用户,可以自动执行代码、调用函数、请求人类输入等。
- UserProxyAgent 支持自动执行由 LLM 生成的 Python 代码,并在隔离环境中运行(如docker)
- GroupChatManager:协调多个智能体进行群聊(GroupChat),支持轮询、发言权控制等策略。
- Tool-using Agents:可集成外部工具(如搜索引擎、数据库、API)
GroupChat
一个用于管理多个智能体之间对话流程的类。它定义了一个“群聊”环境,其中包含一组参与对话的智能体(agents),并控制对话如何进行(例如轮次限制、发言顺序等
- agents: 一个包含所有参与群聊的智能体的列表(如 UserProxyAgent、AssistantAgent 等)。
- max_round: 最大对话轮数,防止无限循环。
- speaker_selection_method: 决定下一位发言者的方式,可选:
"auto"(默认):由 LLM 根据上下文自动选择下一个发言者。"round_robin":按固定顺序轮流发言。"random":随机选择。也可以传入自定义函数。- allow_repeat_speaker: 是否允许同一个智能体连续发言(默认为 True)。
- send_introductions: 是否在开始时让每个智能体发送自我介绍。
Manager
群聊管理器
- 监听消息:接收来自其他智能体的消息。
- 决定下一个发言者:根据 GroupChat 中设定的
speaker_selection_method选择下一个应该发言的智能体。 - 转发消息:将当前消息传递给下一个发言者,并触发其响应。
- 控制终止条件:当达到最大轮数或某个智能体返回终止信号(如
TERMINATE)时,结束对话。
import autogen
OPENAI_API_KEY = "<你的 api key>"OPENAI_API_BASE = "https://dashscope.aliyuncs.com/compatible-mode/v1"
# 配置 LLM(替换为你的 API 密钥)config_list = [ { "model": "deepseek-v3", "api_key": OPENAI_API_KEY, "base_url": OPENAI_API_BASE, }]llm_config = {"config_list": config_list}# 1. 定义三个智能体product_manager = autogen.AssistantAgent( name="ProductManager", system_message="你是一名产品经理。请清晰描述用户需求,并确保功能定义无歧义。", llm_config=llm_config,)
software_engineer = autogen.AssistantAgent( name="SoftwareEngineer", system_message="你是一名资深 Python 工程师。请根据产品需求编写简洁、正确的代码,并附带使用示例。", llm_config=llm_config,)
code_reviewer = autogen.AssistantAgent( name="CodeReviewer", system_message=( "你是代码审查员。你的职责是:\n" "1. 检查代码是否满足产品需求;\n" "2. **但不要假设代码运行正确**;\n" "3. **不要回复 TERMINATE**;\n" "4. 如果代码逻辑有明显错误,请指出;\n" "5. 如果代码看起来合理,请说:'代码逻辑无明显错误,请 UserProxy 执行验证。'\n" "只有在 UserProxy 执行后,确认输出符合预期,才可回复 TERMINATE。" ), llm_config=llm_config,)
# 2. 用户代理(启动任务 + 可选执行代码)user_proxy = autogen.UserProxyAgent( name="User", human_input_mode="NEVER", max_consecutive_auto_reply=10,
/// UserProxyAgent 配置了 code_execution_config,允许它://在本地目录(work_dir="coding")中自动执行 Python 代码; code_execution_config={ "work_dir": "coding", "use_docker": False, }, is_termination_msg=lambda x: any( term in x.get("content", "") for term in ["TERMINATE", "批准通过", "任务完成"] ),)
# 3. 创建群聊groupchat = autogen.GroupChat( agents=[user_proxy, product_manager, software_engineer, code_reviewer], messages=[], max_round=12, speaker_selection_method="auto", # 让 LLM 决定下一个发言者 //由 LLM 自主决定下一位发言者(基于上下文),这是 AutoGen 的高级调度策略)
manager = autogen.GroupChatManager( groupchat=groupchat, llm_config=llm_config,)
# 4. 启动群聊user_proxy.initiate_chat( manager, message=( "我需要一个函数:输入一个字符串列表,返回其中最长的字符串。" "如果有多个一样长的,返回第一个。" "请实现该函数,并用以下测试用例验证:" "['apple', 'hi', 'banana', 'cat'] → 应返回 'banana';" "[] → 应抛出 ValueError。" "请 SoftwareEngineer 用 ```python 代码块提供完整可执行代码,包括测试用例。" "在代码审核通过后,UserProxy 执行后再结束。" ),)A2A协议
开始
- 主 Agent 先发现对方能干什么,先读远程 Agent 的 Agent Card确认能力
- 主 Agent 判断“这个活能不能外包,找专业的子agent
- 主 Agent 发的是 Message,不是裸
Task。客户端通过SendMessage把消息发出去,服务端返回的是Task或直接返回Message。 - 服务端决定怎么处理。简单问题可以直接回
Message;复杂问题会创建 Task,Task就是“可跟踪的工作单元”。 Task会有状态流转。官方状态包括:SUBMITTED、WORKING、COMPLETED、FAILED、CANCELED、INPUT_REQUIRED、AUTH_REQUIRED、REJECTED。- A2A 不是“发出去等一个答案”,而是“围绕任务生命周期协作”。
- 结果和过程可以分开传。
结果可能是普通消息,也可能带
Artifact,比如报告、文件、图片、日志。 长任务还可以流式回传状态更新。
contextId 是把一串互动串起来的“总上下文”。
taskId 是某一次具体任务;contextId 是这段协作会话。
任务终态后不能原地重启,要在同一个 contextId 下开新任务继续。
上下文工程
初识
Token
所有输入和输出文本都会被转换为 Token 序列,1个Token约对应3~4个英文字符;通常约对应 1.5~1.8 个中文字符
Prompt
Context 指的是模型在生成当前回复时所能“看到”的全部信息,通常包括:
-
用户当前的 Prompt(System Prompt+User Prompt);
之前的对话历史(包括模型输出,工具执行结果);
-
工具清单(MCP&Function Calling)
-
ReAct Agent的Thought/Action/Observation等内容
-
外部知识注入(如 RAG 检索结果)。
Memory
- 短期记忆:即对话上下文(Context),随对话结束而消失。
- 长期记忆:通过外部数据库、向量存储等方式保存用户偏好、历史行为等,在后续对话中检索使用。
上下文太长会带来什么问题
- Token 爆炸和上下文窗口超限
- 中间信息被忽略
- 错误信息引入
错误事实被后续推理放大,应该保存结构化信息
{ "taskId": "task-2", "tool": "search", "query": "北京周末天气预警", "success": true, "source": "search-service", "result": "..."}- 上下文分散
重要信息被无关内容淹没,进行上下文压缩或者过滤
ya'suo结构化状态由代码保存自然语言内容才交给模型压缩class AgentState { String userGoal; List<TaskResult> taskResults; CritiqueResult lastCritique; List<String> openIssues;}- 上下文混乱
工具和选项太多,模型难以选择,设置工具路由
当前问题属于天气查询 ↓只加载 weather 相关工具 ↓主 Agent 执行- 上下文冲突
多个相互矛盾的事实同时存在
为信息增加时间和来源,明确优先级
最新的权威工具结果 >旧工具结果>模型推断 >历史记忆{ "source": "search", "createdAt": "...", "taskId": "task-3", "reliability": "unknown"}Write
Write:把重要信息写入上下文之外,把信息持久化保存,以后需要时再取出来。
- Scratchpad:短期工作记忆
public static class OverAllState { private final String question; private final List<Message> messages; private final List<PlanRoundState> rounds; private int round;}- Long Term Memory:长期记忆
长期记忆库 ↓根据当前问题检索相关内容 ↓只把相关内容注入本轮 ContextSelect
不是所有已经保存的信息,都应该进入当前上下文。
- 选择相关记忆,不需要加载用户全部历史会话
- 动态选择工具
- 选择相关规则,不同任务加载不同规则
Compress
- 删除对当前任务没有价值的信息,保留下一轮决策所必需的信息
- 结构化状态最好由代码维护,而不是完全交给模型改写
Isolate
不要让所有任务共用一个巨大上下文。拆分并隔离上下文
- 多智能体隔离
主 Agent Context ├── 用户目标 ├── 子任务状态 └── 子 Agent 返回的结论
天气 Agent Context └── 天气查询相关信息
搜索 Agent Context └── 搜索任务相关信息
PlanExecuteAgent ↓SimpleReactAgentPlanExecuteAgent 负责任务级调度,SimpleReactAgent 负责单个任务内部的工具调用。这本身就是一种上下文隔离。
- 沙盒隔离
大文件 ↓保存到文件系统或对象存储 ↓Context 中只保留路径、ID、摘要和引用
已将搜索结果保存到:/workspace/results/beijing-weather.json赋予 Agent 读写能力+大内容外存+上下文仅保留指针+可恢复压缩
渐进式披露
先给模型一个目录,模型需要时再加载详细内容。
能力目录 ↓模型选择能力 ↓加载详细规则 ↓执行任务KV Cache
模型推理 ↓调用工具 ↓得到观察结果 ↓把结果追加到上下文 ↓再次调用模型- 每次请求都会包含大量相同的前缀
- 首次处理长上下文的 prefill 阶段,仍然需要处理整个输入。所以 Agent 设计中要尽量保证前缀稳定。
提高缓存命中率
- 不要在 System Prompt 中放动态时间
当前时间:{now}//将动态时间放到上下文的末尾- 固定 Prompt 模板
系统提示词,工具定义,消息结构
- 保持 JSON 字段顺序稳定
{"city":"北京","days":7} //token序列改变- 尽量采用 append-only,不修改历史消息
- 分布式环境固定会话路由
前缀预填充
在上下文中保留所有工具的定义,不针对这个东西做修改,避免影响KV Cache,响应预填充+统一工具前缀等方案来遮蔽工具
人为写入一部分固定的 token 序列作为“开头
<|im_start|>assistant{"name": "browser_
browser_search, browser_navigate回顾问题
执行很多工具时,忘记用户最初的问题
在上下文末尾反复维护一个轻量任务
【Current Goal】生成北京周末旅游分析报告。
【Completed】1. 已查询北京今日天气。
【Pending】1. 确认周末天气预警。2. 根据预警推荐景点。3. 生成最终报告。保留错误
错误不能简单删除,应该选择保留
【Failed Action】tool: getWeatherarguments: {}error: city 参数缺失next constraint: 必须提供 city长期记忆
初识
- 长期记忆使得跨对话也能有记忆,记住用户偏好
- 短期记忆conversation id限制
长期记忆一定是持久化记忆,但是持久化记忆(Mysql,Redis)不一定是长期记忆
实现方式
向量化存储 + 向量检索
- 将文本(如对话片段、知识条目)通过嵌入模型转换为向量。
- 存入向量数据库(如 Pinecone、Weaviate、Chroma、Milvus)。
- 在需要时,用当前查询生成嵌入,进行相似性搜索(ANN 检索)召回相关记忆。
结构化数据库
- 存储用户档案、任务日志、配置信息等结构化数据(如 SQL/NoSQL)。
- 适用于精确查询(如“用户上次购买时间”)。
图数据的存储用户画像、关联关系通过图数据库维护
混合记忆架构结合向量检索(语义记忆)与结构化存储(事实记忆)、图数据库。例如:用向量库存对话摘要,用关系库存用户 ID 和偏好设置。
用户配置/规则文件如 Cursor 的 .cursor/rules文件,用户显式定义偏好、约束、项目规范等,作为系统提示的一部分。
微调微调也是一种长期记忆方案,就是使用用户的历史交互数据微调一个专属模型副本。
Mem0
Mem0它并不是个存储,他只是一个框架,由 LLM 驱动、向量+图双引擎支撑、协议标准化、完全本地可控的 AI 记忆中间件
- 记忆提取:利用记忆分析器提取用户偏好和意图转换为结构化记忆条目
- 向量化与存储:每条记忆被嵌入成向量,向量存储在向量数据库中,并关联到特定用户 ID,支持元数据(如时间戳、来源对话 ID)以便后续过滤或排序
- 记忆检索
根据当前用户输入查询向量数据库,通过相似度搜索召回最相关的过往记忆。可结合时间衰减、相关性评分等策略对记忆进行重排序 - 上下文注入与生成,记忆去重与演化
原理
- LLM:负责记忆提取和自然语言理解
- 向量数据库:用于高效语义检索,将对话中提取的关键信息嵌入为高维向量。
- Embedding模型***:***用于将记忆内容做向量化嵌入
- 图数据库(可选):用于追踪实体之间的关系(如“爱丽丝的朋友是约翰”),支持复杂的情境推理。
- sqlLite数据库(内置):本地存储记忆历史
添加记忆
- 利用LLM 提取用户偏好,冲突检测,自动处理检测合并新旧偏好
- 结构化存储:内容被向量化并存入向量库;
- 实体和关系被提取并存入图数据库;
- 支持附加元数据(如
category: movies,importance: high)。
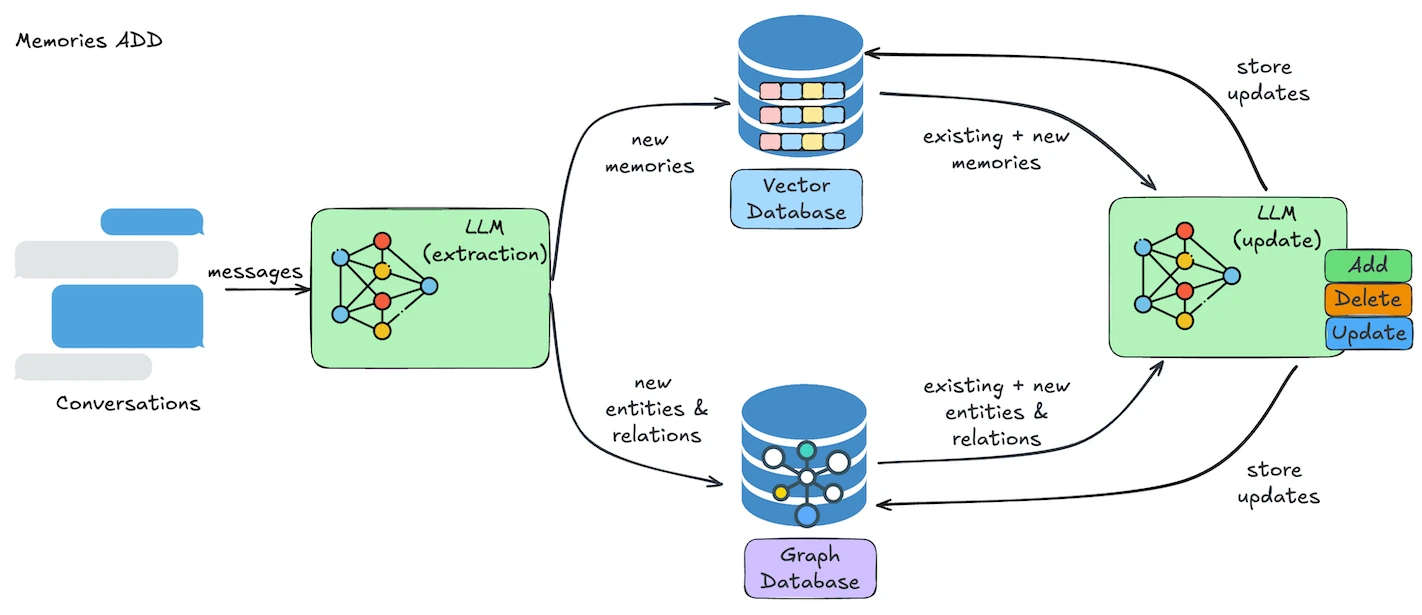
检索记忆
查询理解:LLM 对用户问题进行语义优化
多路检索
- 向量搜索:基于语义相似度召回相关记忆;
- 图查询:根据实体关系扩展上下文(如“谁是蜘蛛侠?” → “彼得是蜘蛛侠”)。
结果排序:综合相关性、时效性、重要性等维度返回最匹配的记忆
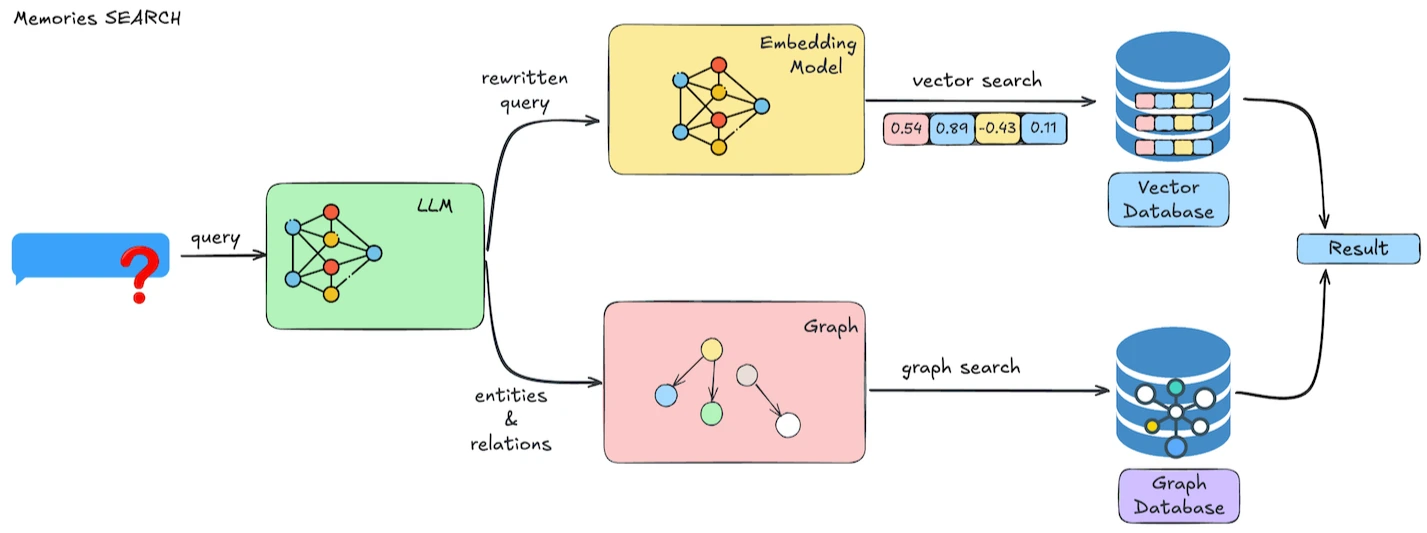
部署
- 把mem0暴露成一个REST Api
- lyf-top/Mem0Install: Mem0部署
- 启动成功后,可以通过http://localhost:8888/docs 访问。
进行记忆的CRUD调用之前,需要调一下/configure方法,做初始化
SpringAi
依赖
<dependency> <groupId>com.alibaba.cloud.ai</groupId> <artifactId>spring-ai-alibaba-starter-memory-long</artifactId> <version>1.1.0.0-M5</version></dependency>依赖了spring-ai-alibaba-starter-memory-mem0
- Mem0ServiceClient调用他的configure方法,进行CRUD
- Mem0ChatMemoryAdvisor
spring-ai-alibaba-autoconfigure-memory-long
一些配置和初始化的东西
配置项
spring: ai: alibaba: mem0: client: base-url: http://127.0.0.1:8888 timeout-seconds: 120 server: version: v1.0.0 vector-store: provider: pgvector config: host: postgres port: 5432 dbname: postgres user: postgres password: postgres collection-name: memories graph-store: provider: neo4j config: url: bolt://neo4j:7687 username: neo4j password: mem0graph llm: provider: openai config: api-key: <你自己的KEY> temperature: 0.2 model: deepseek-v3 openai-base-url: https://dashscope.aliyuncs.com/compatible-mode/v1 embedder: provider: openai config: api-key: <你自己的KEY> model: text-embedding-v4 openai-base-url: https://dashscope.aliyuncs.com/compatible-mode/v1实现
@RestController@RequestMapping("/longTermMemory")public class LongTermMemoryController implements InitializingBean {
@Autowired private DashScopeChatModel chatModel;
private ChatClient chatClient;
@Autowired private VectorStore mem0MemoryStore;
@RequestMapping("/chat") public String chat(String message, String userId) { return chatClient.prompt(message) .advisors( req -> req.params(Map.of(USER_ID, userId)) ) .call().content(); }
@Override public void afterPropertiesSet() throws Exception { Mem0ChatMemoryAdvisor mem0ChatMemoryAdvisor = Mem0ChatMemoryAdvisor.builder(mem0MemoryStore).build(); this.chatClient = ChatClient.builder(chatModel) .defaultAdvisors(mem0ChatMemoryAdvisor) .build(); }}advisor
Harness
Agent = 模型 (Model) + Harness
- 模型:负责思考、推理、决策
- Harness:负责稳定、不崩、不跑偏、可持久、可恢复
Skill
初识
- 把已经验证有效的做事方式抽象成独立能力模块,
- 让 Agent 在需要时自动加载和执行
- 大模型能力可复用、可管理的工程化机制
my-skill/ # 技能名称├── SKILL.md # 必选:技能的介绍说明与指令约束├── scripts/ # 可选:可执行的脚本├── references/ # 可选:可参考的示例文件└── assets/ # 可选:图片等资源文件结构
Skill 的入口定义 + 指令规范,由两个部分组成:Frontmatter(元数据) + Instruction(指令正文)
Instruction 本质上就是一份面向专业领域、特定功能的高质量 Prompt。
- 为后续的 Script、Reference 提供清晰的使用说明和调用指引
- instruction 负责告诉 Agent 怎么做,Reference 负责在需要时补充细节
Frontmatter(元数据)---name: pdf-processing 技能唯一标识(agent 用它来识别技能)description: Extract text and tables from PDF files, fill forms, merge documents. 简要说明技能做什么、在什么情况应该被激活---
# PDF Processing
## When to use this skillUse this skill when the user needs to work with PDF files...
## How to extract text1. Use pdfplumber for text extraction...
## How to fill forms- 自动扫描指定的 Skill 目录
- 只读取被
---包裹的 Frontmatter 元数据 - 基于
name和description完成技能发现与能力匹配
只有当 Agent 判断当前任务确实需要该 Skill 时,才会进一步加载 SKILL.md 中的指令正文内容
- MCP 关注的是 Agent 如何连接外部世界、外部工具,它定义的是工具如何被暴露给大模型使用;
- Script 关注的是在某一个具体 Skill内,哪些步骤必须用确定性代码来完成
接入skill
前置
引入SpringAlibaba的依赖
<dependency> <groupId>com.alibaba.cloud.ai</groupId> <artifactId>spring-ai-alibaba-starter-dashscope</artifactId> <version>1.1.2.0</version></dependency>
<dependency> <groupId>com.alibaba.cloud.ai</groupId> <artifactId>spring-ai-alibaba-agent-framework</artifactId> <version>1.1.2.0</version></dependency>文件读取的依赖
<dependency> <groupId>org.apache.pdfbox</groupId> <artifactId>pdfbox</artifactId> <version>3.0.3</version></dependency>
<dependency> <groupId>org.apache.poi</groupId> <artifactId>poi-ooxml</artifactId> <version>5.3.0</version></dependency>
<dependency> <groupId>org.apache.poi</groupId> <artifactId>poi-scratchpad</artifactId> <version>5.3.0</version></dependency>加载skill
src/main/resources/skills/└── resume-check/ ├── SKILL.md └── jd.mdSkillRegistry skillRegistry = ClasspathSkillRegistry.builder() .classpathPath("skills") .build();读取文件
Skil.md文件需要定义read_file这个字段
read_file(path, startPage, endPage)绝对路径 classpath: 路径 http(s):// 网络地址根据扩展名找到对应的解析器,最终返回字符串截断到最大字符数给大模型
必须调用 read_file 读取以下文件:classpath:skills/resume-check/jd.md不得将该路径改写为相对路径,不得通过 Shell 搜索该文件。React
模型读取 Skill 列表 ↓调用 read_skill ↓获取完整 SKILL.md ↓发现需要读取 JD 和简历 ↓调用 ShellTool 或 read_file ↓获取 JD 内容和简历内容 ↓按照 SKILL.md 生成报告- SkillsAgentHook 负责 Skill 发现和 Skill 内容读取;
- ShellToolAgentHook 负责执行 Shell 命令,例如下载远程文件;
- FileReaderTool 负责解析文件内容;
- MemorySaver 负责保存 Agent 状态
@RestController@RequestMapping("/skill")public class SkillController {
@Autowired private ChatModel dashScopeChatModel;
@RequestMapping("/resumeCheck") public String resumeCheck(String message) throws GraphRunnerException {
// 1. 技能注册表:从 classpath:skills 加载 SkillRegistry registry = ClasspathSkillRegistry.builder() .classpathPath("skills") .build();
// 2. Skills Hook:注册 read_skill 工具并注入技能列表到系统提示 SkillsAgentHook skillsHook = SkillsAgentHook.builder() .skillRegistry(registry) .build();
// 3. Shell Hook:提供 Shell 命令执行,用于文件下载 ShellToolAgentHook shellHook = ShellToolAgentHook.builder() //避免脚本执行超时,超时时间设置的长一点 .shellTool2(ShellTool2.builder("/tmp/skills/resume-check/").withCommandTimeout(300000).build()) .build();
// 4. 构建 Agent:同时挂载 Skills Hook、Shell Hook、 文件读取工具 ReactAgent agent = ReactAgent.builder() .name("resume-agent") .model(dashScopeChatModel) .saver(new MemorySaver()) //文件读取工具 .tools(ToolCallbacks.from(new FileReaderTool())[0]) .hooks(List.of(skillsHook, shellHook)) .enableLogging(true) .build();
RunnableConfig config = RunnableConfig.builder() .threadId("10088") // threadId 指定会话 ID,暂时写死 .build();
AssistantMessage assistantMessage = agent.call(message, config);
return assistantMessage.getText(); }ChatClient
用户请求 ↓SpringAiSkillAdvisor.before() ↓将当前可用 Skill 列表追加到 System Prompt ↓模型发现 resume-check Skill ↓模型调用 read_skill ↓读取完整 SKILL.md ↓模型调用 read_file ↓读取 JD 和简历 ↓生成最终评估报告
ChatClient ├── SpringAiSkillAdvisor ├── read_skill └── read_file read_file 已经支持 HTTP URL- SpringAiSkillAdvisor 只负责把 Skill 列表告诉模型,并不一定直接把完整的 SKILL.md 内容放入上下文
- read_skill让模型主动某个 Skill 的完整内容相当于ShellToolAgentHook
@RestController@RequestMapping("/skill")public class SkillController {
@Autowired private ChatModel dashScopeChatModel;
@PostConstruct public void init() {
/* 1. 创建 ClasspathSkillRegistry,从 classpath:skills/ 下加载 Skill */ SkillRegistry skillRegistry = ClasspathSkillRegistry.builder() .classpathPath("skills") .build();
/* 2. 创建 read_skill 工具的 ToolCallback 这是 LLM 在推理时主动调用的工具,用于按需读取某个 Skill 的完整 SKILL.md 内容 */ ToolCallback readSkillToolCallback = ReadSkillTool.createReadSkillToolCallback(skillRegistry, null);
/* 3. 创建文件读取工具的 ToolCallback */ ToolCallback[] fileReaderToolCallback = ToolCallbacks.from(FileReaderTool.class);
/* 4. 创建 SpringAiSkillAdvisor,把 SkillRegistry 注入进去 Advisor 会在每次对话的 before() 阶段将 Skill 列表追加到 System Prompt */ SpringAiSkillAdvisor skillAdvisor = SpringAiSkillAdvisor.builder() .skillRegistry(skillRegistry) .build();
/* 5. 创建 ChatClient,并注入 SkillAdvisor 和 read_skill 工具 */ this.chatClient = ChatClient.builder(chatModel) .defaultAdvisors(skillAdvisor) .defaultToolCallbacks(readSkillToolCallback, fileReaderToolCallback[0]) .build();
}
@RequestMapping("/resumeCheck") public String resumeCheck(String message) throws GraphRunnerException { return chatClient.prompt() .user(message) .call() .content(); }}原理
注册
-
SkillScanner 遍历 Skill 根目录下的子目录skill.md
-
SkillMetadata 中可能已经保存了完整正文,并注册到内存Map里
-
在模型真正调用
read_skill之前,正文不会被放进模型上下文 -
SkillRegistry接口有两个实现类FileSystemSkillRegistry和ClasspathSkillRegistry
| 实现 | 来源 | 特点 |
|---|---|---|
FileSystemSkillRegistry | 文件系统目录 | 支持 user 和 project 两级 Skill;project 中的同名 Skill 覆盖 user 中的 Skill。 |
ClasspathSkillRegistry | classpath / JAR | 兼容开发环境中的 classpath 资源和生产环境中的 JAR 资源。 |
摘要
通过 Advisor 或 Interceptor 机制,把每个skills的摘要信息名称 + 描述 + 路径)拼接成一段文本注入到System Prompt这样LLM知道skill的大致能力
集成
| 维度 | Advisor 模式 | Agent Hook + Interceptor 模式 |
|---|---|---|
| 主要场景 | ChatClient | ReactAgent |
| 入口 | BaseAdvisor.before() | SkillsAgentHook.beforeAgent() |
| Skill 摘要注入 | Advisor 增强 System Message | SkillsInterceptor 增强 System Message |
| 自动重新加载 | Advisor 调用时处理 | Hook 根据 autoReload 处理 |
read_skill 暴露 | 需要随 ChatClient 工具配置集成 | Hook 的 getTools() 自动暴露 |
| 动态专用工具 | 基础流程通常不负责 | Interceptor 原生支持 groupedTools |
| 历史消息扫描 | 通常没有 | 扫描历史 read_skill ToolCall |
| 适用复杂度 | 单次、轻量对话 | 多轮 Agent、工具逐步解锁 |
- before()方法中完成技能列表的注入——reload 注册中心、获取技能列表、构建技能 prompt、增强系统消息。after()方法不做任何处理。这种方式适合直接用ChatClient 的场景
@Overridepublic ChatClientRequest before(ChatClientRequest chatClientRequest, AdvisorChain advisorChain) { // 加载/重新加载 Skill 注册信息 loadSkillsToRegistry();
List<SkillMetadata> skills = skillRegistry.listAll(); if (skills.isEmpty()) { return chatClientRequest; }
// 构建 Skill 提示词并追加到 System Message String skillsPrompt = buildSkillsPrompt(skills, skillRegistry, skillRegistry.getSystemPromptTemplate()); SystemMessage systemMessage = chatClientRequest.prompt().getSystemMessage(); SystemMessage enhanced = enhanceSystemMessage(systemMessage, skillsPrompt);
return chatClientRequest.mutate() .prompt(chatClientRequest.prompt().augmentSystemMessage(enhanced.getText())) .build();}SkillsAgentHook 是一个 AgentHook,标注 @HookPositions(HookPosition.BEFORE_AGENT),在 Agent 执行前触发
- 如果开启了 autoReload,在 beforeAgent 中重新加载 Skill;
- 通过 getTools() 方法暴露 read_skill 工具给 Agent;
- 通过 getModelInterceptors() 自动创建并注册 SkillsInterceptor
模型调用之前,SkillsInterceptor 是一个模型拦截器
- 在每次 LLM 调用前执行 interceptModel 方法。它先通过 buildSkillsPrompt 将 Skill 列表注入 System Message;
- 扫描对话 AssistantMessage调用过 read_skill 工具读取了某个 Skill,就从 groupedTools 中找到该 Skill 关联的专用工具,添加到 dynamicToolCallbacks 中
@Overridepublic ModelResponse interceptModel(ModelRequest request, ModelCallHandler handler) { List<SkillMetadata> skills = skillRegistry.listAll(); if (skills.isEmpty()) { return handler.call(request); }
// 1. 扫描历史消息,提取 read_skill 调用的 skill_name Set<String> readSkillNames = extractReadSkillNames(request.getMessages());
// 2. 根据 skill_name 注入关联的动态工具 List<ToolCallback> skillTools = new ArrayList<>(request.getDynamicToolCallbacks()); for (String skillName : readSkillNames) { List<ToolCallback> toolsForSkill = getGroupedTools().get(skillName); if (toolsForSkill != null) skillTools.addAll(toolsForSkill); }
// 3. 注入 Skill 列表到 System Prompt String skillsPrompt = buildSkillsPrompt(skills, skillRegistry, skillRegistry.getSystemPromptTemplate()); SystemMessage enhanced = enhanceSystemMessage(request.getSystemMessage(), skillsPrompt);
// 4. 构建增强后的请求 return handler.call(ModelRequest.builder(request) .systemMessage(enhanced) .dynamicToolCallbacks(skillTools) .build());}读取Skill
ReadToolSkill被SpringAl封装成Toolcallback,SkillRegistry.readSkillContent(name) 读取对应 SKILL.md
动态工具注入在第二次调用interceptModel方法
sql-schema -> get_database_schema -> execute_readonly_sql
web-research -> web_search -> fetch_page
Assistant 是否调用过 read_skill("sql-schema") │ ├─ 否:不注入数据库工具 │ └─ 是:把 sql-schema 对应工具加入 dynamicToolCallbacks渐进式披露
| 层级 | 组件名称 | 内容类型 | 加载策略 | Token 消耗权重 | 设计目的 |
|---|---|---|---|---|---|
| L1 | Metadata | Skill 名称、描述、版本号等元数据 | Always-On(常驻) | 极低(< 1%) | 供 Agent 进行技能发现、路由决策与意图识别 |
| L2 | Instruction | SKILL.md 正文中的执行规则与操作流程 | On-Demand(命中后加载) | 中等(约 5%~10%) | 定义具体的业务处理逻辑、执行步骤与 SOP |
| L3 | Reference | 外部文档、手册、规范、示例等补充资料 | Context-Triggered(条件触发) | 高(可变) | 提供当前任务所需的领域知识,用完即弃 |
| L4 | Script | Python、Shell 等可执行脚本 | Execution-Only(仅执行) | 近似为零(不读取代码) | 通过确定性代码完成复杂处理,并实现必要的外部副作用 |
Opencode
扫描
元数据在内存中表示
{ name: "my-skill", description: "...", location: "/absolute/path/SKILL.md", //用于定位 Skill 目录 content: "..." //真正激活后提供完整指令}找到所有 SKILL.md ↓读取文件 ↓解析 frontmatter ↓验证 name 和 description ↓注册到内存重名后注册的对象会覆盖先注册的对象。项目和全局skill名字
懒加载
skil初始化不是应用启动时立即执行,而是第一次调用 state() 时才执行
export const state = Instance.state(async () => { // 扫描和解析 Skill return { skills, dirs }})if (已经初始化) { return 缓存结果;}return 执行初始化并缓存;摘要
AgentRunTIme向SillRegistry查询可用skil,返回摘要和元数据
系统提示中只注入摘要,不会注入skill.md
- resume-check Skill发送给LLM适合简历评估任务
- 如果需要,可以调用 skill 工具加载它
- 但是没有skill.md文件,这时需要渐进式批露加载
- 启动时只暴露目录,任务匹配时加载正文
SkilTool
- 返回结果为模型继续执行的指令相当于read_skill(模型自主判断)
- 从SkillRegistry询skill找不到列出可用skill
- 执行权限检查,查找附属文件
- 拼接完整的skill内容并添加到上下文交给LLM 请求AgentRuntime,执行skill.md中的classpath使用 read_file
- 返回JD文本和简历文本,根据Skill.md生成评估报告返回给AgentRuntime
BaseDirectory
jd.md变成相对路径JD 文件位置:
classpath:skills/resume-check/jd.md
必须使用 read_file 工具读取该文件。| OpenCode | Spring AI Alibaba |
|---|---|
SkillTool | read_skill |
ReadTool | 自定义 read_file |
SystemPrompt.skills() | SpringAiSkillAdvisor |
BashTool | ShellToolAgentHook |
| Skill 注册表 | ClasspathSkillRegistry |
Tool Registry在统一的工具表汇总,不会执行ts函数
Slash命令
手动模式:用户输入 /resume-check ↓系统直接找到对应 Skill ↓将 Skill 正文作为 Prompt 模板注入仅输入skill的正文加载到系统提示词,附属文件需要普通工具读取
Runtime
claudecode
安装
npm install -g @anthropic-ai/claude-codeclaude --versioncommand
- Skill 没有独立的数据类型,而是
Command体系中的PromptCommand - Skill ⊂ PromptCommand ⊂ Command
Command├── 普通命令:/help、/clear├── PromptCommand:Skill├── WorkflowCommand└── PluginCommand多行并行加载,统一成command[],进入统一命令注册表。Promise.all() 降低启动延迟,memoize(cwd) 缓存避免同一目录重复扫描
注册
根据上下文预算进行降级
预算充足:名字 + 完整描述预算紧张:内置 Skill 完整,其他描述截断预算极低:内置 Skill 保留描述,其他只显示名字控制上下文
Skill 有两种触发入口:
- 用户通过
/skill-name args显式调用 - 模型通过
SkillTool主动调用
模型或用户选择 Skill → 找到对应的 PromptCommand → 完成调用验证与权限检查 → 读取 command.context ├─ 未设置或 inline:展开 Prompt,放入主对话执行 └─ fork:启动独立子 Agent,在其上下文中运行 Skill → 将最终结果返回主对话加载时:多源并行 + 缓存 ↓注册时:只暴露 Skill 名称和有限描述 ↓选择时:由模型根据描述按需调用 ↓执行时:完整 Prompt 延迟加载 ↓复杂任务:Fork 到独立上下文 ↓主对话:只保留必要信息或最终结果Harness自进化
AgentScope
依赖
| 对比维度 | AgentScope Java | Spring AI Alibaba |
|---|---|---|
| 核心理念 | Agentic,自主型 Agent | Workflow,流程型 AI 应用 |
| 主要能力 | ReAct、工具调用、多 Agent 协作 | Graph 编排、状态管理、Checkpoint、人机协同 |
| 适合场景 | Agent 自主规划、自主决策、动态调用工具 | 流程固定、节点明确、强调可控性的业务流程 |
| 技术定位 | 面向 Agent 的独立开发框架 | Spring AI 生态的扩展 |
| 生态优势 | 阿里自研、路线和服务更自主 | Spring 生态集成更加自然 |
| 典型选择 | 自主型 Agent | Workflow 型 AI 应用 |
<dependency> <groupId>io.agentscope</groupId> <artifactId>agentscope</artifactId> <version>1.0.12</version></dependency>
<dependency> <groupId>io.agentscope</groupId> <artifactId>agentscope-spring-boot-starter</artifactId> <version>1.0.12</version></dependency>
调用Tool
创建 Toolkit ↓注册 SimpleTools ↓配置 DashScopeChatModel ↓创建 ReActAgent ↓封装用户消息 Msg ↓调用 jarvis.call(msg) ↓Agent 判断是否需要调用工具 ↓调用 get_time 工具 ↓获得工具结果 ↓Agent 生成最终回答// 工具类class SimpleTools { @Tool(name = "get_time", description = "获取当前时间") public String getTime( @ToolParam(name = "zone", description = "时区,例如:北京") String zone) { return java.time.LocalDateTime.now() .format(java.time.format.DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss")); }
public class AgentScopeHelloWorld {
public static void main(String[] args) { // 准备工具 Toolkit toolkit = new Toolkit(); toolkit.registerTool(new SimpleTools());
// 创建智能体 ReActAgent jarvis = ReActAgent.builder() .name("Jarvis") .sysPrompt("你是一个名为 Jarvis 的助手") .model(DashScopeChatModel.builder() .apiKey("sk-your-dashscope-api-key-here") .modelName("qwen3-max") .build()) .toolkit(toolkit) .build();
// 发送消息 Msg msg = Msg.builder() .textContent("你好!Jarvis,现在几点了?") .build();
Msg response = jarvis.call(msg).block(); System.out.println(response.getTextContent()); }}| API | 作用 |
|---|---|
Toolkit | 管理工具,并将工具注册给 Agent |
@Tool | 声明一个可以被 Agent 调用的方法 |
@ToolParam | 描述工具参数,帮助模型理解参数用途 |
ReActAgent | 基于 ReAct 范式运行的智能体 |
Msg | 封装用户消息、Agent 消息和工具消息 |
DashScopeChatModel | 对接阿里云百炼大模型 |
jarvis.call(msg) | 向 Agent 发起一次调用 |
.block() | 将响应式异步调用转换为同步等待 |
流式输出
Agent.stream(Msg, StreamOptions) — 流式调用入口,返回 Flux
StreamOptions — 流式配置项(事件类型过滤、增量/累积模式等)
Event — 流式事件对象,包含类型、消息内容、是否为最后一条
- EventType — 事件类型枚举:ALL、REASONING、TOOL_RESULT、SUMMARY、AGENT_RESULT、HINT
- REASONING:ReactAgent 的”思考和规划”阶段产生的事件。模型决定下一步行动之前的推理输出。(包含TOOL_USE工具入参)
- TOOL_RESULT:Agent 调用工具(Acting 阶段)执行完成后产生的事件,包含工具的返回结果。
- SUMMARY:当 Agent 达到最大迭代次数(maxIters)仍未完成任务时,框架会强制进入总结阶段,让模型总结当前已完成的工作。这个阶段产生的事件就是 SUMMARY。
- AGENT_RESULT:Agent 整个 call() 调用的最终返回结果相当于 agent.call(msg).block() 的返回值以事件形式
- HINT:来自 RAG(检索增强生成)、Memory(记忆系统)或 Planning(规划系统)的上下文信息注入事件。这些信息不是模型生成的,而是框架在推理之前主动注入的辅助信息。
- ALL:特殊值,表示接收所有类型的事件(但默认仍不包含 AGENT_RESULT)
@GetMapping(path = "/chat", produces = MediaType.TEXT_EVENT_STREAM_VALUE) public Flux<String> chat( @RequestParam String message, HttpServletResponse httpServletResponse) { httpServletResponse.setCharacterEncoding("UTF-8");
Toolkit toolkit = new Toolkit(); toolkit.registerTool(new SimpleTools());
// 创建 Agent,注意 model 需要 stream(true) ReActAgent agent = ReActAgent.builder() .name("WebAgent").toolkit(toolkit) .model(DashScopeChatModel.builder() .apiKey(apiKey) .modelName("qwen-plus") .stream(true) // 开启模型级流式 .build()) .build();
// 构建用户消息 Msg userMsg = Msg.builder().textContent(message).build();
// 配置流式选项 — 增量模式 StreamOptions streamOptions = StreamOptions.builder() // 选择要接收的事件类型 .eventTypes(EventType.REASONING, EventType.TOOL_RESULT) // true = 增量模式(只发送新增内容),false = 累积模式(每次发送全部已累积内容) .incremental(true) // 是否包含最终推理结果(把流式输出的内容拼在一起一次性返回) .includeReasoningResult(false) .build();
// 调用 stream() 获取事件流 return agent.stream(userMsg, streamOptions) //接受事件 .subscribeOn(Schedulers.boundedElastic()) //只输出textcontent不为空的结果 .map(event -> event.getMessage().getTextContent()) //json结果 .map方法为类型转换 .map(event -> JSON.toJSONString(event.getMessage())) .filter(text -> text != null && !text.isEmpty()); }}结构化输出
agent.call(Msg, Class
- agent.stream(msgs, options, Class
) — 流式模式下的结构化输出 - msg.getStructuredData(Class
) — 从返回消息中提取结构化对象 - 通过 StructuredOutputHook + generate_response工具模式实现自动纠错—如果模型第一次没有按格式输出,框架会自动重试并引导模型调用指定工具
//创建联系人信息实体类 public static class ContactInfo { public String name; public String email; public String phone; public String company; }}
@RestController@RequestMapping("/structured")public class StructuredOutputController {
private final String apiKey = ""; @GetMapping("/chat") public String chat() { // 创建 Agent ReActAgent agent = ReActAgent.builder().name("AnalysisAgent").sysPrompt("You are an intelligent analysis assistant. " + "Analyze user requests and provide structured responses.").model(DashScopeChatModel.builder().apiKey(apiKey).modelName("qwen-max").build()).build();
// 提取联系人信息 ContactInfo contactInfo = extractContactInfo(agent); System.out.println("Name: " + contactInfo.name); System.out.println("Email: " + contactInfo.email); System.out.println("Phone: " + contactInfo.phone); System.out.println("Company: " + contactInfo.company); return JSON.toJSONString(contactInfo); }
private static ContactInfo extractContactInfo(ReActAgent agent) { Msg userMsg = Msg.builder().role(MsgRole.USER).content(TextBlock.builder().text("Extract contact info: Please contact Hollis at hollischuang@qq.com, " + "phone +1-555-1234, company SuperHollis.").build()).build();
Msg result = agent.call(userMsg, ContactInfo.class).block(); return result.getStructuredData(ContactInfo.class); }超时重试
定义一个ExecutionConfig控制模型和工具思考与重试传给Agent
@GetMapping("/chat") public String chat() { // 给模型调用设置更短的超时和更多重试 ExecutionConfig modelConfig = ExecutionConfig.builder() .timeout(Duration.ofSeconds(30)) // 单次请求超时30秒 .maxAttempts(5) // 最多尝试5次(1次初始 + 4次重试) .initialBackoff(Duration.ofSeconds(1)) // 首次重试等1秒 .maxBackoff(Duration.ofSeconds(15)) // 退避上限15秒 .backoffMultiplier(2.0) // 指数退避:1s -> 2s -> 4s -> 8s -> 15s .retryOn(ExecutionConfig.RETRYABLE_ERRORS) // 使用默认可重试条件 .build();
// 给工具调用设置更长的超时(某些工具耗时较长) ExecutionConfig toolConfig = ExecutionConfig.builder() .timeout(Duration.ofMinutes(10)) // 工具执行最多等10分钟 .maxAttempts(2) // 最多重试1次 .initialBackoff(Duration.ofSeconds(3)) .retryOn(error -> error instanceof java.io.IOException) // 仅网络错误时重试 .build();
// === 构建 Agent,分别指定模型和工具的执行配置 === ReActAgent agent = ReActAgent.builder() .name("RobustAgent") .sysPrompt("You are a reliable assistant.") .model(DashScopeChatModel.builder() .apiKey(apiKey) .modelName("qwen-plus") .stream(true) .build()) .modelExecutionConfig(modelConfig) // 模型调用的超时重试 .toolExecutionConfig(toolConfig) // 工具调用的超时重试 .build();
Msg msg = Msg.builder() .textContent("你是谁,现在几点了?") .build();
return Objects.requireNonNull(agent.call(msg).block()).getTextContent(); }执行控制
迭代次数
控制 ReAct 循环(Reasoning → Acting → Reasoning → …)的最大轮次。达到上限后自动进入 Summary 阶段生成总结
ReActAgent agent = ReActAgent.builder() .name("BoundedAgent") .sysPrompt("You are a helpful assistant.") .model(model) .maxIters(5) // 最多5轮 Reasoning-Acting 循环,默认值为10 .build();安全中断
用户可以在任意时刻中断会话,保留上下文和未完成的工具调用
中断源**
- USER — 用户主动中断(如点击”停止”按钮)
- TOOL — 工具执行逻辑触发中断(如工具检测到需要人工确认)
- SYSTEM — 系统触发(超时、资源限制、优雅关机等)
定义Agent添加内存记忆和工具
ReActAgent agent = ReActAgent.builder() .name("DataAgent") .sysPrompt("You are a data processing assistant. " + "Use the process_large_dataset tool to process datasets.") .model(DashScopeChatModel.builder() .apiKey(apiKey).modelName("qwen-max").stream(false).build()) .toolkit(toolkit) .memory(new InMemoryMemory()) .maxIters(10) .build();指定角色构造请求.role().content(TextBlock.builder()).build()
// 用户请求 Msg userMsg = Msg.builder() .role(MsgRole.USER) .content(TextBlock.builder() .text("Process the 'orders' dataset with 'aggregate' operation.") .build()) .build();单独线程启用Agent,中断后agent.interrupt(定义的中断消息类似UserMessage)
// 在单独线程启动 Agent Thread agentThread = new Thread(() -> { Msg response = agent.call(userMsg).block(); System.out.println("[Agent] " + response.getTextContent()); }); agentThread.start();
// 等 2 秒后中断 Agent Thread.sleep(2000); System.out.println(">>> USER INTERRUPTS <<<");
// 携带中断消息(可选) Msg interruptMsg = Msg.builder() .role(MsgRole.USER) .content(TextBlock.builder() .text("Stop! I need to change parameters.") .build()) .build(); agent.interrupt(interruptMsg);
agentThread.join(); System.out.println("Memory size: " + agent.getMemory().getMessages().size()); }关机保留
适用于服务器部署场景(如 Spring Boot 应用收到kill -15)。系统会等待当前正在执行的 Agent 请求完成或达到超时后安全终止,并自动保存会话状态
// 配置优雅关机策略GracefulShutdownConfig config = new GracefulShutdownConfig( Duration.ofSeconds(30), // 关机超时:最多等30秒 PartialReasoningPolicy.SAVE // 未完成的推理结果:保存到Session // 另一个选项: PartialReasoningPolicy.DISCARD 丢弃不完整结果);
GracefulShutdownManager.getInstance().setConfig(config)关机时的安全检查点
- PostReasoningEvent — 推理完成后
- PostActingEvent — 工具执行完成后
- PostSummaryEvent — 总结生成完成后
@Configurationpublic class AgentShutdownConfig {
@Bean public GracefulShutdownManager shutdownManager() { GracefulShutdownManager manager = GracefulShutdownManager.getInstance(); manager.setConfig(new GracefulShutdownConfig( Duration.ofSeconds(30), PartialReasoningPolicy.SAVE )); return manager; }
@PreDestroy public void onShutdown() { GracefulShutdownManager manager = GracefulShutdownManager.getInstance();
// 触发优雅关机 manager.performGracefulShutdown();
// 等待所有请求完成或超时 boolean terminated = manager.awaitTermination(Duration.ofSeconds(35)); if (terminated) { System.out.println("All agent requests completed gracefully."); } else { System.out.println("Shutdown timed out, some requests were force-interrupted."); } }}通过实现 Hook 接口在 Agent 生命周期的各个阶段插入自定义逻辑,包括阻止工具执行、修改输入、记录日志
public class ExecutionMonitorHook implements Hook {
@Override public <T extends HookEvent> Mono<T> onEvent(T event) { if (event instanceof PreCallEvent pre) { System.out.println("[Monitor] Agent call started");
} else if (event instanceof PreActingEvent preAct) { // 可以在这里拦截工具调用! String toolName = preAct.getToolUse().getName(); System.out.println("[Monitor] About to call tool: " + toolName); // 例如:拦截危险工具 // preAct.skipTool("Operation not permitted");
} else if (event instanceof PostActingEvent postAct) { System.out.println("[Monitor] Tool completed: " + postAct.getToolUse().getName());
} else if (event instanceof PostCallEvent post) { System.out.println("[Monitor] Agent call finished");
} else if (event instanceof ErrorEvent err) { System.err.println("[Monitor] Error: " + err.getError().getMessage()); }
return Mono.just(event); }
@Override public int priority() { return 100; // 数字越小优先级越高 }}
// 注册到 AgentReActAgent agent = ReActAgent.builder() .name("MonitoredAgent") .model(model) .hooks(List.of(new ExecutionMonitorHook())) .build();多轮会话
Memory
Memory(短期会话记忆)负责维护当前对话上下文基于内存
- 将用户消息加入 Memory(addToMemory(msgs))
- 构造完整消息列表传给 LLM(System Prompt + 历史消息 + 当前输入)
- 将 LLM 的回复也加入 Memory
- 如果触发工具调用,工具结果同样加入 Memory
- 循环直到 LLM 决定结束(无工具调用或达到 maxIters)
持续累积历史消息,内存记忆InMemoryMemory,基于 CopyOnWriteArrayList 实现线程安全的消息存储。
public interface Memory extends StateModule { void addMessage(Msg message); // 添加消息 List<Msg> getMessages(); // 获取全部历史消息 void deleteMessage(int index); // 删除指定位置消息 void clear(); // 清空所有消息}定义一个InMemoryMemory对象传到Agent里面
public class MultiTurnChatDemo {
public static void main(String[] args) { String apiKey = "";
// 创建 Memory(负责维护会话历史) InMemoryMemory memory = new InMemoryMemory();
// 创建 Agent ReActAgent agent = ReActAgent.builder() .name("Assistant") .sysPrompt("You are a helpful AI assistant. Remember what the user tells you.") .model(DashScopeChatModel.builder() .apiKey(apiKey) .modelName("qwen-max") .build()) .memory(memory) // 注入 Memory .build();
// === 第1轮 === Msg msg1 = Msg.builder() .role(MsgRole.USER) .content(TextBlock.builder().text("My name is Hollis and I'm a software engineer.").build()) .build(); Msg reply1 = agent.call(msg1).block(); System.out.println("Agent: " + reply1.getTextContent());
// === 第2轮(Agent 能记住第1轮信息)=== Msg msg2 = Msg.builder() .role(MsgRole.USER) .content(TextBlock.builder().text("What's my name and what do I do?").build()) .build(); Msg reply2 = agent.call(msg2).block(); System.out.println("Agent: " + reply2.getTextContent()); // Agent 会回答: "Your name is Hollis and you're a software engineer."
// 查看 Memory 中的完整对话历史 System.out.println("Total messages in memory: " + memory.getMessages().size()); // 输出: 4(user1 + assistant1 + user2 + assistant2) }}Session
Session(会话持久化)负责将状态保存/恢复到外部存储,Session接口有很多存储的实现类
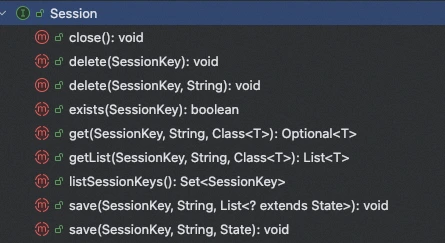
创建InMemoryMemory对象引入到Agent
Json持久化记忆首先创建Paths.get()存储json,创建Session的Json的实现类
- agent.loadIfExists(session,sessionId)加载历史对话,发送新消息
- agent.saveTo(session,sessionId)保存会话,下次可恢复对话
public class PersistentChatDemo {
public static void main(String[] args) { String apiKey = ""; String sessionId = "user_hollis_session";
// 1. 创建 Session(JSON文件持久化) Path sessionPath = Paths.get(System.getProperty("user.home"), ".agentscope", "examples", "sessions");
//接口多态(编译左边运行右边) Session session = new JsonSession(sessionPath);
// 2. 创建 Agent 组件 InMemoryMemory memory = new InMemoryMemory();
ReActAgent agent = ReActAgent.builder() .name("Assistant") .sysPrompt("You are a helpful AI assistant with persistent memory. ") .model(DashScopeChatModel.builder() .apiKey(apiKey) .modelName("qwen-max") .build()) .memory(memory) .build();
// 3. 如果之前有保存的会话,加载它(恢复历史上下文) boolean resumed = agent.loadIfExists(session, sessionId); if (resumed) { System.out.println("Session restored! " + memory.getMessages().size() + " messages loaded."); } else { System.out.println("New session started."); }
// 4. 发送新消息(延续之前的对话上下文) Msg userMsg = Msg.builder() .role(MsgRole.USER) .content(TextBlock.builder().text("My name is Hollis and I'm a software engineer.").build()) .build();
Msg response = agent.call(userMsg).block(); System.out.println("Agent: " + response.getTextContent());
// 5. 保存会话(下次启动时可恢复) agent.saveTo(session, sessionId); System.out.println("Session saved. Messages in memory: " + memory.getMessages().size()); }}~/.agentscope/sessions/ # 默认存储目录(可自定义) └── user_hollis_session/ # 每个 SessionKey 一个子目录 ├── agent_meta.json # Agent 元数据 ├── memory_messages.jsonl # 消息列表(JSONL 格式,增量追加) ├── memory_messages.hash # hash 文件(变更检测,避免不必要的全量重写) └── toolkit_activeGroups.json # Toolkit 状态精细控制
- StatePersistence——精细控制持久化范围
- 默认情况下 Agent 的 saveTo/loadFrom 会自动管理所有组件。如果你想自己管理某些组件的状态,可以通过 StatePersistence 配置
// 默认:管理所有组件ReActAgent agent1 = ReActAgent.builder() .name("assistant") .model(model) .memory(memory) .build(); // statePersistence 默认 = StatePersistence.all()
// 只管理 Memory(Toolkit 和 PlanNotebook 由用户自行管理)ReActAgent agent2 = ReActAgent.builder() .name("assistant") .model(model) .memory(memory) .statePersistence(StatePersistence.memoryOnly()) .build();
// 完全不管理(用户自行管理所有状态)ReActAgent agent3 = ReActAgent.builder() .name("assistant") .model(model) .statePersistence(StatePersistence.none()) .build();
// 自定义:管理 Memory 和 Toolkit,但不管理 PlanNotebookReActAgent agent4 = ReActAgent.builder() .name("assistant") .model(model) .memory(memory) .statePersistence(StatePersistence.builder() .memoryManaged(true) .toolkitManaged(true) .planNotebookManaged(false) .statefulToolsManaged(false) .build()) .build();StatePersistence中包含四个组件
- Memory(对话记忆)所有消息列表(用户输入、LLM 回复、工具调用结果等
- Toolkit(工具集)ToolKnit支持工具分组通过activeGroups控制工具激活状态
- PlanNoteBook知道任务是否完成,继续未完成的计划
- StatefulTools(有状态工具)Agent知道工具自身的内部状态
区别
SpringAlibaba中状态 ≈ 消息列表
Memory 的 addMessage()
- 同步写 → 严重拖慢 Agent 响应
- 异步写 → 中间状态不一致(Agent 还在推理中,你保存了半截状态)
- 批量缓冲写 → 在 Memory 里引入复杂的 buffer/flush 逻辑,职责不纯
AgentScope中包含Memory 只管内存中的快速读写,Session 的保存时机完全由开发者决定
- 消息历史(Memory)
- 当前激活的工具组(Toolkit activeGroups)
- 多步计划的执行进度(PlanNotebook)
- 有状态工具的内部数据(StatefulTools)
- Agent 元数据(sysPrompt 可能被动态修改)
GracefulShutdown 自动保存——agent.loadIfExists() 会自动绑定 Session 到 ShutdownManager,JVM 关闭时自动 saveTo
长期记忆
接口
SpringAlibaba支持接入Memo0,AgentScope提供了长期记忆的接口
public interface LongTermMemory { Mono<Void> record(List<Msg> msgs); // 记录:从消息中提取知识并存储 Mono<String> retrieve(Msg msg); // 检索:根据查询语义返回相关记忆文本}- 有三个实现类BailianLongTermMemory、Mem0LongTermMemory和ReMeLongTermMemory。
- 指定userId实现用户隔离,短期记忆使用ChatId
BailianLongTermMemory.builder() .apiKey(System.getenv("DASHSCOPE_API_KEY")) // 阿里云 DashScope Key .userId("user_001") // 必填 .memoryLibraryId("lib_xxx") // 记忆库 ID .projectId("proj_xxx") // 项目 ID .profileSchema("schema_xxx") // 用户画像 schema .topK(10) .minScore(0.5) // 提高阈值,只要高相关结果 .enableRerank(true) // 启用重排序 .enableJudge(true) // 启用 LLM 判断 .enableRewrite(true) // 启用查询改写 .metadata(Map.of("source", "mobile-app")) .build();Mem0LongTermMemory.builder() .agentName("Assistant") // 内部映射为 agentId(可选) .userId("user_123") // 用户隔离(核心维度) .runId("session_456") // 单次会话隔离(可选) .apiBaseUrl("https://api.mem0.ai") // PLATFORM默认地址 .apiKey(System.getenv("MEM0_API_KEY")) // 平台模式必填 .apiType(Mem0ApiType.PLATFORM) // 或 SELF_HOSTED .metadata(Map.of("category", "travel", "lang", "zh")) .build();eMeLongTermMemory.builder() .userId("task_workspace") // 必填,映射为 workspaceId .apiBaseUrl("http://localhost:8002")// ReMe服务地址 .timeout(Duration.ofSeconds(120)) // 可选,HTTP 超时 .build();记忆模式
LongTermMemoryMode解决了何时需要记忆,谁来记忆
public enum LongTermMemoryMode { AGENT_CONTROL, // Agent 自己决定何时记录/检索(注册为工具) STATIC_CONTROL, // 框架自动管理(每轮自动检索+记录) BOTH // 两者结合(推荐)}AgentControl模式
由 LongTermMemoryTools 实现,框架向 Toolkit 注册两个工具
Agent 通过 Function Calling 决定何时记忆/回忆
- recordToMemory(thinking, content) — Agent 主动调用记录关键信息
- retrieveFromMemory(keywords) — Agent 主动按关键词检索
STATICCONTROL 模式
由StaticLongTermMemoryHook 实现
- PreCallEvent(推理前):取出最后一条用户消息 → 调用 retrieve() → 用 <long_term_memory>…</long_term_memory> 标签包装结果 → 作为 USER role 消息(name=“long_term_memory”)追加到输入消息末尾
- PostCallEvent(回复后):把 Memory 中所有消息传给 record() → 由后端(如 Mem0)自动提取关键信息并向量化存储
异步记录:可选 asyncRecord=true,使用专用的 boundedElastic scheduler(1 worker,队列 3),避免阻塞响应。
public class BailianLongTermMemoryDemo { public static void main(String[] args) { // 1. 配置 bailian 长期记忆 BailianLongTermMemory longTermMemory = BailianLongTermMemory.builder() .userId("hollis666") // 关键:每个用户一个隔离的记忆空间 .apiKey("") .memoryLibraryId("") .build();
// 2. 创建 Agent,启用 STATIC_CONTROL 模式 ReActAgent agent = ReActAgent.builder() .name("Assistant") .model(DashScopeChatModel.builder() .apiKey("") .modelName("qwen-plus") .build()) .longTermMemory(longTermMemory) .longTermMemoryMode(LongTermMemoryMode.STATIC_CONTROL) .build();
// 3. 模拟首次对话:告诉 Agent 一些用户偏好 Msg userMsg = Msg.builder() .role(MsgRole.USER) .content(TextBlock.builder().text("我是Hollis,我不喜欢吃香菜,我爱吃辣的").build()) .build();
Msg reply1 = agent.call(userMsg).block(); System.out.println("Agent: " + reply1.getTextContent());
// ===模拟 JVM 重启后的情况——>新建 Agent 实例(短期记忆全空)=== // 但只要 userId 一致,长期记忆中的偏好仍可被检索到
BailianLongTermMemory longTermMemory2 = BailianLongTermMemory.builder() .userId("hollis666") // 同样的 userId .apiKey("sk-dcebc45c03b04c6e85391abb2264e594") .memoryLibraryId("8553b56bbeb9451295e49a09d8c26ee3") .build();
ReActAgent agent2 = ReActAgent.builder() .name("Assistant") .model(DashScopeChatModel.builder() .apiKey("sk-dcebc45c03b04c6e85391abb2264e594") .modelName("qwen-plus") .build()) .longTermMemory(longTermMemory2) .longTermMemoryMode(LongTermMemoryMode.STATIC_CONTROL) .build();
// 提问 - Agent 会自动检索到之前的过敏信息
Msg userMsg1 = Msg.builder() .role(MsgRole.USER) .content(TextBlock.builder().text("我来杭州了,请帮我推荐几个餐馆吧").build()) .build(); Msg reply3 = agent2.call(userMsg1).block(); System.out.println("Agent: " + reply3.getTextContent()); }}自定义
重写record和retrieve方法
public class CustomLongTermMemory implements LongTermMemory {
private final VectorStore vectorStore; // 你的向量库(如 Milvus/PGVector) private final EmbeddingModel embedder; // 嵌入模型 private final ChatModel summarizer; // 用于知识抽取的 LLM private final String userId;
@Override public Mono<Void> record(List<Msg> msgs) { // 1. 用 LLM 从消息中抽取关键事实 return summarizer.extract(msgs, "Extract user preferences, facts, and decisions.") // 2. 向量化 .flatMap(facts -> embedder.embed(facts)) // 3. 存入向量库(带 userId 标签) .flatMap(vector -> vectorStore.save(userId, vector)); }
@Override public Mono<String> retrieve(Msg query) { // 1. 查询向量化 return embedder.embed(query.getTextContent()) // 2. 向量检索 Top-K(带 userId 过滤) .flatMap(qvec -> vectorStore.search(userId, qvec, 5)) // 3. 拼接为文本返回 .map(results -> String.join("\n", results)); }}上下文压缩
初识
用来解决多轮对话token爆炸,上下文溢出
AutoContextMemory实现了Memory接口把原始内容卸载到外部存储(可通过 ID 重新加载)
触发压缩的条件
// 消息数量超过 msgThreshold,默认 100 条boolean msgCountReached = messages.size() >= msgThreshold;// Token 数量超过 模型最大上下文 × tokenRatio ,默认 128k * 0.75 = 96kboolean tokenCountReached = tokens >= maxToken * tokenRatio;利用模型回答前判断是否满足压缩条件
Agent 准备调用模型 │ ▼PreReasoningHook │ ▼AutoContextMemory.compressIfNeeded() │ ├─ 消息数是否 >= 100? ├─ Token 是否 >= 模型窗口 × 0.75? │ └─ 任一满足,进入压缩 │ ▼ 依次尝试策略 1 → 6 ├─ 某个策略成功 │ ├─ 更新 working memory │ ├─ 原文写入 offloadContext │ ├─ 记录压缩事件和 token 用量 │ └─ 立即停止,不再执行后续策略 │ └─ 全部失败 └─ 保持当前上下文六大策略
- 压缩历史工具链,保留最终回答
处理的是已经被Agent消费的工具消息assistant: tool_use(search, query=...)tool: 大量搜索结果原消息保存到 offloadContext,通过LLM生成摘要将n条消息转换为一条摘要
if (!messageThresholdReached && !tokenThresholdReached) { return false;}if (compressPreviousToolMessages()) return true;- 卸载大消息
不是语义压缩而是存储层面的搬运
原始大消息 1.完整内容 → offloadContext[uuid]2.working memory 中替换为:前 200 字预览<context_offload uuid="..."/>
if (offloadLargePayloadWithRecentProtection()) return true;if (offloadLargePayloadWithoutRecentProtection()) return true;- 压缩历史轮次,压缩最终结果
//压缩前user: 用户问题assistant: 工具调用tool: 工具结果assistant: 最终回答//压缩后user: 用户问题assistant: 自包含的事实性摘要 + offload UUID将工具结果转化为已知事实
if (summarizePreviousRounds()) return true;- 当前轮最大消息
定位最近一条 user 消息 ↓倒序扫描其后的消息 ↓跳过已经压缩过的消息 ↓找到超过 5KB 的消息 ↓卸载原文 ↓LLM 保守摘要 ↓按原类型重建消息结构
if (summarizeCurrentRoundLargeMessages()) return true;- 当前轮整体压缩
给出约 30% 的明确目标,保留旧摘要,增加新的工具调用
当前轮全部消息 ↓计算总字符数 X ↓目标字符数 Y = X × 0.3 ↓卸载原始当前轮 ↓LLM 按目标长度整合工具交互 ↓生成新的压缩上下文 ↓追加新的 offload UUID
if (summarizeCurrentRound()) return true;触发检测
-
判断 token 来自哪里
-
优先压缩历史工具过程
-
再卸载历史大消息
-
再摘要历史轮次
-
必要时压缩当前轮
-
保存原文并留下 UUID
-
未来按需重新加载
卸载恢复
原始消息 │ ▼offload(uuid, messages) │ ├─ offloadContext[uuid] = 原始消息列表 │ └─ working memory = 摘要/预览 + UUID 标签 │ ▼ Agent 需要更多细节 │ ▼ context_offload(uuid) │ ▼ memory.reload(uuid) │ ▼ 返回原始消息- working memory 类似高速内存,只保留当前推理需要的内容;
- offloadContext 类似低速后备存储,保留完整原文;
- UUID 类似页地址;
context_offload工具负责按需换入。
记忆体系
- AutoContextMemory其实是Memory的实现类可以引入Agent
- 定义一个AutoContextConfig参数最近消息条数短期记忆并自带压缩
- 通过.memory(AutoContextMemory对象(config,Model用于生成摘要))
- AutoContextMemory中的compressIfNeeded是需要通过一个Hook来调用执行,LLM每次推理前
public static void main(String[] args) { //指定上下文压缩中生成摘要的模型 DashScopeChatModel chatModel = DashScopeChatModel.builder() .apiKey("sk-dcebc45c03b04c6e85391abb2264e594") .modelName("qwen3-max") .stream(true) .enableThinking(true) .formatter(new DashScopeChatFormatter()) .defaultOptions(GenerateOptions.builder().thinkingBudget(1024).build()) .build();
// 1. 长期记忆:跨会话语义检索 BailianLongTermMemory longTermMemory = BailianLongTermMemory.builder() .userId("hollis666") // 关键:每个用户一个隔离的记忆空间 .apiKey("") .memoryLibraryId("") .build();
// 2. 短期记忆:AutoContextMemory(自动上下文压缩) // 当短期消息超过 token 上限时,自动总结早期消息以节省 token AutoContextConfig autoContextConfig = AutoContextConfig.builder() .tokenRatio(0.1) // 触发压缩的阈值比例 .lastKeep(20) // 最近保留的消息数 .build(); AutoContextMemory memory = new AutoContextMemory(autoContextConfig, chatModel);
// 3. 工具集 Toolkit toolkit = new Toolkit(); toolkit.registerTool(new ReadFileTool()); toolkit.registerTool(new WriteFileTool());
// 4. 完整 Agent 配置 ReActAgent agent = ReActAgent.builder() .name("Assistant") .sysPrompt("You are a helpful AI assistant") .model(chatModel) .maxIters(50)//Agent最大重试轮数包括(思考,行动,总结) .longTermMemory(longTermMemory) .longTermMemoryMode(LongTermMemoryMode.STATIC_CONTROL) // 也可以用 BOTH .enablePlan() // 启用计划模块 .toolkit(toolkit) .memory(memory) //引入AutoContextMemory(config,Model)对象 .hook(new AutoContextHook()) // 自动上下文压缩 Hook用于条件判断llm推理前 .build();
// 5. Session 持久化 String sessionId = "user_hollis_session"; //持久化存储路径 Path sessionPath = Paths.get(System.getProperty("user.home"), ".agentscope", "examples", "sessions"); Session session = new JsonSession(sessionPath);
agent.loadIfExists(session, sessionId); // 恢复短期记忆
// 6. 多轮交互循环 try { // ...用户输入循环... Msg userMsg = Msg.builder() .role(MsgRole.USER) .content(TextBlock.builder().text("...").build()) .build(); Msg response = agent.call(userMsg).block(); agent.saveTo(session, sessionId); // 保存短期记忆 + 工具状态
} catch (Throwable e) { agent.saveTo(session, sessionId); // 异常时也保存 } }}用户输入 ↓ ┌──────────────────┐ │AutoContextMemory │ ← 短期记忆(带自动压缩) │ 最近 20 条原文 + │ 超长后早期消息会被 LLM 总结 │ 早期对话摘要 │ └──────────────────┘ ↓ ┌──────────────────┐ │ JsonSession │ ← 会话持久化(跨重启) │ 序列化到磁盘 │ 保存的是上面的短期记忆 └──────────────────┘ ↓ ┌──────────────────┐ │ Mem0LongTermMem │ ← 长期记忆(跨会话语义检索) │ 向量化提取的事实 │ 每轮自动写入,每轮自动召回 └──────────────────┘Hook
接口
Hook就是一个事件拦截器贯穿于推理,行动,总结,Hook是一个接口
- priority决定事件优先级,return数字小代表事件先执行
- OnEvent是事件的统一入口,
传入什么事件返回什么类型,Hook可以修改事件内容但不能修改文件类型 ,返回Mono 支持异步操作 - PreCallEvent → Mono
PostCallEvent → Mono
public interface Hook { <T extends HookEvent> Mono<T> onEvent(T event); default int priority() { return 100; }}HookEvent是所有事件基类
public abstract sealed class HookEvent 封闭类 permits PreCallEvent, PostCallEvent, ReasoningEvent, ActingEvent, SummaryEvent, ErrorEvent { 只有这些类可以继承HookEvent
private final HookEventType type; //Hook需要执行操作的集合(枚举类,reason,action事件前后) private final Agent agent; private final long timestamp;}切入点
HookEventType是所有事件的枚举
public enum HookEventType { PRE_CALL, // Agent 开始处理前 POST_CALL, // Agent 完成处理后 PRE_REASONING, // LLM 推理前 POST_REASONING, // LLM 推理完成后 REASONING_CHUNK,// 推理流式输出中 PRE_ACTING, // 工具执行前 POST_ACTING, // 工具执行完成后 ACTING_CHUNK, // 工具执行流式输出中 PRE_SUMMARY, // 总结生成前(达到最大迭代次数时) POST_SUMMARY, // 总结生成完成后 SUMMARY_CHUNK, // 总结流式输出中 ERROR // 发生错误时}| 事件类 | 时机 | 可修改? | 关键 Setter / 能力 |
|---|---|---|---|
PreCallEvent | agent.call() 开始 | Yes | setInputMessages setSystemMessage appendSystemContent |
PostCallEvent | agent.call() 结束 | Yes | setFinalMessage |
PreReasoningEvent | 每轮推理前 | Yes | setInputMessages setGenerateOptions appendSystemContent |
PostReasoningEvent | 推理完成 | Yes | setReasoningMessage stopAgent() gotoReasoning(msgs) |
ReasoningChunkEvent | 流式 Token 到达 | No | getIncrementalChunk() getAccumulated() |
PreActingEvent | 单个工具执行前 | Yes | setToolUse(ToolUseBlock) |
PostActingEvent | 单个工具执行后 | Yes | setToolResult stopAgent() |
ActingChunkEvent | 工具流式输出 | No | getChunk() |
PreSummaryEvent | 超过 maxIters,进入总结前 | Yes | setInputMessages setGenerateOptions |
PostSummaryEvent | 总结完成 | Yes | setSummaryMessage |
SummaryChunkEvent | 总结流式输出 | No | getIncrementalChunk() getAccumulated() |
ErrorEvent | 出错 | No | getError() |
PostReasoningEvent.stopAgent()
- 调用后 Agent 立即返回当前消息,不执行工具。
- 实现 human-in-the-loop:用户可以审查 LLM 打算调什么工具,确认后再 agent.call() 继续。
PostReasoningEvent.gotoReasoning(msgs)
- 跳过 acting 阶段,直接回到下一轮 reasoning
- StructuredOutputHook 发现 LLM 输出格式不对,构造一条 hint 消息塞进去要求重试。
- 内部有 ToolValidator.validateToolResultMatch 校验——如果原始推理里有 ToolUseBlock,你塞的 msgs 里必须包含对应的 ToolResult,否则抛异常。
PostActingEvent.stopAgent()
类似 PostReasoning 的 stop,但触发在工具执行之后。适合”执行完了先让人看看结果再继续”的场景。
管理Hook
- AgentBase是所有Agent的抽象基类,Hook的生命周期,CopyOnWriteArrayList 保存 Hook:
- ReactAgent两者管理事件类型不同
public abstract class AgentBase implements StateModule, Agent {
public AgentBase(String name, String description, boolean checkRunning, List<Hook> hooks) { this.agentId = UUID.randomUUID().toString(); this.name = name; this.description = description; this.checkRunning = checkRunning; this.hooks = new CopyOnWriteArrayList<>(hooks != null ? hooks : List.of()); this.hooks.addAll(systemHooks); sortHooks(); }
//获取注册的Hook列表 protected List<Hook> getSortedHooks() { return hooks; } // 动态添加 Hook protected void addHook(Hook hook) { ... } // 动态移除 Hook protected void removeHook(Hook hook) { ... } // 静态方法注册全局 Hook(对所有后续创建的 Agent 生效) public static void addSystemHook(Hook hook) { ... } public static void removeSystemHook(Hook hook) { ... }}AgentBase的作用
- 合并 Agent Hook 和系统 Hook。
- 按优先级排序。
- 动态添加或移除 Hook。
- 为调度过程提供排序后的 Hook 列表
this.hooks.addAll(systemHooks)系统 Hook 是在 Agent 创建时复制进实例列表的
已经创建的 Agent 是否同步变化,需要看 addSystemHook() 的完整实现,不能仅凭当前片段断定。
Hook调度
AgentBase
外层生命周期由 AgentBase 管理,ReAct 内部循环由 ReActAgent 管理
- 在AgentBase中,主要负责PreCall / PostCall / Error的调度
- 在ReActAgent中,主要负责 Reasoning / Acting / Summary的调度
AgentBase.call() // notifyPreCall(msgs) .flatMap(this::doCall)真正逻辑 ReActAgent 实现了 doCall() .flatMap(this::notifyPostCall) .onErrorResume(createErrorHandler(...))for (Hook hook : getSortedHooks()) { result = result.flatMap(hook::onEvent);}前置利用getSortedHooks获取所有的Hook,并执行OnEvent方法,不会过滤事件,Hook 必须自行判断是否关心该事件,所有事件都会被执行
- 后一个 Hook 可以看到前一个 Hook 的修改。
- 多个 Hook 修改同一字段时,后执行的 Hook 可能覆盖前面的结果。
- 任一 Hook 返回
Mono.error(),后续 Hook 和核心逻辑都不会继续执行
React
ReasoningChunkEvent的构造流程
- 识别增量内容类型
- 从上下文构建累计内容
- 广播给所有 Hook遍历执行OnEvent方法
return Flux.fromIterable(getSortedHooks()) .flatMap(hook -> hook.onEvent(event)) .then();Flux.flatMap() 允许 Hook 异步并发执行
| 事件类型 | 调度模型 | 原因 |
|---|---|---|
| Pre/Post 生命周期事件 | 串行管道 | 后一个 Hook 需要看到前一个 Hook 的修改 |
| Chunk 流式事件 | 并发广播 | 事件只读,重点是降低流式通知延迟 |
集成
ReActAgent agent = ReActAgent.builder() .name("Assistant") .model(model) .toolkit(toolkit) .hooks(List.of( new LoggingHook(), new HighPriorityHook(), new PromptEnhancingHook() )) .build();Streaming
内置hook
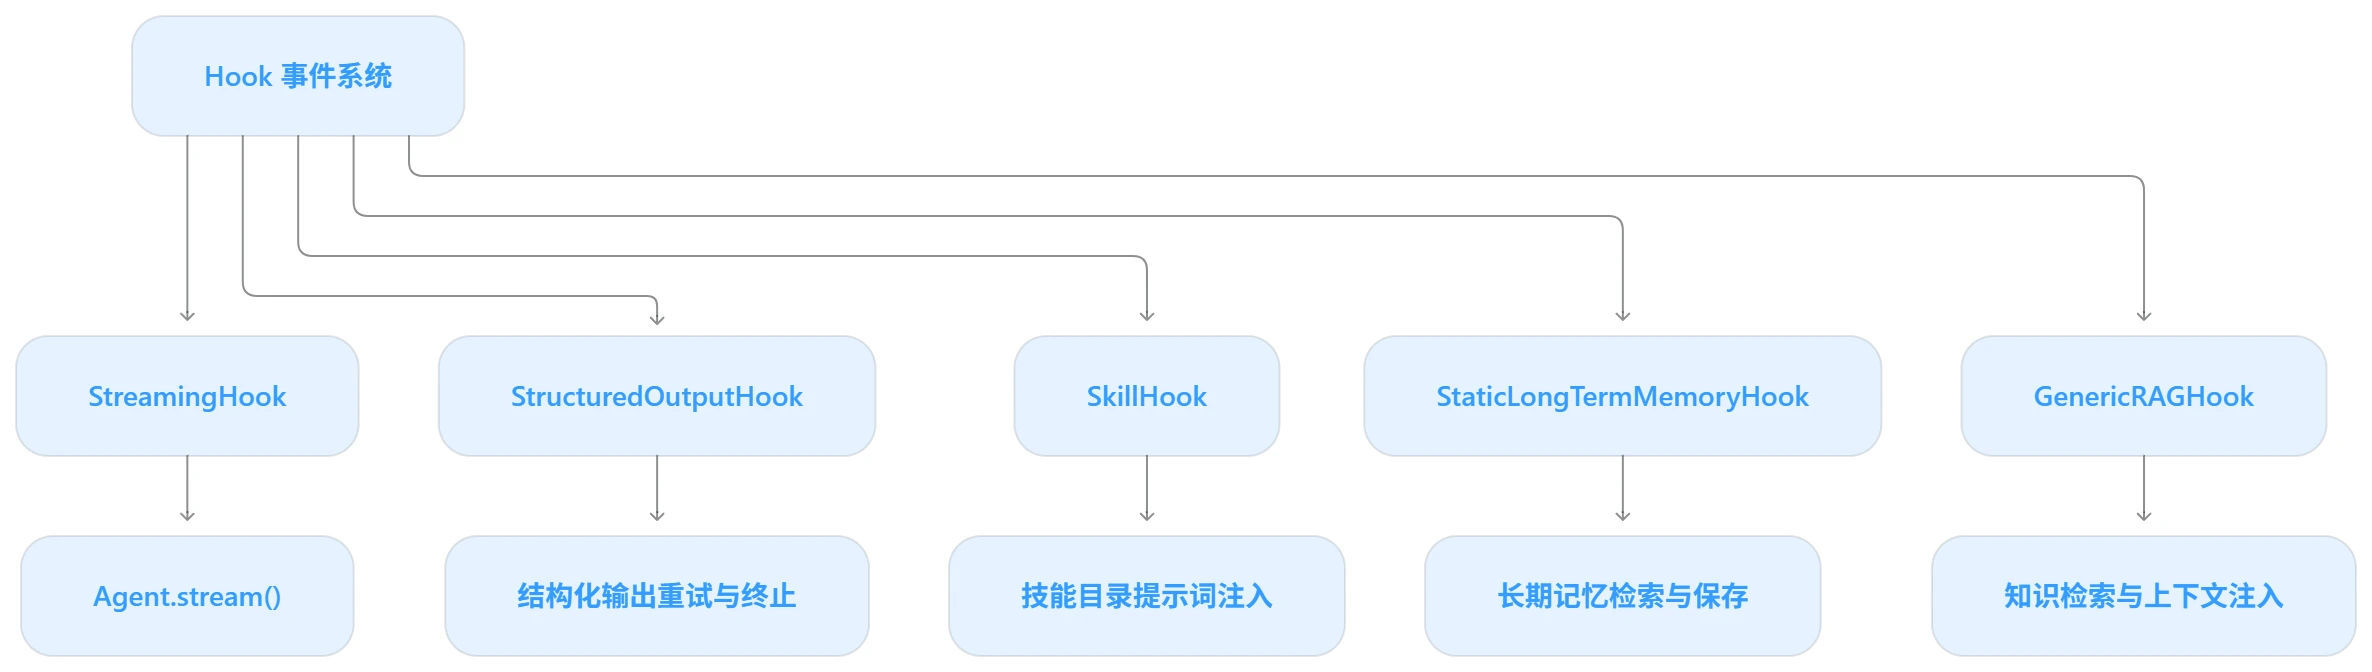
- 监听 Reasoning、Acting 和 Summary 的 Post/Chunk 事件,将内部事件推送到 FluxSink
- 具有短暂的生命周期
- agent.stream()开始,自动触发流式事件,转发事件,调用结束,移除事件
Structured
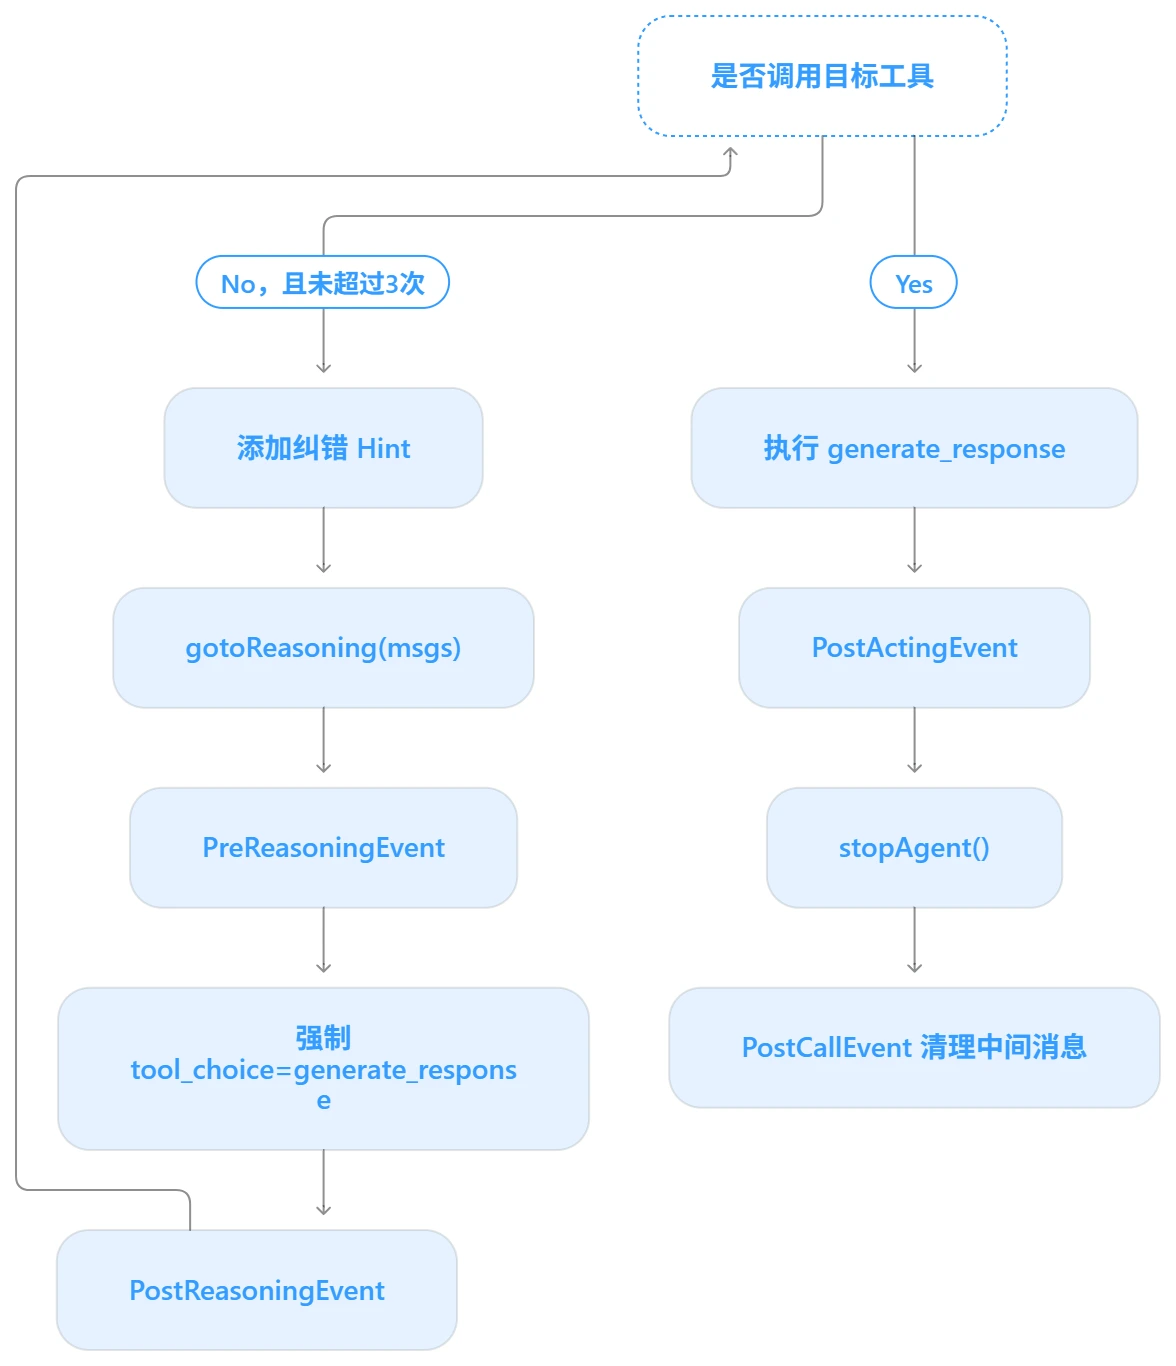
Skill
在 PreReasoningEvent阶段将技能目录注入系统提示词。这样每轮推理都可以获得当前技能信息
长期记忆
PreCallEvent:检索相关长期记忆并注入PostCallEvent:异步保存本轮对话自定义
- 实现hook接口重写onEvent方法
- 利用switch(传入的event)和case这俩个事件PreCallEvent和PostCallEvent并Lanmda内容yield Mono.just(event);
- 默认实现default -> Mono.just(event);
public class LoggingHook implements Hook {
@Override public <T extends HookEvent> Mono<T> onEvent(T event) { return switch (event) { case PreCallEvent e -> { System.out.println( "[Hook] Agent " + e.getAgent().getName() + " starting..."); yield Mono.just(event); }
case PostCallEvent e -> { System.out.println( "[Hook] Agent " + e.getAgent().getName() + " finished."); yield Mono.just(event); }
default -> Mono.just(event); }; }}工具集成
@Tool
public class SimpleTools { //工具名称及工具描述 @Tool(name = "get_time", description = "获取当前时间") public String getTime( //工具入参及描述 @ToolParam(name = "zone", description = "时区,例如:北京") String zone) { //工具的核心逻辑 return java.time.LocalDateTime.now() .format(java.time.format.DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss")); }}AgentTool
AgentTool是一个接口
public interface AgentTool {
String getName();
String getDescription();//获取工具的入参 Map<String, Object> getParameters();
default Map<String, Object> getOutputSchema() { return null; }//工具核心逻辑异步执行 Mono<ToolResultBlock> callAsync(ToolCallParam param);}实现GetParameters方法进行自定义Map工具入参
Map最终序列化为Json放入LLMApi的tools[].function.parameters按照约束生成约束
@Override public Map<String, Object> getParameters() { return Map.of( "type", "object", "properties", Map.of( "command", Map.of("type", "string", "description", "The shell command to execute") ), "required", List.of("sql") ); }- getOutputSchema()为MCP工具设计
- MCP 协议允许 server 声明工具的输出结构。框架里 McpTool 覆写了此方法来暴露 MCP server 提供的 outputSchema
区别
-
注解式由框架通过反射+@ToolParam 自动生成这个 Map
-
接口式需要你手动构造,但获得了完全的自由度,做动态 schema(比如根据运行时状态决定有哪些参数
-
Schema不确定的场景,如McpTool 的参数来自远程 MCP Server
-
没法在编译时写注解,因为参数是什么取决于对面那个进程。所以它必须自己实现 getParameters(),把远端拿到的 inputSchema 原样返回
注册工具箱
Toolkit toolkit = new Toolkit();toolkit.registerTool(new SimpleTools());
ReActAgent jarvis = ReActAgent.builder() .toolkit(toolkit) .build();工具组
- 工具太多入参较多,模型选错工具
- 把工具按功能进行分组,只有激活可见,还可以通过skill渐进式批露加载工具,
/ 创建分组(默认 active=true)toolkit.createToolGroup("file_ops", "File system operations", false); // 初始不激活toolkit.createToolGroup("math_ops", "Math calculations", false);
// 注册工具到分组toolkit.registration().tool(new FileTools()).group("file_ops").apply();toolkit.registration().tool(new MathTools()).group("math_ops").apply();
// 运行时激活/停用toolkit.updateToolGroups(List.of("file_ops"), true); // 激活toolkit.updateToolGroups(List.of("math_ops"), false); // 停用执行上下文
- @ToolParam这个模型参数,最终由模型进行决策,调用哪些工具
- 不通过模型决策则通过ToolExecutionContext,静态的数据
- 用途:注入当前用户信息、数据库连接、Session 上下文
流程
- 定义固定参数的实体类并利用builder模式ToolExecutionContext(new 对象名(属性))
- 绑定到Toolkit对象(ToolkitConfig.defaultContext(上下文))
- 框架自动注入
// 定义上下文对象public class UserContext { private String userId; private String role; // getters...}
// 注册上下文ToolExecutionContext context = ToolExecutionContext.builder() .register(new UserContext("user_123", "admin")) .build();
// 绑定到 toolkitToolkit toolkit = new Toolkit(ToolkitConfig.builder() .defaultContext(context) .build());
// 工具方法中通过类型自动注入@Tool(name = "get_profile")public String getProfile(UserContext ctx) { // ★ 框架自动注入,不在 schema 里 return "User: " + ctx.getUserId() + ", Role: " + ctx.getRole();}工具进度
@Tool(name = "analyze_data", description = "Analyze large dataset")public String analyzeData( @ToolParam(name = "dataset") String dataset, ToolEmitter emitter) { // ★ 框架自动注入,不需要 @ToolParam
emitter.emit(ToolResultBlock.text("Loading dataset...")); loadData(dataset);
emitter.emit(ToolResultBlock.text("Processing 50%...")); processHalf();
emitter.emit(ToolResultBlock.text("Processing 100%...")); processAll();
return "Analysis complete: 1000 records processed, 3 anomalies found.";}调用流程
用户消息 → ReActAgent.call() │ ├─ 1. 构造 messages + tools schema → 送模型 │ ├─ 2. 模型返回 ToolUseBlock(可能多个) │ {name: "get_weather", input: {city: "Beijing"}} │ ├─ 3. Toolkit.callTools(toolUseBlocks, config, agent, context) │ │ │ ├─ ToolExecutor.executeAll() │ │ ├─ 并行/串行分发 │ │ ├─ 每个 tool: 合并预设参数 → 注入上下文 → callAsync() │ │ ├─ 超时/重试由 ExecutionConfig 控制 │ │ └─ 返回 List<ToolResultBlock> │ │ │ └─ ToolResultBlock 回填到 memory(作为 ToolResultBlock 消息) │ ├─ 4. 继续推理(带工具结果的 messages → 模型) │ └─ 5. 模型生成最终回复 或 继续调用更多工具(循环,受 maxIters 限制)MCP接入
MCPServer
@Servicepublic class WeatherService { @Tool(name = "getWeather", description = "根据城市名称查询天气信息",returnDirect = true) public String getWeather(String city) { if (city == null) { return "请提供城市名称"; } return switch (city) { case "北京" -> "北京: 晴, 25°C"; case "上海" -> "上海: 多云, 22°C"; case "深圳" -> "深圳: 小雨, 28°C"; default -> city + ": 下雪, -20°C"; }; }}@SpringBootApplicationpublic class McpServerSseApplication {
public static void main(String[] args) { SpringApplication.run(McpServerSseApplication.class, args); }
@Bean public ToolCallbackProvider weatherTools(WeatherService weatherService) { // 自动扫描 WeatherService 中带有 @Tool 注解的方法 return MethodToolCallbackProvider.builder().toolObjects(weatherService).build(); }}ClientWrapper
AI Agent(MCP Client) ←──MCP协议──→ Tool Server(MCP Server)
- MCP Server 暴露工具列表 + 执行入口
- MCP Client 负责发现工具、生成 schema 给 LLM、调用执行
通过McpClientBuilder.create(name),他支持三种传输层
// StdIO 传输:启动子进程,通过 stdin/stdout 通信//Java 写入子进程的 stdin:发送 MCP 请求和通知。//Java 读取子进程的 stdout:接收 MCP 响应和通知这两个是通信手段//npx 启动的 MCP Server 子进程McpClientWrapper wrapper = McpClientBuilder.create("filesystem") .stdioTransport("npx", List.of("-y", "@anthropic/mcp-filesystem"))//与MCP建立通信渠道 .buildAsync() .block();
// SSE 传输:连接远程 HTTP Server 的 SSE 端点McpClientWrapper wrapper = McpClientBuilder.create("remote-tools") .sseTransport("http://localhost:8080/mcp/sse") .header("Authorization", "Bearer token123") .buildAsync() .block();
// Streamable HTTP 传输:新版 MCP 推荐的双向 HTTP 流McpClientWrapper wrapper = McpClientBuilder.create("cloud-tools") .streamableHttpTransport("https://api.example.com/mcp") .header("X-API-Key", "key123") .queryParam("version", "v2") .buildAsync() .block();buildAsync() 内部做了什么
- 根据选择的传输类型创建底层 Transport 对象
- 建立连接(StdIO = 启动子进程;SSE/HTTP = HTTP 握手)
- 发送 MCP 协议的 initialize 请求(交换 capabilities)
- 调用 tools/list 获取远端所有工具定义
- 为每个工具定义创建 McpToolDefinition 对象
- 包装为 McpClientWrapper 返回
| 传输方式 | 配置内容 | Server 如何运行 |
|---|---|---|
| StdIO | 可执行命令和参数 | 客户端启动本地子进程 |
| HTTP | URL 地址 | Server 通常已经独立启动 |
| SSE | URL 地址 | Server 通常已经独立启动 |
McpClientWrapper对MCPClient进行了封装
- 持有连接状态(transport 实例、session 信息)
- 缓存工具列表(从 tools/list 获取的 List
) - 提供工具调用入口:callTool(name, arguments) → Mono
- 生命周期管理:close() 关闭连接/杀子进程
McpClientWrapper提供了三个具体的实现
McpAsyncClientWrapper(推荐使用)
- 封装 MCP SDK 的 McpAsyncClient,所有操作返回 Reactor Mono/Flux,支持响应式异步执行。
- 不阻塞线程,适合高并发、WebFlux 应用等需要非阻塞 I/O 的场景
McpSyncClientWrapper
- 封装 MCP SDK 的 McpSyncClient,所有操作阻塞式执行。
- 适合简单场景、命令行工具、批处理任务等不需要高并发的场景
HigressMcpClientWrapper
- 专门用于对接 Higress AI 网关 的 MCP 客户端实现。
- 工具治理(鉴权、限流、路由、可观测)下沉到网关层,Agent 只负责调用
MCP工具
Toolkit.registerMcpClient() 方法,用来注册MCP工具
Toolkit toolkit = new Toolkit();
// 注册 MCP 服务器的所有工具toolkit.registerMcpClient(mcpClient).block();无论本地还是远端,模型看到的是统一的 tools 列表
McpTool
MCPTool实现了AgentTool接口,McpTool单独实现了getOutputSchema这个方法
远端获取工具参数,将MCP当作Tool的形式
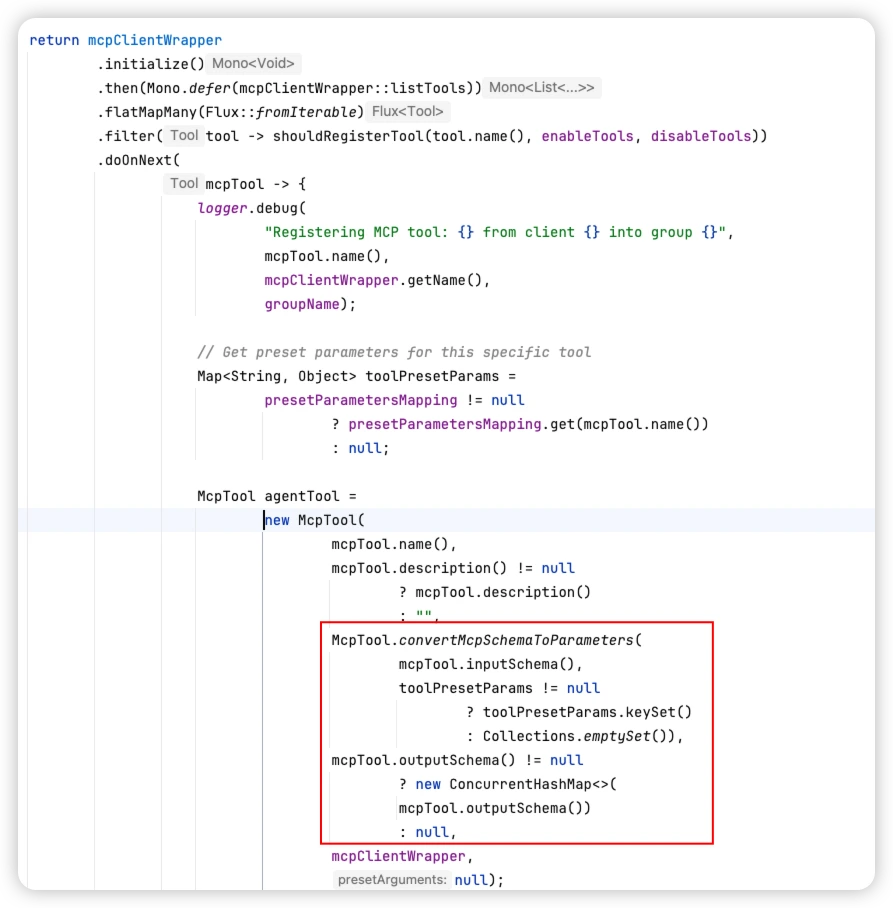
// 前置条件:先启动 mcp-server-sse 模块(端口 8003),提供天气查询工具 getWeather。
* 本示例通过 AgentScope 的 McpClientBuilder 以 SSE 方式连接到 MCP Server, * 然后注册其暴露的工具(getWeather),让 ReActAgent 能够自动调用该工具来回答天气相关问题。 */public class McpClientDemo {
public static void main(String[] args) { String apiKey = ""; // 1. 通过 SSE 传输方式连接到 MCP Server(mcp-server-sse 模块,端口 8003) McpClientWrapper mcpClient = McpClientBuilder.create("weather-mcp") .sseTransport("http://127.0.0.1:8003/sse") .timeout(Duration.ofSeconds(30)) .buildAsync() .block();
System.out.println("✅ 已成功连接到 MCP Server (SSE)");
// 2. 创建 Toolkit 并注册 MCP 客户端中的所有工具 Toolkit toolkit = new Toolkit(); toolkit.registerMcpClient(mcpClient).block();
// 打印已注册的工具 System.out.println("📦 已注册的工具列表: " + toolkit.getToolNames());
// 3. 创建 ReActAgent,配置模型与工具 ReActAgent agent = ReActAgent.builder() .name("WeatherAssistant") .sysPrompt("你是一个天气助手,可以帮用户查询各个城市的天气信息。请使用工具来获取天气数据。") .model(DashScopeChatModel.builder() .apiKey(apiKey) .modelName("qwen-max") .build()) .toolkit(toolkit) .memory(new InMemoryMemory()) .build();
// 4. 发送消息,让 Agent 调用 MCP 工具查询天气 System.out.println("\n--- 第1轮对话 ---"); Msg msg1 = Msg.builder() .textContent("北京今天天气怎么样?") .build(); Msg reply1 = agent.call(msg1).block(); System.out.println("用户: 北京今天天气怎么样?"); System.out.println("Agent: " + reply1.getTextContent());
// 第2轮对话 - 查询另一个城市 System.out.println("\n--- 第2轮对话 ---"); Msg msg2 = Msg.builder() .textContent("深圳呢?") .build(); Msg reply2 = agent.call(msg2).block(); System.out.println("用户: 深圳呢?"); System.out.println("Agent: " + reply2.getTextContent());
// 5. 清理资源 toolkit.removeMcpClient("weather-mcp").block(); System.out.println("\n🔌 已断开 MCP 连接"); }}RAG
Document
public class Document {
private final String id; private final DocumentMetadata metadata; private double[] embedding; private Double score; private String vectorName;}- Document 用来表示在RAG系统的每一个chunk
- DocumentMetadata 内部装的是一个 ContentBlock
- 让”文本块”和”图片块”共用一条 RAG 管线
Knowledge
AgentScope定义了三个接口(KnowLedge/Document/RetrieveConfig),相当于知识库接口
public interface Knowledge {
Mono<Void> addDocuments(List<Document> documents);
Mono<List<Document>> retrieve(String query, RetrieveConfig config);}- 这个接口有很多是实现类SimpleKnowledge 换成 BailianKnowledge、DifyKnowledg
- 将实现类对象以多态的形式塞进ReactAgent中即可运行
Retrieve
RetrieveConfig 用来配置检索参数
RetrieveConfig.builder() .limit(5) // top-k,默认 5 .scoreThreshold(0.5) // 相似度阈值,默认 0.5 .vectorName("doc_v1") // 向量空间名(可选,用于隔离不同 corpus) .conversationHistory(history) // 多轮上下文(百炼会用它做 query rewrite) .build();插入模式
Generic
检索知识库的时机是由谁决定
| 模式 | 触发方 | 注入位置 | 适合场景 |
|---|---|---|---|
| GENERIC | 框架(每次推理前自动) | 在 inputMessages 末尾追加 user 消息 | FAQ / 知识助手,每条用户提问都需要检索 |
| AGENTIC | LLM 自主决策 | 作为 retrieve_knowledge 工具结果回灌 | 多技能 Agent,RAG 是诸多工具之一 |
| NONE | — | — | 关闭 RAG |
private Mono<PreCallEvent> handlePreCall(PreCallEvent event) {//获取用户信息 String query = extractQueryFromMessages(event.getInputMessages()); if (query == null || query.isBlank()) return Mono.just(event);//利用用户信息去检索知识库 return knowledge.retrieve(query, defaultConfig) .flatMap(docs -> { if (docs.isEmpty()) return Mono.just(event); List<Msg> enhanced = new ArrayList<>(event.getInputMessages()); enhanced.add(buildKnowledgeUserMsg(docs)); // 追加到末尾 event.setInputMessages(enhanced); return Mono.just(event); }) .onErrorResume(err -> { log.warn("Generic RAG retrieval failed: {}", err.getMessage()); return Mono.just(event); // ← 失败兜底,不打断主流程 });}- 用户发送信息,获取到信息
- 用信息去Knowledge知识库检索相关文档
- 检索到的内容添加到用户信息之前
- Agent 处理增强后的消息并响应
Agentic
让Agent来决策什么时候该调用RAG做检索,知识库检索封装成一个普通工具
定义工具名称及其描述@Tool( name = "retrieve_knowledge", description = "Retrieve relevant documents from knowledge base. Use this tool when you need" + " to find specific information or when user asks questions about stored" + " knowledge.")public String retrieveKnowledge( // 定义工具入参及其描述 @ToolParam( name = "query", description = "The search query to find relevant documents in the knowledge" + " base") String query, @ToolParam( name = "limit", description = "Maximum number of documents to retrieve (default: 5)", required = false) Integer limit,
//Agent由框架自动注入 Agent agent) {
// 设置retrevieConfig的limit默认值 if (limit == null) { limit = 5; }
// 根据上下文判断是否为ReactAgent,如果是获取记忆添加到上下文 List<Msg> conversationHistory = null; if (agent instanceof ReActAgent reActAgent) { conversationHistory = reActAgent.getMemory().getMessages(); }
//设置根据上下文构建检索参数配置 RetrieveConfig config = this.defaultConfig .mutate() .limit(limit) //Top-k参数 .conversationHistory(conversationHistory) //上下文 .build(); //检索知识库KonwLedge return knowledge .retrieve(query, config) .map(this::formatDocumentsForTool) //格式化文档 .onErrorReturn("Failed to retrieve knowledge for query: " + query)
.block();//等待同步转换结果knowledge.retrieve() 返回的是响应式异步对象,而 Tool 接口要求返回普通 String}用户发送问题 │ ▼Agent 第一次推理 │ ├── 不需要知识库 │ └── 直接生成答案 │ └── 需要知识库 │ ▼调用 retrieve_knowledge自定义工具 │ ▼ Agent agent agent 没有标注 @ToolParam框架执行工具时自动注入当前 Agent │ ▼读取 Agent 会话历史 │ ▼构造 RetrieveConfig
defaultConfig │ ▼mutate() │ ├── 覆盖 limit ├── 加入 conversationHistory ▼build() │ ▼本次检索专用 RetrieveConfig
调用 Knowledge.retrieve() │ ▼文档格式化为工具结果 │ ▼工具结果回灌 Agent │ ▼Agent 第二次推理并生成最终答案- 用户发送查询
- Agent 推理并决定是否检索知识
- 如果需要,Agent 调用
retrieve_knowledge(query="...") - 检索到的文档作为工具结果返回
- Agent 使用检索到的信息再次推理
Hook和工具,是在ReActAgent构造的时候,自动配置进去的
聚合知识库
- 只有一个知识库:直接使用。
- 有多个知识库:通过
buildAggregatedKnowledge()聚合
if (knowledgeBases.size() == 1) { aggregatedKnowledge = knowledgeBases.iterator().next();} else { aggregatedKnowledge = buildAggregatedKnowledge();}io.agentscope.core.ReActAgent.Builder#configureRAG
ReActAgent.Builder 构建 Agent │ ▼configureRAG(agentToolkit) │ ├── GENERIC │ └── 注册 GenericRAGHook │ ├── AGENTIC │ └── 注册 KnowledgeRetrievalTools │ └── 暴露 retrieve_knowledge 工具 │ └── NONE └── 不配置任何 RAG 能力
switch (ragMode) { case GENERIC -> { GenericRAGHook ragHook = new GenericRAGHook(aggregatedKnowledge, retrieveConfig); hooks.add(ragHook); } case AGENTIC -> { KnowledgeRetrievalTools tools = new KnowledgeRetrievalTools(aggregatedKnowledge, retrieveConfig); agentToolkit.registerTool(tools); } case NONE -> { // Do nothing }}文档处理
<dependency> <groupId>com.alibaba</groupId> <artifactId>dashscope-sdk-java</artifactId> <version>2.22.9</version> <exclusions> <exclusion> <groupId>org.slf4j</groupId> <artifactId>slf4j-simple</artifactId> </exclusion> <exclusion> <groupId>org.projectlombok</groupId> <artifactId>lombok</artifactId> </exclusion> </exclusions></dependency>
<dependency> <groupId>com.aliyun</groupId> <artifactId>bailian20231229</artifactId> <version>2.13.1</version></dependency>public class LocalRagDemo { public static void main(String[] args) throws IOException { String apiKey = "sk-xxxxxxx";
// 1. 起 Embedding + 内存向量库 EmbeddingModel embed = DashScopeTextEmbedding.builder() .apiKey(apiKey).modelName("text-embedding-v3").dimensions(1024).build(); //向量数据库 InMemoryStore store = InMemoryStore.builder().dimensions(1024).build(); //知识库 SimpleKnowledge knowledge = SimpleKnowledge.builder() .embeddingModel(embed).embeddingStore(store).build();
// 2. 灌数据(PDF) PDFReader reader = new PDFReader(); File file = new File("/Users/hollis/LLM课程视频/RAG材料/Java八股文介绍.pdf"); List<Document> docs = reader.read(ReaderInput.fromPath("/Users/hollis/LLM课程视频/RAG材料/Java八股文介绍.pdf")).block(); //添加到知识库 knowledge.addDocuments(docs).block();
// 3. 起 Agent,自动注入 ReActAgent agent = ReActAgent.builder() .name("FAQBot") .sysPrompt("基于检索到的知识回答用户问题;若没找到请明确告知。") .model(DashScopeChatModel.builder() .apiKey(apiKey) .modelName("qwen-max") .build()) .knowledge(knowledge) .ragMode(RAGMode.GENERIC) // 关键:自动 Hook .build();
Msg msg = Msg.builder() .role(MsgRole.USER) .content(TextBlock.builder().text("这份JAVA八股文有哪些内容?").build()) .build(); System.out.println(agent.call(msg).block().getTextContent()); }}-
SimpleKnowledge里封装了向量化和向量入库的能力
-
利用Reader读取文档放入里面就可以向量存储了,这个Knowledge对外提供能力
PDFReader` 继承自 AbstractChunkingReader,读取文件时会把内容切分成多个 Document
未切分时:一个完整文件 → 一个 Document
切分后:一个文件 → 多个 Document 每个 Document 对应一个 Chunk多知识库
ReActAgent agent = ReActAgent.builder() .knowledge(productDocsKB) .knowledge(faqKB) .knowledge(internalWikiKB) // 框架自动 buildAggregatedKnowledge .ragMode(RAGMode.GENERIC) .build();会触发ReActAgent.Builder中的buildAggregatedKnowledge做多路检索和合并、重排
Skill
数据模型
先告诉 LLM“有哪些技能”,等 LLM 判断需要某个 Skill 时,再通过 load_skill_through_path 动态加载并激活
- 技能目录预注入
- 技能内容按需加载
- 关联工具延迟开放、
- 代码受控执行
| 字段 | 作用 |
|---|---|
name | Skill 名称 |
description | 告诉 LLM 何时应该选择该 Skill |
skillContent | SKILL.md 的核心指令内容 |
metadata | 名称、描述以及其他扩展信息 |
resources | Skill 附带的脚本、模板、参考资料/ |
source | Skill 来源,如 filesystem、git、mysql、nacos |
AgentSkill skill = new AgentSkill( "my-skill", "Does something useful", "Detailed instructions here...", Map.of("scripts/run.py", "print('hello')"));
//通过BuilderAgentSkill skill = AgentSkill.builder() .name("my-skill") .description("Does something useful") .skillContent("Instructions here...") .addResource("scripts/run.py", "print('hello')") .build();
//持久化存储中加载 //AgentScope 提供了 Repository 模式来从不同来源加载 Skill,接口为 AgentSkillRepository public interface AgentSkillRepository extends AutoCloseable { AgentSkill getSkill(String name); List<String> getAllSkillNames(); List<AgentSkill> getAllSkills(); boolean save(List<AgentSkill> skills, boolean force); boolean delete(String skillName); boolean skillExists(String skillName); String getSource();}加载获取到AgentSkill类
SkillBox
- 注册管理:保存 Agent 当前可用的 Skill
- 提示词生成:生成
<available_skills>XML 目录 - 状态管理:控制 Skill 的激活和停用
- 能力管理:启停关联工具组、上传资源、配置执行环境
Toolkit toolkit = new Toolkit();SkillBox skillBox = new SkillBox(toolkit);
// 1. 加载并注册 SkillAgentSkill skill = loadSkillFromSomewhere();skillBox.registerSkill(skill);
// 2. 注册 Skill 加载工具(让 Agent 能动态加载 Skill)skillBox.registerSkillLoadTool();
// 3. 将 SkillBox 绑定到 AgentReActAgent agent = ReActAgent.builder() .name("Assistant") .model(model) .toolkit(toolkit) .skillBox(skillBox) .build();AgentSkillRepository │ │ 加载 ▼ AgentSkill │ │ registerSkill() ▼ SkillBox │ ├── 生成 Skill 目录提示词 ├── 注册 Skill 加载工具 ├── 管理 Skill 激活状态 ├── 管理关联 ToolGroup └── 管理脚本执行环境沙箱:SkillBox 提供了强大的代码执行配置能力,允许 Skill 中的脚本在受控环境中运行。
skillBox.codeExecution() .workDir("/path/to/workdir") // 工作目录(不设置则创建临时目录) .withShell() // 启用默认 Shell(python, python3, node, nodejs) .withRead() // 启用文件读取 .withWrite() // 启用文件写入 .enable();注入工具
在 build() 阶段,configureSkillBox()自动完成初始化
- 把 SkillBox 绑定到当前 Toolkit
- 由 SkillToolFactory.createSkillAccessToolAgentTool() 创建注册AgentTool的 load_skill_through_path
- 暴露关联工具——激活后,该 Skill 绑定的工具组才对 LLM 可见
- 注册 SkillHook,用于注入 Skill 提示词
注入提示词
- 在SkillHook中,在PreReasoningEvent阶段会讲将skill提示词注入到系统提示词中
- 注册之后的提示词在AgentSkillPromptProvider 中能看到LLM决定调用哪个工具
- load_skill_through_path根据skillID动态加载Skill.md并激活交给LLM
1. Agent 初始化 └── configureSkillBox() 注册 load_skill_through_path 到 Toolkit
2. 每次用户调用 agent.call() └── SkillHook.onEvent(PreReasoningEvent) └── 将可用 Skill 列表注入 System Message └── LLM 看到 <available_skills> XML 提示
3. LLM 决定使用某个 Skill └── 调用 load_skill_through_path(skillId="...", path="SKILL.md") └── Skill 被激活 └── 关联工具组被启用 └── 返回 SKILL.md 内容给 LLM
4. LLM 阅读 Skill 内容后 └── 调用该 Skill 暴露的工具(或执行脚本)人工确认
思考之后
·Human-in-Loop允许在 Agent 执行过程中暂停、人工审查、交互确认后继续执行的机制
模型想调 delete_file,我希望先弹出 “确认/取消”
//ReactAgent中reasoning和acting中间的代码块
.flatMap(this::notifyPostReasoning) //执行所有PostReasoning的Hook.flatMap(event -> { Msg msg = event.getReasoningMessage(); if (msg != null) memory.addMessage(msg); // ① 先把推理结果写进 memory
//PostReasoningEvent返回stopRequested字段,并进行判断,HITL中断 if (event.isStopRequested()) { // ② 检查暂停标志 return Mono.just(msg.withGenerateReason( GenerateReason.REASONING_STOP_REQUESTED)); // ③ 直接返回,不进 acting }- PostReasoningEvent里面有个StopAgent方法将stopRequested字段设置为true
- 定义一个hook去监听这个PostReasoningEvent
//定义一个hook去监听PostReasoningEventHook confirmationHook = new Hook() { //定义一个敏感工具列表 private static final List<String> SENSITIVE_TOOLS = List.of("delete_file", "send_email");
@Override public <T extends HookEvent> Mono<T> onEvent(T event) { if (event instanceof PostReasoningEvent e) { Msg reasoningMsg = e.getReasoningMessage(); List<ToolUseBlock> toolCalls = reasoningMsg.getContentBlocks(ToolUseBlock.class);
// 如果包含敏感工具,暂停等待确认 boolean hasSensitive = toolCalls.stream() .anyMatch(t -> SENSITIVE_TOOLS.contains(t.getName()));
if (hasSensitive) { e.stopAgent(); } } return Mono.just(event); }};
ReActAgent agent = ReActAgent.builder() .name("Assistant") .model(model) .toolkit(toolkit) .hook(confirmationHook) .build();触发了HIL用户拿到的 Msg 里一定带着 ToolUseBlock(还没执行),所以判断条件就是它。如果用户同意,则继续执行,否则提示失败。
Msg resp = agent.call(userMsg).block();
while (resp.hasContentBlocks(ToolUseBlock.class)) { showPendingToUser(resp); if (userClickYes()) { resp = agent.call().block(); // 无参 → 继续跑 acting } else { resp = agent.call(buildCancelMsg(resp)).block(); // 注入伪 result }}- 如果想要继续执行,会执行到acting方法中,而这个方法的第一句就是获取pending的ToolUseBlock,然后把他执行完,pending指的是正在排队,还没有搞定
- ToolUseBlock模型生成的工具参数进行了封装,里面有id,name,模型不同生成json不同中input,state
private Mono<Msg> acting(int iter) { // Extract only pending tool calls (those without results in memory) List<ToolUseBlock> pendingToolCalls = extractPendingToolCalls();}行动之后
生成了一封邮件草稿,让人看完再决定要不要发下一步动作,Event是PostActingEvent
return Flux.fromIterable(successPairs) .concatMap(this::notifyPostActingHook) // 串行通知每个工具的 PostActing .last() // 取最后一个事件 .flatMap(event -> { if (event.isStopRequested()) { return Mono.just(event.getToolResultMsg() .withGenerateReason(GenerateReason.ACTING_STOP_REQUESTED)); } ... });如果应用层忘了恢复怎么办?
- 暂停后用户直接刷新页面
- 新一轮发了一条普通问题进来
这时 memory 里还有”悬空的 ToolUseBlock”,下一轮 reasoning 一进 LLM 就会报错。
PendingToolRecoveryHook(priority=10,最先跑)
private Mono<PreCallEvent> handlePreCall(PreCallEvent event) { Set<String> pendingIds = findPendingToolUseIds(memory); if (pendingIds.isEmpty()) return Mono.just(event);
List<Msg> input = event.getInputMessages();
// ① 输入为空 = 用户在用 agent.call() 恢复 → 不要管 if (input == null || input.isEmpty()) return Mono.just(event);
// ② 输入里已经有 ToolResult = 应用层自己处理过 → 不要管 if (input.stream().anyMatch(m -> m.hasContentBlocks(ToolResultBlock.class))) return Mono.just(event);
// ③ 否则注入合成 error result,避免崩溃 patchPendingToolCalls(reactAgent, memory, pendingIds); return Mono.just(event);}Demo
public class HitlDemo {
public static class Tools { @Tool(name = "delete_file", description = "Delete a file") public String del(@ToolParam(name = "filename") String f) { return "deleted " + f; } @Tool(name = "search_web", description = "Search the web") public String search(@ToolParam(name = "q") String q) { return "results for " + q; } }
static class ConfirmHook implements Hook { static final List<String> SENSITIVE = List.of("delete_file"); @Override public <T extends HookEvent> Mono<T> onEvent(T e) { if (e instanceof PostReasoningEvent p) { boolean dangerous = p.getReasoningMessage() .getContentBlocks(ToolUseBlock.class).stream() .anyMatch(t -> SENSITIVE.contains(t.getName())); if (dangerous) p.stopAgent(); } return Mono.just(e); } }
public static void main(String[] args) { Toolkit toolkit = new Toolkit(); toolkit.registerTool(new Tools());
ReActAgent agent = ReActAgent.builder() .name("SafeAgent") .model(DashScopeChatModel.builder() .apiKey(System.getenv("DASHSCOPE_API_KEY")) .modelName("qwen-plus").stream(true) .formatter(new DashScopeChatFormatter()).build()) .toolkit(toolkit) .memory(new InMemoryMemory()) .hook(new ConfirmHook()) .build();
Scanner sc = new Scanner(System.in); while (true) { System.out.print("You: "); Msg userMsg = Msg.builder().role(MsgRole.USER) .content(TextBlock.builder().text(sc.nextLine()).build()).build(); Msg resp = agent.call(userMsg).block();
while (resp != null && resp.hasContentBlocks(ToolUseBlock.class)) { System.out.println("⚠ Pending tools: " + resp.getContentBlocks(ToolUseBlock.class)); System.out.print("Confirm? (y/n): "); if (sc.nextLine().equalsIgnoreCase("y")) { resp = agent.call().block(); // 无参恢复 } else { List<ToolResultBlock> cancel = resp.getContentBlocks(ToolUseBlock.class).stream() .map(t -> ToolResultBlock.of(t.getId(), t.getName(), TextBlock.builder().text("Cancelled").build())) .toList(); Msg cancelMsg = Msg.builder().role(MsgRole.TOOL) .content(cancel.toArray(new ToolResultBlock[0])).build(); resp = agent.call(cancelMsg).block(); } } System.out.println("Agent: " + resp.getTextContent()); } }}工具挂起
- ToolSuspendException不是用来报告工具失败的,
- 把工具执行从 Agent 内部转移到外部系统,并通过结构化的挂起结果和真实 ToolResult 完成一次可恢复的 Agent 执行流程
用户消息 ↓ReActAgent 推理 ↓LLM 生成 tool_use ↓ToolExecutor 执行工具 ↓工具抛出 ToolSuspendException ↓ToolExecutor 捕获异常 ↓转换为 suspended ToolResultBlock ↓ReActAgent 区分成功结果和挂起结果 ↓返回 GenerateReason.TOOL_SUSPENDED ↓外部系统执行真实工具 ↓外部系统构造 TOOL 消息写回 Agent ↓再次调用 Agent ↓Agent 从内存中读取工具真实结果 ↓继续后续推理@Tool(name = "external_api", description = "调用外部 API")public ToolResultBlock callExternalApi( @ToolParam(name = "url") String url) {
throw new ToolSuspendException( "等待外部 API 响应: " + url );}工具实际上没有完成外部 API 调用,而是通过异常告诉框架
ToolExecutor` 是整个机制中最关键的适配层
- 按照 LLM 生成的
ToolUseBlock调用对应的工具函数 - 工具主动挂起,只有
ToolSuspendException被转换为挂起结果
throw new ToolSuspendException( "等待外部 API 响应");- ToolResultBlock.suspended(…)` 通常会生成类似这样的工具结果
封装成Agent 消息流中的一部分,而不是一个无法处理的异常
{ "toolCallId": "call_001", "name": "external_api", "content": "等待外部 API 响应: https://example.com", "metadata": { "agentscope_suspended": true }}异常 ↓结构化工具结果 ↓带有 suspended 元数据ReActAgent.acting() 中的结果分流
工具执行结果 ├── successPairs:ToolUseBlock + 正常 ToolResultBlock写入 Agent 内存,并继续下一轮 ReAct └── pendingPairs:被 ToolSuspendException 中断的工具调用 ToolUseBlock + suspended ToolResultBlock-
- 将挂起信息写入返回消息,
-
设置:GenerateReason.TOOL_SUSPENDED
-
Agent 返回挂起状态,停止当前 ReAct 循环;将控制权返回给调用方
外部系统如何接管工具执行
调用方拿到挂起响应后,需要读取其中的 ToolUseBlock
Msg response = agent.call(userMsg).block();
if (response.getGenerateReason() == GenerateReason.TOOL_SUSPENDED) {
List<ToolUseBlock> pendingTools = response.getContentBlocks(ToolUseBlock.class);
for (ToolUseBlock toolUse : pendingTools) { // 外部系统执行真实工具 }}Agent恢复执行
- 恢复执行的本质<恢复执行不是重新执行原始的> tool_use,而是把真实工具结果作为一条 TOOL 消息写回 Agent
Msg finalResponse = agent.call(toolResult).block();- 外部系统必须使用原始工具调用的 ID 写回结果
toolResult.toolCallId == toolUse.idextractPendingToolCalls()方法的作用
此时内存中的信息有什么?挂起状态不能只保存在内存中。实际系统通常需要保存
原始 ToolUseBlock挂起的 ToolResultBlock外部写入的真实 ToolResultBlockextractPendingToolCalls() 的目的就是避免重复执行已经完成的工具调用
读取当前消息中的所有 ToolUseBlock ↓检查每个 toolCallId 是否已有真实 ToolResultBlock ↓已完成:跳过未完成:继续执行计划执行
Agent2.0
微调
Harness工程
Loop工程
RAG评测
Agent评测
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!